Evergine 中的缓冲区视图
图形引擎中的每一项改进,并非都会立即转化为一眼就能看到的新视觉效果或功能。有些改进更多地与引擎架构本身、内部资源管理方式以及引擎如何在不增加系统复杂性的前提下持续演进有关。
在 Evergine 中引入缓冲区视图正是此类改进之一。
这项新功能旨在提供对 GPU 数据更灵活的访问方式,允许同一缓冲区以不同方式复用,而无需复制内存或创建额外资源。虽然这听起来像是一个底层技术细节,但它对渲染、计算工作流以及引擎未来的演进影响深远。
将存储与访问分离
现代图形管线中一个常见的挑战是,同一组 GPU 数据往往需要根据着色器、管线阶段或使用它的系统,以不同方式被消费。
传统上,这通常导致效率较低的解决方案:为每种用例创建专用缓冲区、生成中间副本,或将物理内存布局与数据后续的消费方式紧密耦合。所有这些都增加了内存使用量、复杂性和维护开销。
缓冲区视图引入了一种更为灵活的方法。
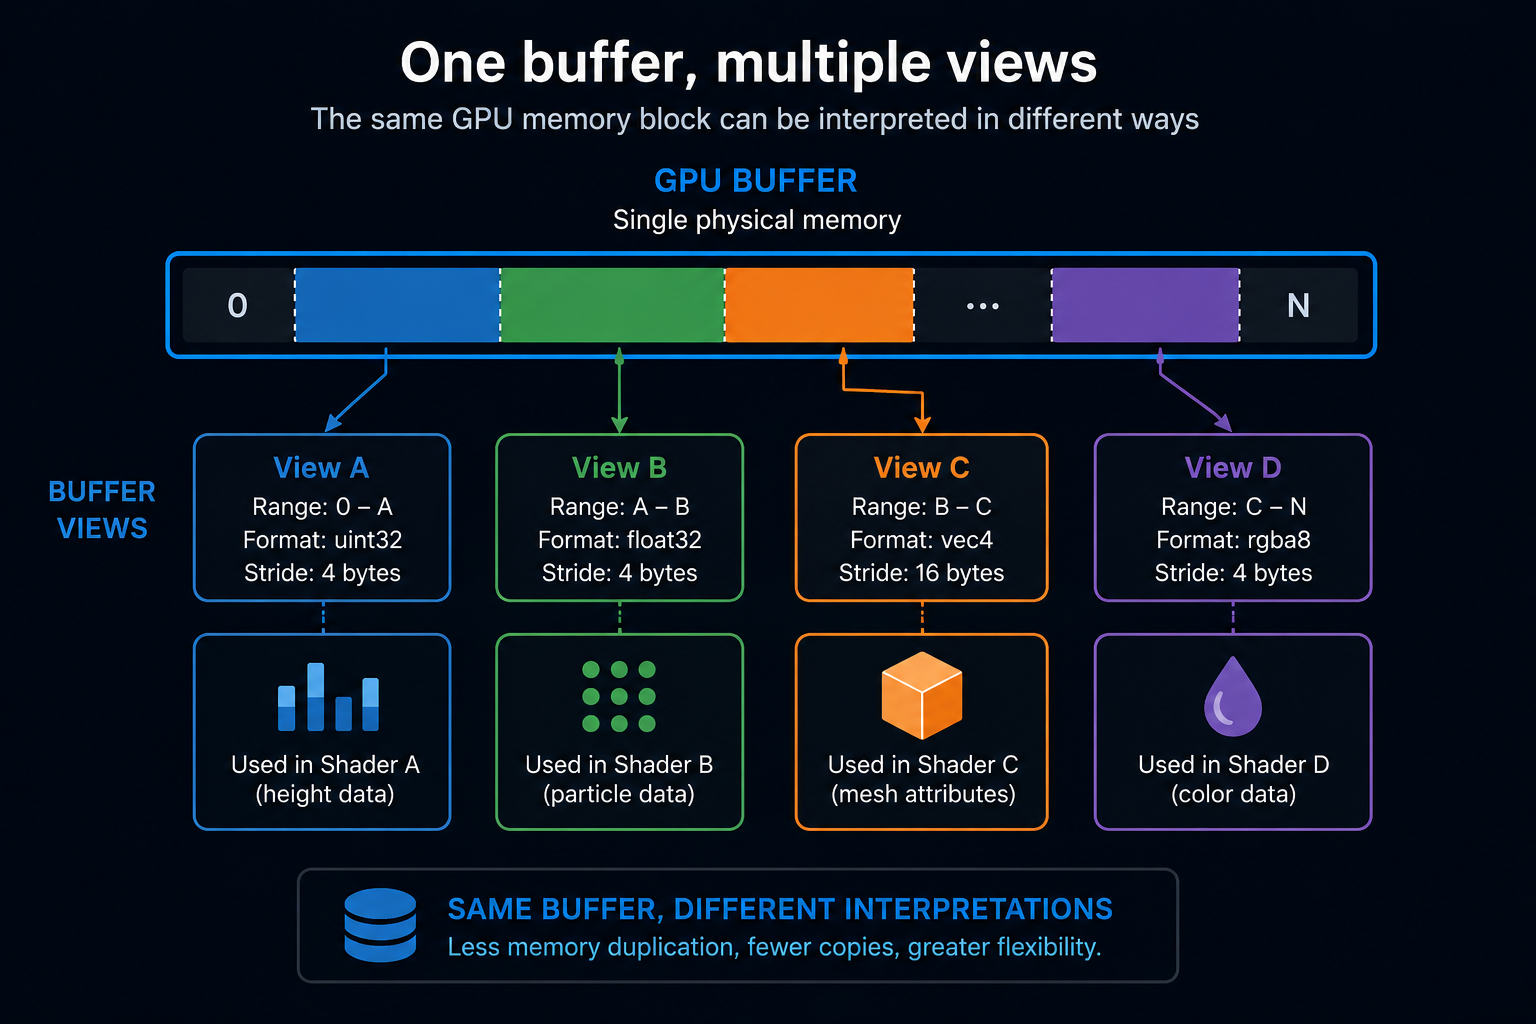
现在,无需直接操作整个缓冲区,即可创建指向该缓冲区特定区域的视图,同时定义从着色器端应如何解释这些字节。换言之,物理存储保持不变,但数据的访问方式可根据上下文而变化。
简单来说,同一块 GPU 内存现在可以以多种方式复用,而无需复制资源。
Evergine 中的原生集成
缓冲区视图的实现并非作为一个孤立的功能来设计,而是作为 Evergine 资源系统中一项完全集成的改进。
引擎内部现在包含一个通用抽象层,用于定义缓冲区视图,包括对偏移量、大小、格式和步长定义的一致性校验。这确保了无论使用何种图形后端,每个视图都保持有效且一致。
ResourceFactory 也已扩展,支持通过统一且富有表现力的 API 来创建缓冲区视图。从基础缓冲区开始,开发者可以根据每个着色器或管线的需求,定义子范围、类型化格式或结构化布局。
此外,绑定系统和 ResourceSet 也已更新,可直接与这些视图配合使用,为只读和读写访问引入了特定的资源类型(TexelBuffer 和 TexelBufferReadWrite)。
所有这些都与引擎现有的 GPU 状态和屏障管理系统无缝集成。
此功能已在 Evergine 支持的所有主流图形后端上实现,包括 DirectX 11、DirectX 12、Metal、OpenGL、Vulkan 和 WebGPU。这确保了无论目标平台或图形 API 如何,行为都保持一致,这对于多平台项目和可移植性至关重要的工业环境尤为重要。
一个实际示例
为了验证实现,我们还在内部底层图形测试中添加了一个新示例。
该示例在单个 GPU 缓冲区中生成 64 个随机的 32 位值。从同一内存块中,创建了两个不同的缓冲区视图:一个将数据解释为 uint32 值,而另一个将完全相同的字节重用为 rgba8 颜色。
结果是一个垂直条形的可视化效果,其中一个视图控制每个条形的高度,而另一个定义其颜色,所有这些都重用了完全相同的物理缓冲区。
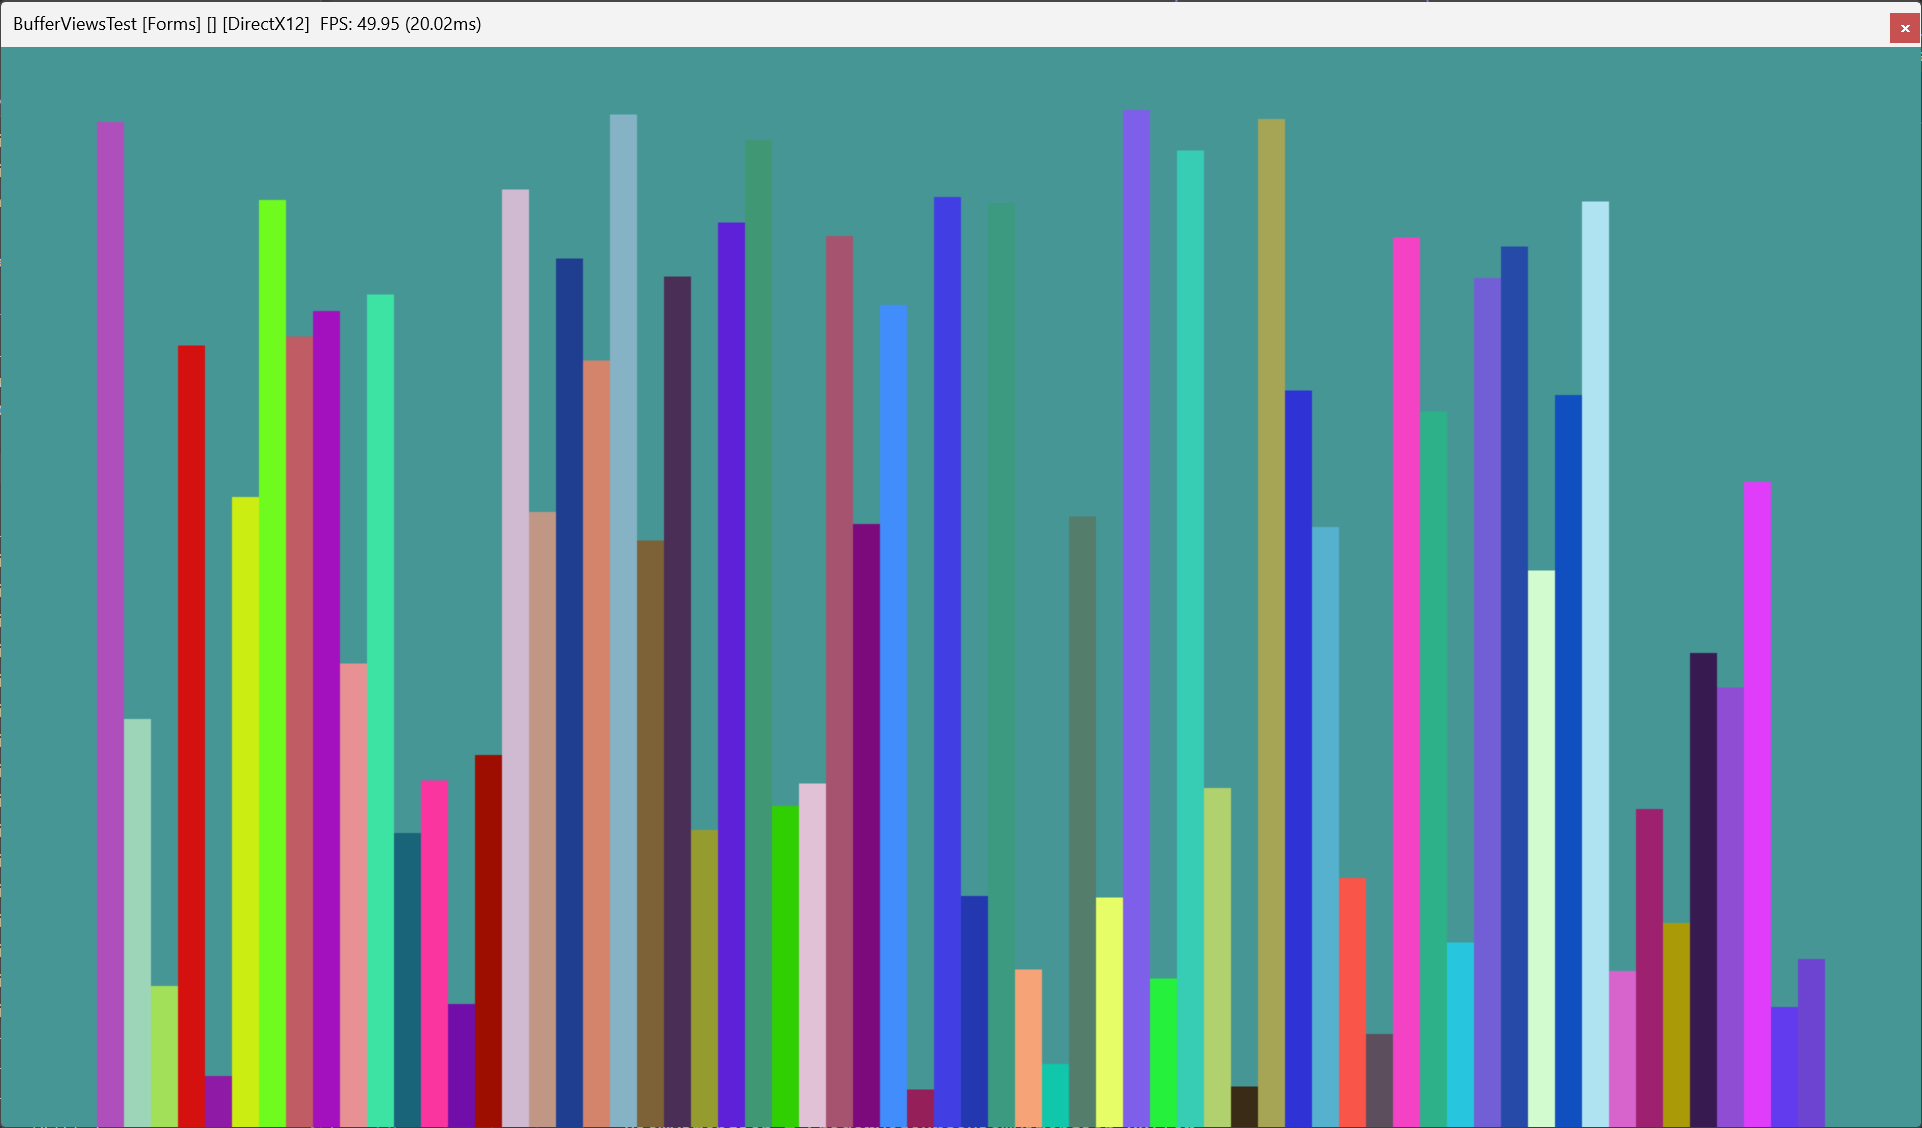
这是一个简单的示例,但它完美地说明了缓冲区视图的主要目的:将数据存储与数据解释完全分离。
除了减少不必要的重复之外,这种方法还使得构建渲染和计算系统高效共享相同数据的管线变得更加容易。
为现代管线提供更多灵活性
缓冲区视图的主要价值在于它们在构建现代渲染和计算管线时提供的灵活性。
现在,跨不同系统重用大型共享缓冲区、处理特定子范围或根据每个管线阶段的确切需求重新解释数据都变得更加容易。
这不仅减少了资源重复,还降低了内存压力,并消除了许多以前需要重新组织数据的中间复制操作。
从开发角度来看,这也简化了未来图形功能的演进。更改着色器使用信息的方式,不再必然需要重新设计与之关联的整个内存布局。
其结果是架构更清晰、更易于维护,并为持续演进做好了更充分的准备。
面向未来设计的功能
尽管Buffer Views主要是一项内部改进,但它很好地体现了我们在Evergine中持续追求的那种演进方向:为现代图形管线构建一个更灵活、高效且面向未来的技术基础。
许多先进的渲染技术越来越依赖于在渲染和计算阶段之间高效地共享数据。将存储与访问分离是朝这个方向迈出的关键一步,它减少了技术摩擦,同时为开发者提供了更具表现力的 API。
最终,缓冲区视图不仅仅是另一个功能。它们是一种结构性的改进,强化了引擎架构,并为 Evergine 内部的优化和资源重用开辟了新的可能性。