对话式 AI 虚拟人研究:LLM 与 Audio2Face 对比
在 Plain Concepts Research 团队,我们花了数月时间评估实时对话虚拟人系统的性能,目标是确定最适合生产环境的配置。在整个研究过程中,我们分析了不同的对话式 AI 模型和硬件配置,测量了延迟、响应稳定性和整体系统性能等指标。结果使我们能够确定哪些组件对用户体验影响最大,以及哪种组合提供了性能与一致性之间的最佳平衡。
背景与动机
该项目的目标是开发一个能够与用户进行实时语音交互的对话虚拟人。虚拟人倾听用户,使用语言模型解读其请求,并用语音和同步的面部动画进行回应,旨在提供尽可能自然的对话。为实现这一目标,我们需要协调各种组件——语音处理、人工智能、面部动画和渲染——同时最大限度地降低系统的总延迟。
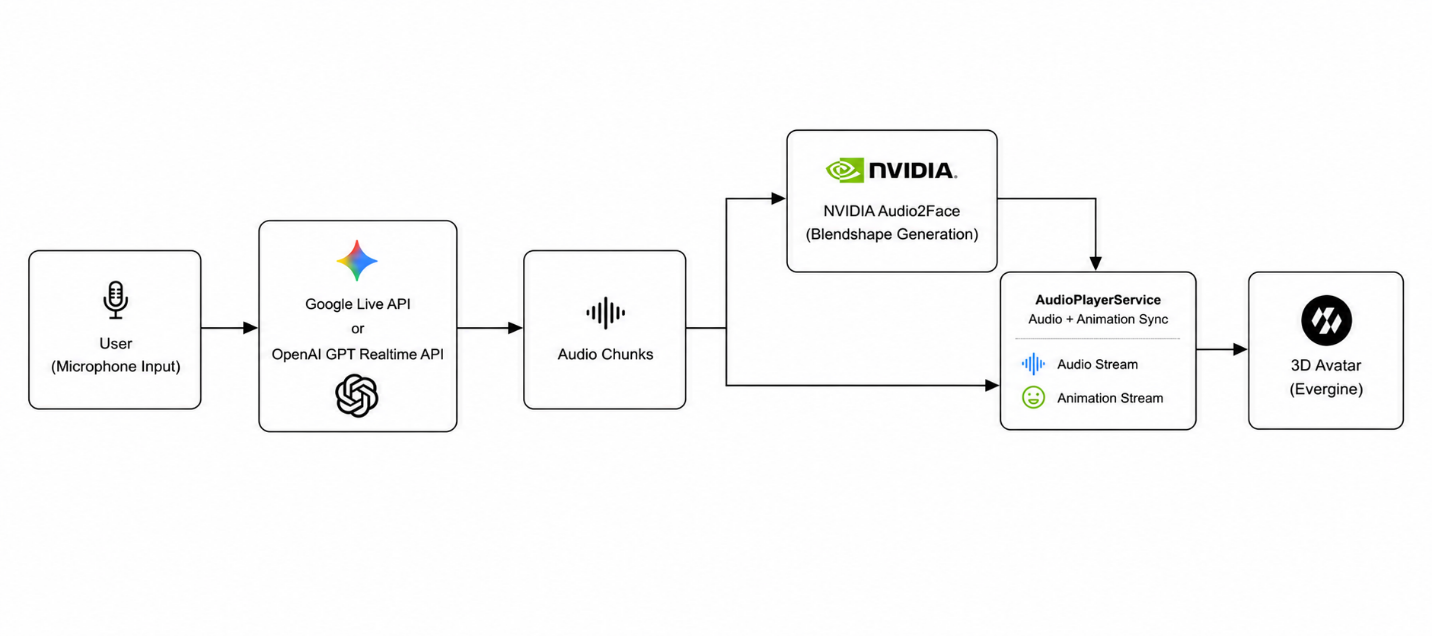
测试期间使用的管线遵循以下顺序:用户说话,语音活动检测 (VAD) 系统检测到其话轮结束。然后,LLM(在本例中为 Gemini 3.1 Live 或 GPT Realtime 模型)生成音频响应。这些音频块同时发送到 NVIDIA Audio2Face(生成面部动画 blendshapes)和音频播放服务。播放服务等待同时拥有音频和相应的动画后,再同步播放它们。最后,使用 Evergine 图形引擎在虚拟人上渲染结果。
为了让交互感觉自然,从用户停止说话到虚拟形象开始说话和做动画的总耗时必须尽可能短且可预测。事实上,从用户体验的角度来看,不可预测的延迟峰值比稍高但稳定的延迟更明显,也更具破坏性。
第一部分:LLM 提供商对比
为了找出最适合生产环境的提供商,我们比较了具备实时对话能力的领先语言模型的性能。我们不仅关注哪个响应最快,还关注哪个提供了最稳定、可预测的延迟——这是让虚拟形象交互感觉自然的一个基本因素。
为此,我们测量了每个被评估提供商的 TTFT(首 Token 时间)——从客户端的 VAD 检测到用户话轮结束,到模型生成的首个音频字节到达所经过的时间。所有提供商的测试方法完全相同:相同的 VAD、相同的 silence_duration_ms 值(200 毫秒),以及按难度等级组织的相同的 20 个问题库。
什么是 TTFT,为什么它很重要?
TTFT 代表“首 Token 时间”,在音频语境下,即首个音频字节的生成时间。它是从用户停止说话到语言模型响应的首个音频块到达之间的时间间隔。它不包括 Audio2Face 或播放缓冲区的处理时间——纯粹是 LLM 的“思考”时间。
TTFT 越低,音频就能越早开始处理。而且它越稳定(标准差越低),用户体验的可预测性就越高。
尽管模型评估中另一个常见指标是 TPOT(每输出 Token 时间),但本研究未测量 TPOT,因为在此场景下,它无法为用户体验提供相关信息。一旦收到首个音频块,瓶颈就转移到了 Audio2Face,它有足够的时间处理后续陆续到达的音频块。因此,TTFT 是最能代表系统感知响应能力的指标。
方法
所有提供商均在相同条件下进行测量,以确保结果具有可比性:
- 语音活动检测器 (VAD): 所有案例中均使用相同的声学检测器,基于信号电平 (RMS),阈值为 0.01,确认窗口为 150 毫秒。当用户停止说话时激活。
- 服务器静默: 所有提供商均为 200 毫秒,即服务器在向 LLM 发送请求前额外等待的时间。
- 测试问题: 20 个问题,分为四个难度等级(5 个简单、5 个中等、5 个复杂、5 个非常复杂),另有 1 个热身问题不纳入分析。
20 个问题中的每一个都针对每个提供商执行一次,记录获得的 TTFT。根据每个模型的 20 次测量结果集,计算聚合指标(平均值、标准差、最小值和最大值)。
问题根据模型预期的推理工作量进行分类。简单问题对应问候或简单的常识;中等问题需要简短解释;复杂问题涉及推理或建议阐述;非常复杂问题则要求进行规划、比较或详细概念解释的详尽回答。
完整列表可在附录:所用问题库中找到。
部署区域: GPT Realtime 由 Azure 瑞典中部区域提供服务。Gemini Live 不公开固定区域;Google 会自动路由请求。
| 提供商 | 平均值 | 标准差 | 最小值 | 最大值 |
|---|---|---|---|---|
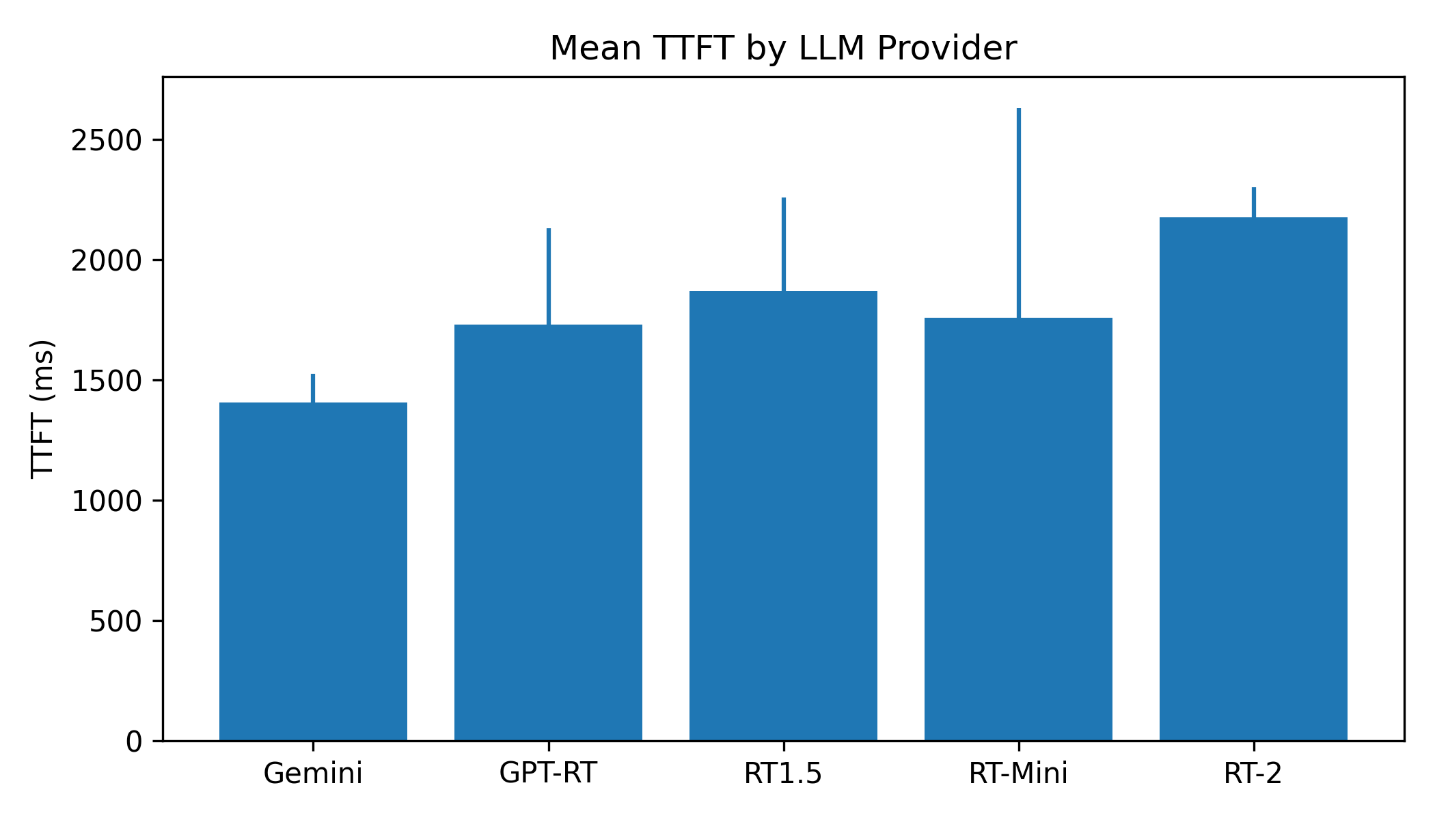
| Gemini 3.1 Live | 1,407 毫秒 | ±118 毫秒 | 1,191 毫秒 | 1,626 毫秒 |
| GPT-Realtime | 1,731 毫秒 | ±399 毫秒 | 834 毫秒 | 2,783 毫秒 |
| GPT-Realtime 1.5 | 1,869 毫秒 | ±389 毫秒 | 1,263 毫秒 | 2,857 毫秒 |
| GPT-Realtime-Mini | 1,758 毫秒 | ±872 毫秒 | 1,045 毫秒 | 4,446 毫秒 |
| GPT-Realtime-2 | 2,232 毫秒 | ±126 毫秒 | 1,931 毫秒 | 2,523 毫秒 |
按难度级别划分的延迟
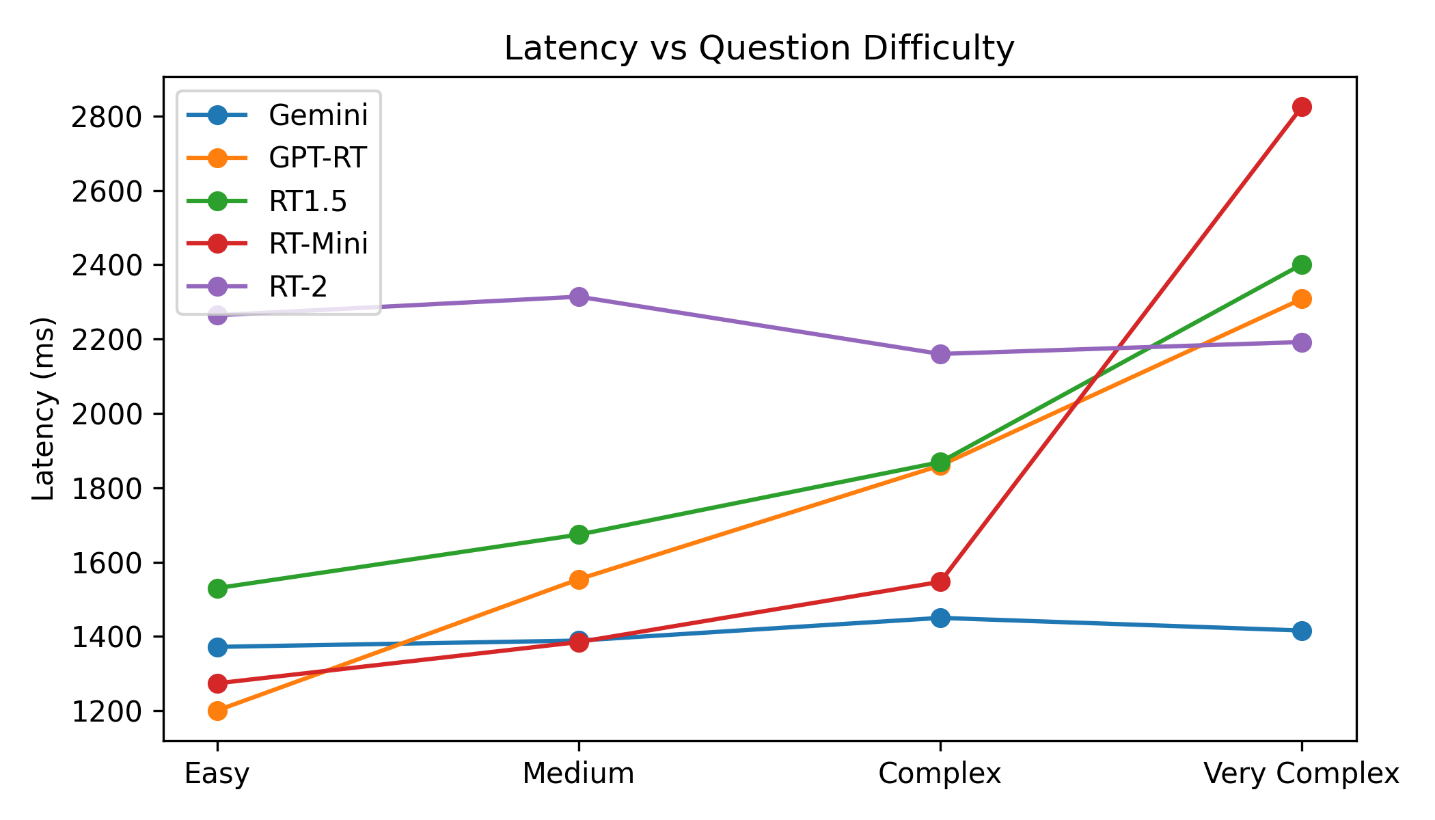
最重要的发现是每个模型在复杂度增加时的行为。Gemini 3.1 Live 无论难度如何,延迟几乎恒定(约 1,400 毫秒)。而 GPT 模型则显著增长:GPT-Realtime 从简单问题的 1,201 毫秒增加到非常复杂问题的 2,308 毫秒。
注意: GPT-Realtime 部署在 Azure 瑞典中部区域,而 Gemini 3.1 Live 使用 Google 的自动基础设施路由。因此,观察到的部分 TTFT 差异可能受到客户端与各提供商基础设施之间网络延迟的影响。
| 难度 | Gemini 3.1 Live | GPT-Realtime | GPT-Realtime 1.5 | GPT-Realtime Mini | GPT-Realtime 2 |
|---|---|---|---|---|---|
| 简单 | 1,372 毫秒 | 1,201 毫秒 | 1,530 毫秒 | 1,274 毫秒 | 2,264 毫秒 |
| 中等 | 1,389 毫秒 | 1,554 毫秒 | 1,674 毫秒 | 1,385 毫秒 | 2,314 毫秒 |
| 复杂 | 1,450 毫秒 | 1,860 毫秒 | 1,869 毫秒 | 1,547 毫秒 | 2,160 毫秒 |
| 非常复杂 | 1,416 毫秒 | 2,308 毫秒 | 2,401 毫秒 | 2,825 毫秒 | 2,192 毫秒 |
主要发现
Gemini 最快且最稳定。 平均延迟 1,407 毫秒,标准差仅 ±118 毫秒,Gemini 3.1 Live 是最可预测的提供商。无论提出什么问题,它都能在相同范围内一致响应。
Gemini 的延迟不会随复杂度增加而上升。 简单问题:1,372 毫秒。非常复杂的问题:1,416 毫秒。差距仅为 44 毫秒——基本属于统计噪声。这表明 Gemini 3.1 Live 模型针对恒定延迟进行了优化,而非根据难度投入更多推理时间。在测试过程中,未观察到足以证明这种恒定延迟合理性的显著响应质量差异。
最有趣的发现不是谁更快,而是 Gemini 无论复杂度如何都保持恒定延迟,而 GPT 会根据难度调整推理时间。
GPT-Realtime 在简单问题上最快。 对于简单问题,GPT-Realtime 达到 1,201 毫秒,比 Gemini 更快。问题出在复杂度上:对于非常复杂的问题,其延迟会增加到 2,308 毫秒,几乎翻倍。这表明它会根据问题难度投入更多推理时间。
GPT-Realtime-Mini 存在严重的异常值。 两个非常复杂的问题使其延迟飙升至 4,446 毫秒和 3,781 毫秒。其标准差为 ±872 毫秒,是所有模型中最不可预测的——不建议用于处理复杂问题的生产环境。
响应质量。 除延迟外,不同模型之间还呈现出明显的定性差异:
- Gemini: 唯一在被询问时能给出合理时间的提供方。在整个对话过程中保持一致的语音和语调。
- GPT-Realtime、1.5、2: 拒绝提供时间(可能是由于无法访问系统时钟)。对话中还检测到意外的声音变化:在某些时刻,助手会明显改变其音色或语调,偶尔听起来像异性的声音。这些变化破坏了交互过程中的连贯感。
- GPT-Realtime-Mini: 在实际推理中失败。当被问及去离家 20 米的洗车店是步行好还是开车好时,它建议开车。这是唯一回答错误的模型。
这些观察是定性的,基于测试过程中的经验。它们并非系统性质量研究的一部分,但与生产决策相关。
第二部分:Audio2Face 的硬件对比
一旦 LLM 生成音频响应,该音频必须转换为面部动画:嘴唇动作、脸颊、眉毛——全部实时完成。NVIDIA Audio2Face (A2F) 就是执行此转换的系统,它生成“blendshapes”——精确指示虚拟形象面部每块肌肉在任何给定时刻移动多少的数值指令。
Audio2Face 是继 LLM 之后计算开销最大的组件。它可以通过两种方式运行:
- 本地 (Docker): 模型在用户自己的计算机 GPU 上运行。延迟最低(所有处理均在本地),但需要专用硬件,且无法扩展至多用户。
- 云端 (Azure Container App): 模型在云端的 A100 GPU 上运行。会增加网络延迟(每个音频块约 10~20 毫秒)。尽管这种架构专为多用户场景设计,但本研究未进行并发测试,因此其扩展能力尚未评估。
什么是音频块?
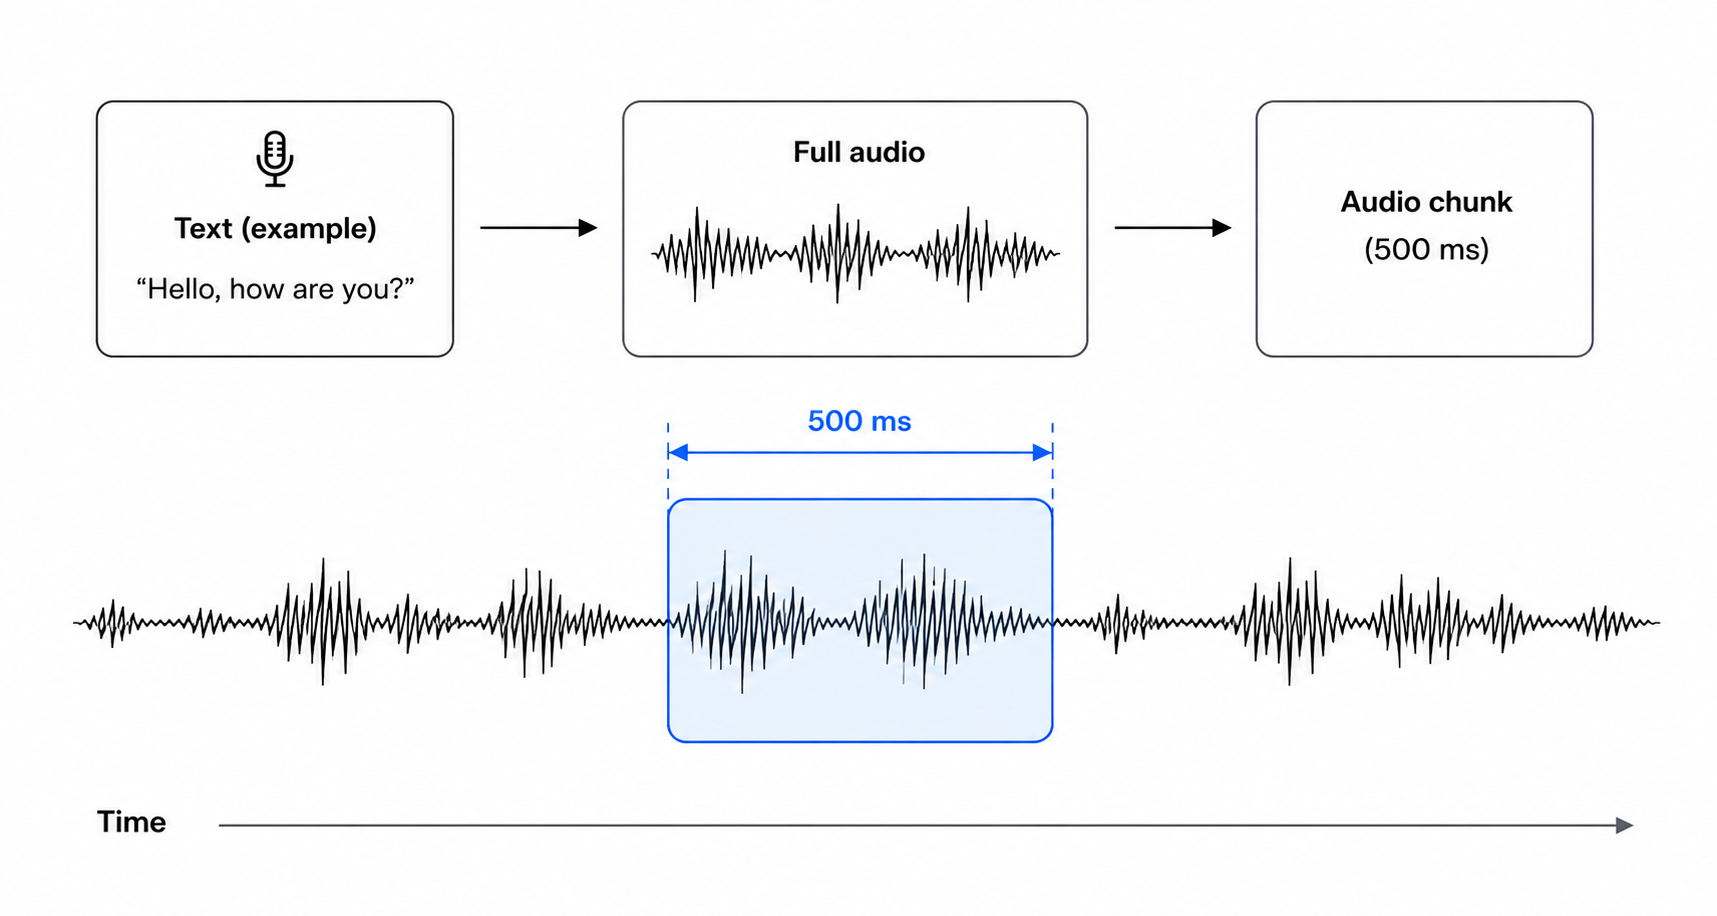
NVIDIA Audio2Face 不会一次性处理完整音频——相反,它接收被分割成小片段(块)的音频,这些片段通过 gRPC 连续发送。每个块包含几百毫秒的音频,Audio2Face 一收到一个块,就开始生成相应的面部动画,无需等待句子的其余部分。
块大小代表了延迟和效率之间的权衡:较小的块可以让虚拟形象动画更快开始,但会增加请求数量和处理开销。相反,较大的块可以减少这种开销,但需要等待更长时间才能开始动画。
方法
- 测试环境: RTX 4070(笔记本,本地 Docker)、RTX 4080 Super(台式机,本地 Docker)、RTX 5090(台式机,本地 Docker)和 NVIDIA A100(Azure Container App)。详细硬件列表见附录:测试环境。
- 研究设计: 对 25 种块大小(从 300 毫秒到 1,500 毫秒,步长为 50 毫秒)进行扫描,每种步长测试 5 个块(每个环境共 125 个块)。复用 gRPC 通道以消除连接开销。
| 音频块 | RTX 4070 | RTX 4080 Super | RTX 5090 | A100(云端) | 4070→5090 | A100→5090 |
|---|---|---|---|---|---|---|
| 300 毫秒 | 596 毫秒 | 249 毫秒 | 225 毫秒 | 237 毫秒 | 2.65× | 1.05× |
| 500 毫秒 | 637 毫秒 | 325 毫秒 | 283 毫秒 | 303 毫秒 | 2.25× | 1.07× |
| 750 毫秒 | 1,162 毫秒 | 421 毫秒 | 386 毫秒 | 400 毫秒 | 3.01× | 1.04× |
| 1,000 毫秒 | 1,240 毫秒 | 495 毫秒 | 455 毫秒 | 476 毫秒 | 2.73× | 1.05× |
| 1,500 毫秒 | 1,882 毫秒 | 676 毫秒 | 613 毫秒 | 662 毫秒 | 3.07× | 1.08× |
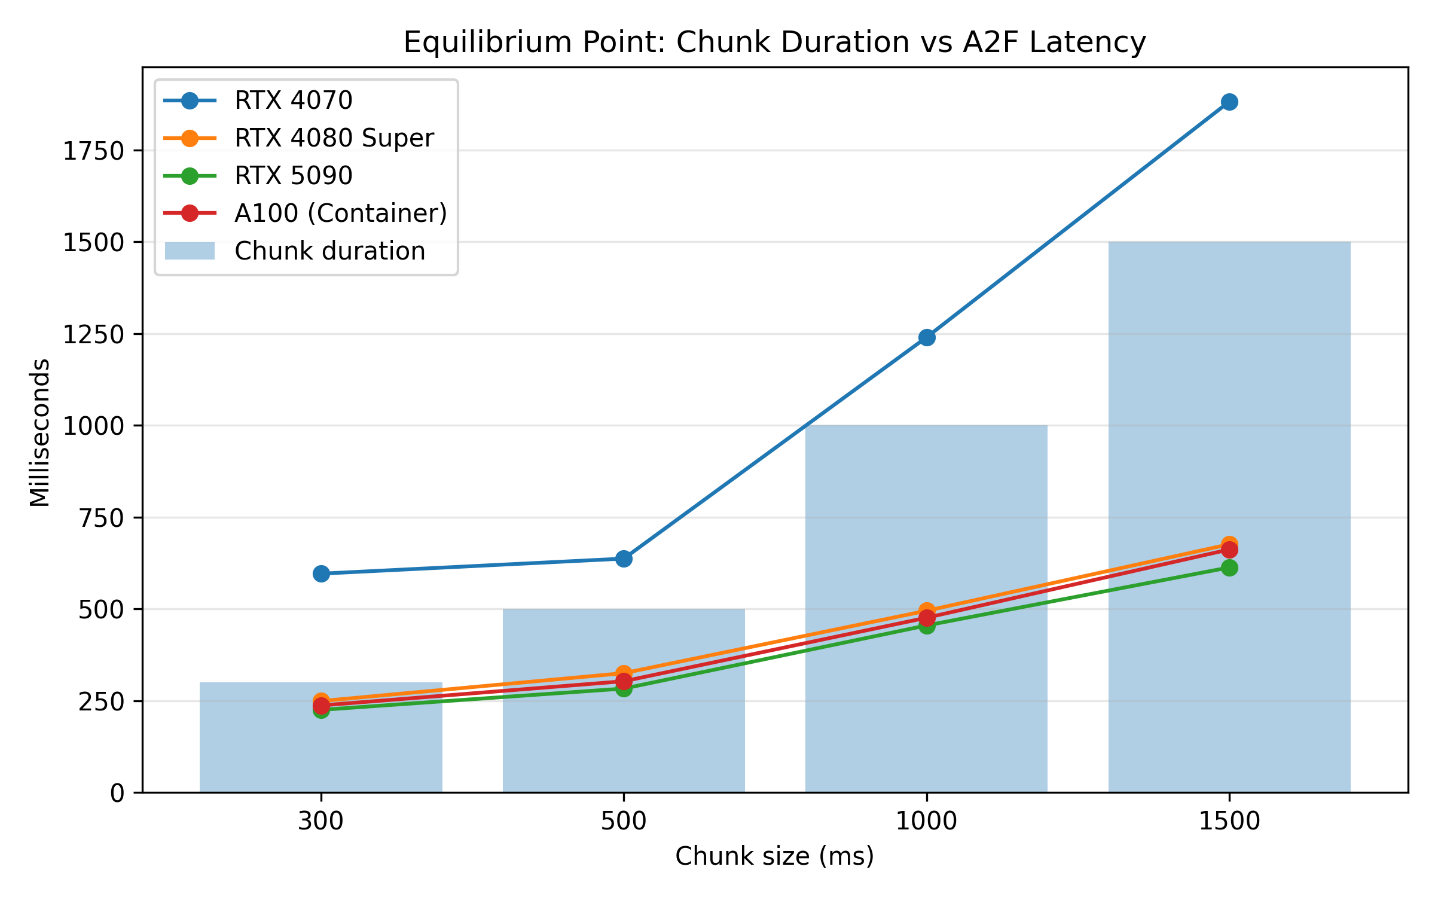
RTX 5090 在所有音频块大小下均实现了最低延迟。然而,与 RTX 4080 Super 相比,差异相对较小(在测试中为 24–63 毫秒),因此对系统总延迟的影响有限。这表明,从延迟角度来看,两款 GPU 的表现非常相似。
关于部署在 Azure Container Apps 上的 NVIDIA A100,其性能也非常接近 RTX 5090,仅有少量因网络通信产生的额外延迟。对于 Audio2Face 集中运行的架构而言,这种部署方式是一种替代方案。不过,本研究仅限于延迟分析,并未评估运营成本或并发负载下的性能等方面。
第三部分:LLM + A2F 组合延迟分析
结合两项研究,整个流水线的总延迟(不包括在所有配置中保持恒定的播放缓冲区)是 LLM 的 TTFT 与 A2F 延迟之和。
A2F 延迟是指从通过 gRPC 发送音频块到接收到用于虚拟形象动画的相应 blendshapes 之间的时间。在本地部署中,这是纯粹的处理时间,而在 A100 上则包括网络往返时间。
A2F 的数值对应 500 毫秒的音频块,这是实际生产中的实用值——它在减少动画开始前的等待时间与将 gRPC 请求开销保持在合理水平之间取得了良好平衡。
| LLM | A2F 硬件 | TTFT LLM | A2F @500 毫秒 | 总计 | 标准差 |
|---|---|---|---|---|---|
| Gemini 3.1 Live | RTX 5090 | 1,407 毫秒 | 283 毫秒 | 1,690 毫秒 | ±120 毫秒 |
| Gemini 3.1 Live | A100(云端) | 1,407 毫秒 | 303 毫秒 | 1,710 毫秒 | ±119 毫秒 |
| Gemini 3.1 Live | RTX 4080 Super | 1,407 毫秒 | 325 毫秒 | 1,732 毫秒 | ±120 毫秒 |
| Gemini 3.1 Live | RTX 4070 | 1,407 毫秒 | 637 毫秒 | 2,044 毫秒 | ±122 毫秒 |
| GPT-Realtime | RTX 5090 | 1,731 毫秒 | 283 毫秒 | 2,014 毫秒 | ±401 毫秒 |
| GPT-Realtime-2 | RTX 5090 | 2,176 毫秒 | 283 毫秒 | 2,459 毫秒 | ±128 毫秒 |
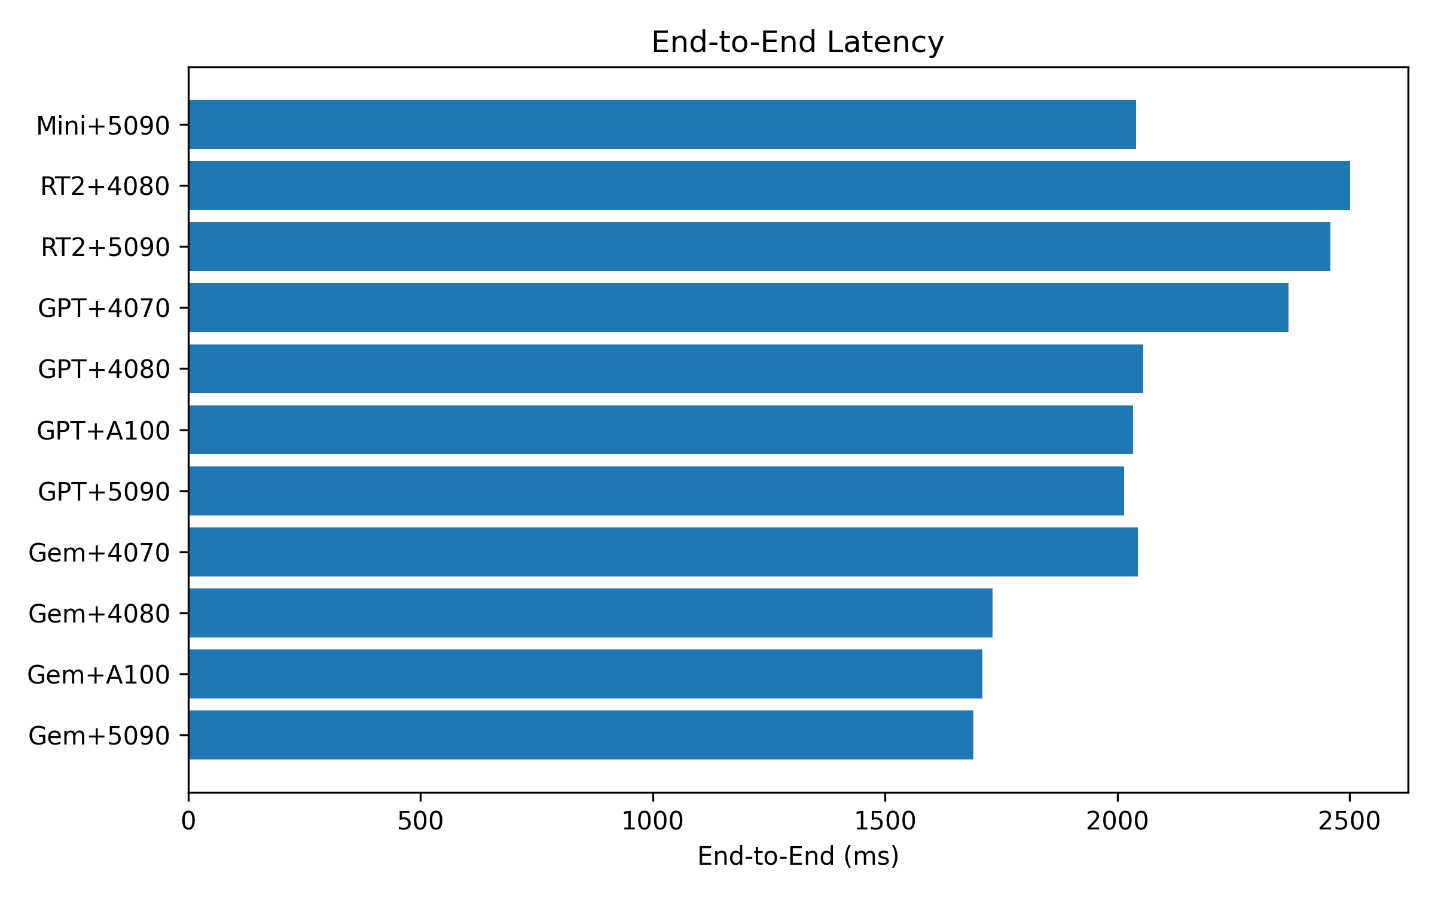
LLM 提供商的选择比硬件选择的影响更大:在 500 毫秒音频块下,最佳与最差模型(Gemini 对比 GPT-Realtime-2)之间的差异约为 770 毫秒,而最佳与最差 GPU(RTX 5090 对比 RTX 4070)之间的差异约为 354 毫秒。一致性与绝对速度同等重要:Gemini + RTX 5090 的组合标准差为 ±120 毫秒,而 GPT-Realtime + RTX 5090 为 ±401 毫秒,GPT-Realtime-Mini 为 ±872 毫秒。
生产环境建议
在评估了本研究所描述架构下对话式 AI 模型与硬件配置的不同组合后,可以确立一套用于生产环境部署的建议。下表根据测试中获得的总延迟和观察到的一致性,总结了最相关的配置。在评估条件下,Gemini 3.1 Live + RTX 5090 组合实现了最佳整体性能,在所有分析的配置中提供了最低的延迟和最高的稳定性。
| 优先级 | LLM | A2F 硬件 | 总延迟 | 理由 |
|---|---|---|---|---|
| 🥇 最佳方案 | Gemini 3.1 Live | RTX 5090 | 约 1,690 毫秒 | 最低延迟,端到端一致性最高 |
| 🥈 最佳云端方案 | Gemini 3.1 Live | A100(云端) | 约 1,710 毫秒 | 仅多 20 毫秒;多用户场景下合理 |
| 🥉 不使用 RTX 5090 | Gemini 3.1 Live | RTX 4080 Super | 约 1,732 毫秒 | 出色的性价比 |
| ⚠️ 不推荐 | 任意 | RTX 4070 | >2,044 毫秒 | 在任何 chunk 配置下均无法提供可接受的动画延迟 |
| ⚠️ 不推荐 | GPT-RT-Mini | 任意 | 不可预测 | 标准差 ±873 毫秒;极复杂问题上峰值高达 4.4 秒 |
结论
本研究分析了哪种对话式 AI 模型与 Audio2Face 硬件的组合能为实时虚拟形象提供最佳体验,主要通过延迟及其一致性来衡量。
在评估的模型中,Gemini 3.1 Live 最适合生产环境:它不仅平均速度最快,而且最稳定,无论问题复杂程度如何,其响应时间始终保持在非常相似的范围内。GPT 模型在简单问题上具有竞争力,但其延迟随难度增加而增长,而 GPT-Realtime-Mini 的峰值超过 4 秒,完全破坏了对话的自然性。
关于面部动画的硬件,在本研究使用的 GPU 中,RTX 5090 和云端 A100 提供了非常相似的性能。RTX 4080 Super 是一个可靠的替代方案,对用户而言差异可忽略不计。然而,RTX 4070 引入的延迟在每种配置下都会影响流畅性,因此结论是不推荐用于生产环境。
推荐的生产环境组合是 Gemini 3.1 Live 搭配 RTX 5090 或 A100,其综合延迟约为 1,700 毫秒,波动范围为 ±120 毫秒,保证了稳定自然的对话体验。
研究局限性
在解读本研究的结果和建议时,应考虑到以下限制条件:
- 单用户环境。 所有测试均在单个并发用户下进行。系统在多并发负载下的行为(尤其是在 A100 云端配置中)尚未评估,可能与本文呈现的数值有显著差异。
- 不可控的网络延迟。 每个提供商的 TTFT 包含了客户端与模型基础设施之间的网络延迟。GPT-Realtime 由 Azure 瑞典中部提供服务,而 Gemini 3.1 Live 则使用 Google 基于客户端位置的自动路由。观察到的提供商之间的部分差异可能源于此变量,而非模型的内在性能。
- 非系统性的质量评估。 关于响应质量(连贯性、语音语调、推理能力)的观察是定性的,并在延迟测试期间收集。它们并非结构化质量研究的一部分,不应被视为关于每个模型能力的最终结论。
- 未包含同步缓冲区和渲染。 报告的总延迟不包括音频与 blendshape 之间的同步缓冲区,也不包括 Evergine 的渲染时间。这两个组件在所有配置中都是恒定的,不影响比较,但会影响用户感知的实际延迟。
附录:使用的问题库
| 难度 | 问题 |
|---|---|
| 简单 | 你好,你怎么样? |
| 简单 | 现在大约几点了? |
| 简单 | 法国的首都是哪里? |
| 简单 | 一周有多少天? |
| 简单 | 把蓝色和黄色混合会得到什么颜色? |
| 中等 | 简要解释一下什么是人工智能。 |
| 中等 | 作为宠物,狗和猫的主要区别是什么? |
| 中等 | 为什么白天的天空看起来是蓝色的? |
| 中等 | 定期锻炼有什么好处? |
| 中等 | SSD 与传统硬盘有什么区别? |
| 复杂 | 我正在学习编程,你建议我从哪种语言开始,为什么? |
| 复杂 | 我有 1500 欧元的预算购买一台兼顾工作和游戏的电脑,你会如何在各个组件之间分配预算? |
| 复杂 | 请用简单的语言逐步解释神经网络的工作原理。 |
| 复杂 | 远程办公与现场办公相比,各有哪些优缺点? |
| 复杂 | 如果我想在一年内从零开始学会英语,你会建议怎样的每周学习计划? |
| 非常复杂 | 设计一份预算为 2500 欧元的日本 10 天旅行详细计划,说明要游览的城市、推荐的交通方式以及大致的预算分配。 |
| 非常复杂 | 假设你是一家拥有 200 名员工的公司的技术负责人,公司希望将整个基础设施迁移到云端。请逐步说明你将如何规划迁移,以最大程度地降低风险和减少停机时间。 |
| 非常复杂 | 深入比较 C++、C# 和 Rust 语言在图形引擎开发中的应用,分析其性能、内存安全、开发便捷性和生态系统。最后给出有理有据的建议。 |
| 非常复杂 | 解释基于 Transformer 的 AI 模型从接收一个句子到生成回复的工作原理,描述分词、嵌入、注意力机制和推理等概念。 |
| 非常复杂 | 我打算去离我家大约 20 米远的洗车店洗车。你认为我应该走过去还是开车过去?请给出你的理由,并考虑到目标是洗车且距离非常短。 |
附录:测试环境
| 参数 | 值 |
|---|---|
| 测量日期 | 2026年7月 |
| Audio2Face 版本 | audio2face-3d:2.0 |
| 模型 | gemini-3.1-flash-live-preview, gpt-realtime, gpt-realtime-mini, gpt-realtime-2, gpt-realtime-1.5 |
| RTX 4070 机器 | CPU: 13th Gen Intel(R) Core(TM) i7-13700H, RAM: 32 GB, OS: Windows |
| RTX 4080 Super 机器 | CPU: AMD Ryzen 7 7800X3D, RAM: 32 GB, OS: Windows |
| RTX 5090 机器 | CPU: Intel Core i7-14700, RAM: 32 GB, OS: Windows |
| A100(云端) | 提供商:Azure Container Apps,区域:瑞典中部 |