Estudio de avatares conversacionales con IA: comparativa de LLM y Audio2Face
En el equipo de Research de Plain Concepts hemos estado trabajando durante varios meses para evaluar el rendimiento de un sistema de avatares conversacionales en tiempo real con el objetivo de identificar la configuración más adecuada para un entorno de producción. A lo largo de esta investigación analizamos distintos modelos de IA conversacional y configuraciones de hardware, evaluando métricas como la latencia, la estabilidad de las respuestas y el rendimiento del sistema completo. Los resultados nos han permitido identificar qué componentes tienen un mayor impacto en la experiencia del usuario y qué combinación ofrece el mejor equilibrio entre rendimiento y consistencia.
Contexto y motivación
El objetivo de este proyecto es desarrollar un avatar conversacional capaz de mantener una interacción por voz con el usuario en tiempo real. El avatar escucha al usuario, interpreta su petición mediante un modelo de lenguaje y responde tanto con voz como con animaciones faciales sincronizadas, buscando ofrecer una conversación lo más natural posible. Para conseguirlo, hemos necesitado coordinar distintos componentes de procesamiento de voz, inteligencia artificial, animación facial y renderizado, minimizando la latencia total del sistema.
El pipeline que hemos utilizado durante las pruebas sigue la siguiente secuencia: el usuario habla y un sistema de Voice Activity Detection (VAD) detecta el final de su intervención. A continuación, el LLM (en este caso, Gemini 3.1 Live o un modelo de GPT Realtime) genera una respuesta en forma de audio. Estos fragmentos de audio se envían simultáneamente a NVIDIA Audio2Face, encargado de generar las animaciones faciales (blendshapes), y al servicio de reproducción de audio. Este último espera a disponer tanto del audio como de la animación correspondiente para reproducir ambos de forma sincronizada. Finalmente, el resultado se renderiza sobre el avatar mediante el motor gráfico Evergine.
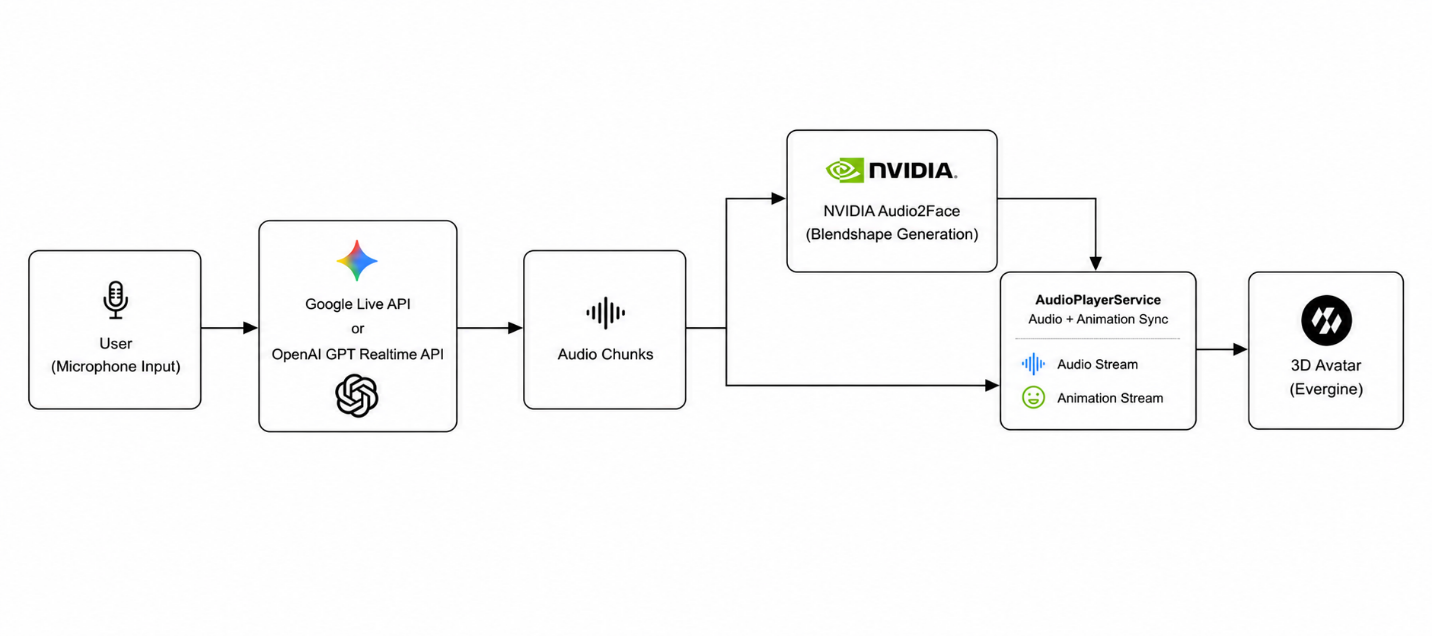
Para que la interacción resulte natural, el tiempo total transcurrido desde que el usuario deja de hablar hasta que el avatar comienza a hablar y a animarse debe ser lo más reducido y predecible posible. De hecho, desde el punto de vista de la experiencia de usuario, los picos de latencia impredecibles resultan más perceptibles y molestos que una latencia ligeramente superior pero estable.
Parte I: Comparativa de proveedores LLM
Con el objetivo de identificar el proveedor más adecuado para un entorno de producción, hemos comparado el rendimiento de los principales modelos de lenguaje con capacidad de conversación en tiempo real. Nuestro interés no es únicamente conocer cuál respondía más rápido, sino también cuál ofrece una latencia más estable y predecible, un aspecto fundamental para que la interacción con el avatar resulte natural.
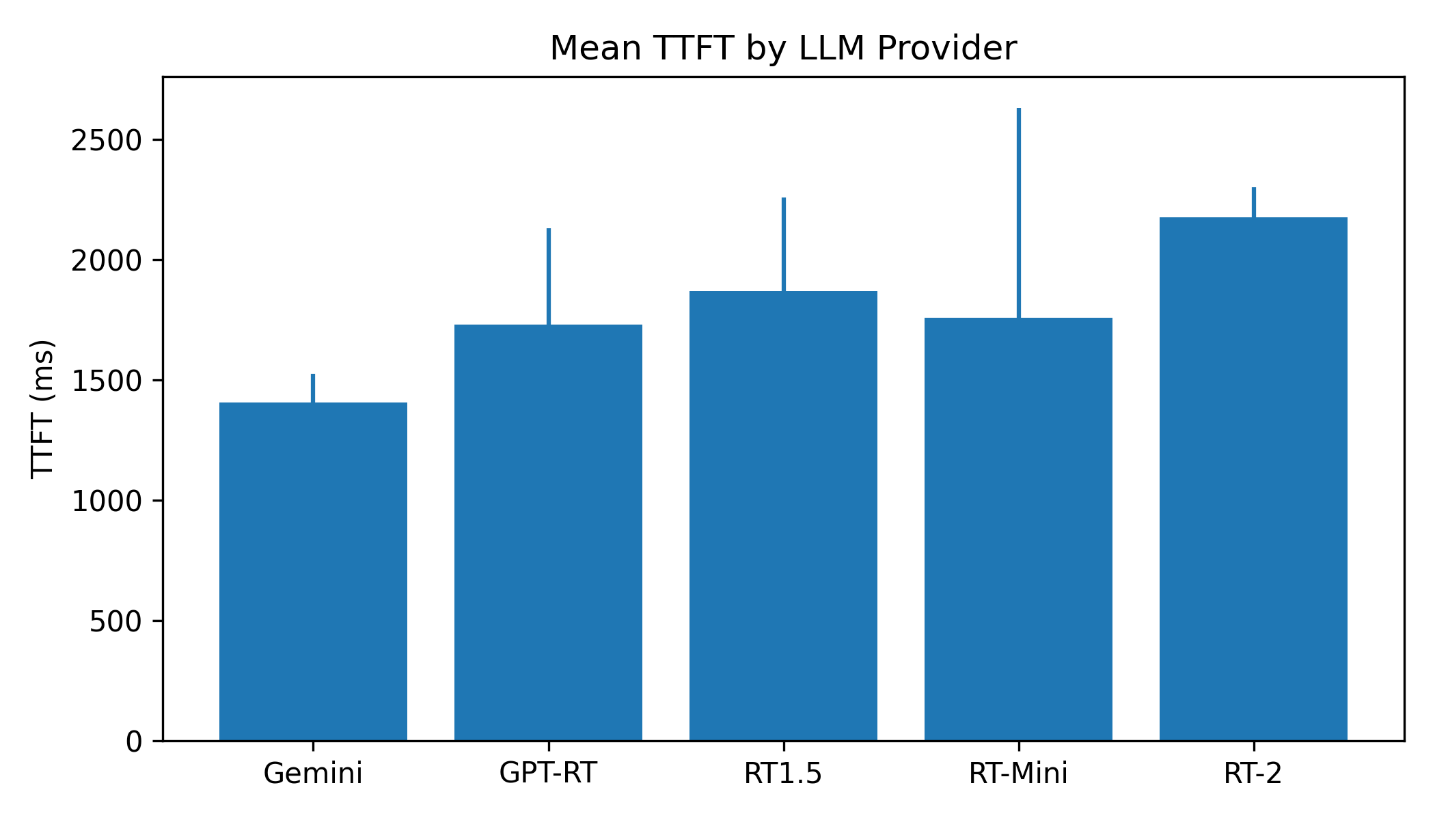
Para ello, medimos el TTFT (Time To First Token) de cada proveedor evaluado, es decir, el tiempo que transcurre desde que el VAD del cliente detecta el final de la intervención del usuario hasta que llega el primer byte de audio generado por el modelo. La metodología fue idéntica para todos los proveedores: mismo VAD, mismo valor de silence_duration_ms (200 ms) y el mismo banco de 20 preguntas organizadas por nivel de dificultad.
¿Qué es el TTFT y por qué importa?
TTFT significa “Time To First Token” o, en el contexto de audio, tiempo hasta el primer byte de audio. Es el intervalo que transcurre desde que el usuario deja de hablar hasta que llega el primer fragmento de respuesta sonora del modelo de lenguaje. No incluye Audio2Face ni el buffer de reproducción, es puro tiempo de “pensamiento” del LLM.
Cuanto menor sea el TTFT, antes puede empezar a procesarse el audio. Y cuanto más estable sea (menor desviación estándar), más predecible resulta la experiencia para el usuario.
Aunque otra métrica habitual en la evaluación de modelos es el TPOT (Time Per Output Token), en este estudio no se ha medido el TPOT porque, en este escenario, no aporta información relevante para la experiencia del usuario. Una vez recibido el primer fragmento de audio, el cuello de botella pasa a ser Audio2Face, que dispone de tiempo suficiente para procesar los siguientes fragmentos mientras estos continúan llegando. Por ello, el TTFT es la métrica que mejor representa la capacidad de respuesta percibida del sistema.
Metodología
Todos los proveedores se han medido en las mismas condiciones para que los resultados sean comparables:
- Detector de voz (VAD): el mismo detector acústico en todos los casos, basado en nivel de señal (RMS), con umbral 0,01 y confirmación de 150 ms. Se activa cuando el usuario deja de hablar.
- Silencio del servidor: 200 ms en todos los proveedores, tiempo extra que espera el servidor antes de enviar la petición al LLM.
- Preguntas de prueba: 20 preguntas organizadas en cuatro niveles de dificultad (5 fáciles, 5 medias, 5 complejas, 5 muy complejas), con 1 de calentamiento excluida del análisis.
Cada una de las 20 preguntas se ejecutó una única vez en cada proveedor, registrando el TTFT obtenido. Las métricas agregadas (media, desviación estándar, mínimo y máximo) se calcularon a partir del conjunto de las 20 mediciones por cada modelo.
La clasificación se realizó en función del esfuerzo de razonamiento esperado por parte del modelo. Las preguntas fáciles corresponden a saludos o conocimiento general sencillo; las medias requieren explicaciones breves; las complejas implican razonamiento o elaboración de recomendaciones; y las muy complejas exigen respuestas extensas con planificación, comparación o explicación detallada de conceptos.
El listado completo puede consultarse en el Anexo: Banco de preguntas utilizado.
Región de despliegue: GPT Realtime se sirve desde la región Azure Sweden Central. Gemini Live no expone región fija; Google enruta automáticamente las peticiones.
| Proveedor | Media | Desv. típica | Mín. | Máx. |
|---|---|---|---|---|
| Gemini 3.1 Live | 1.407 ms | ±118 ms | 1.191 ms | 1.626 ms |
| GPT-Realtime | 1.731 ms | ±399 ms | 834 ms | 2.783 ms |
| GPT-Realtime 1.5 | 1.869 ms | ±389 ms | 1.263 ms | 2.857 ms |
| GPT-Realtime-Mini | 1.758 ms | ±872 ms | 1.045 ms | 4.446 ms |
| GPT-Realtime-2 | 2.232 ms | ±126 ms | 1.931 ms | 2.523 ms |
Latencia por nivel de dificultad
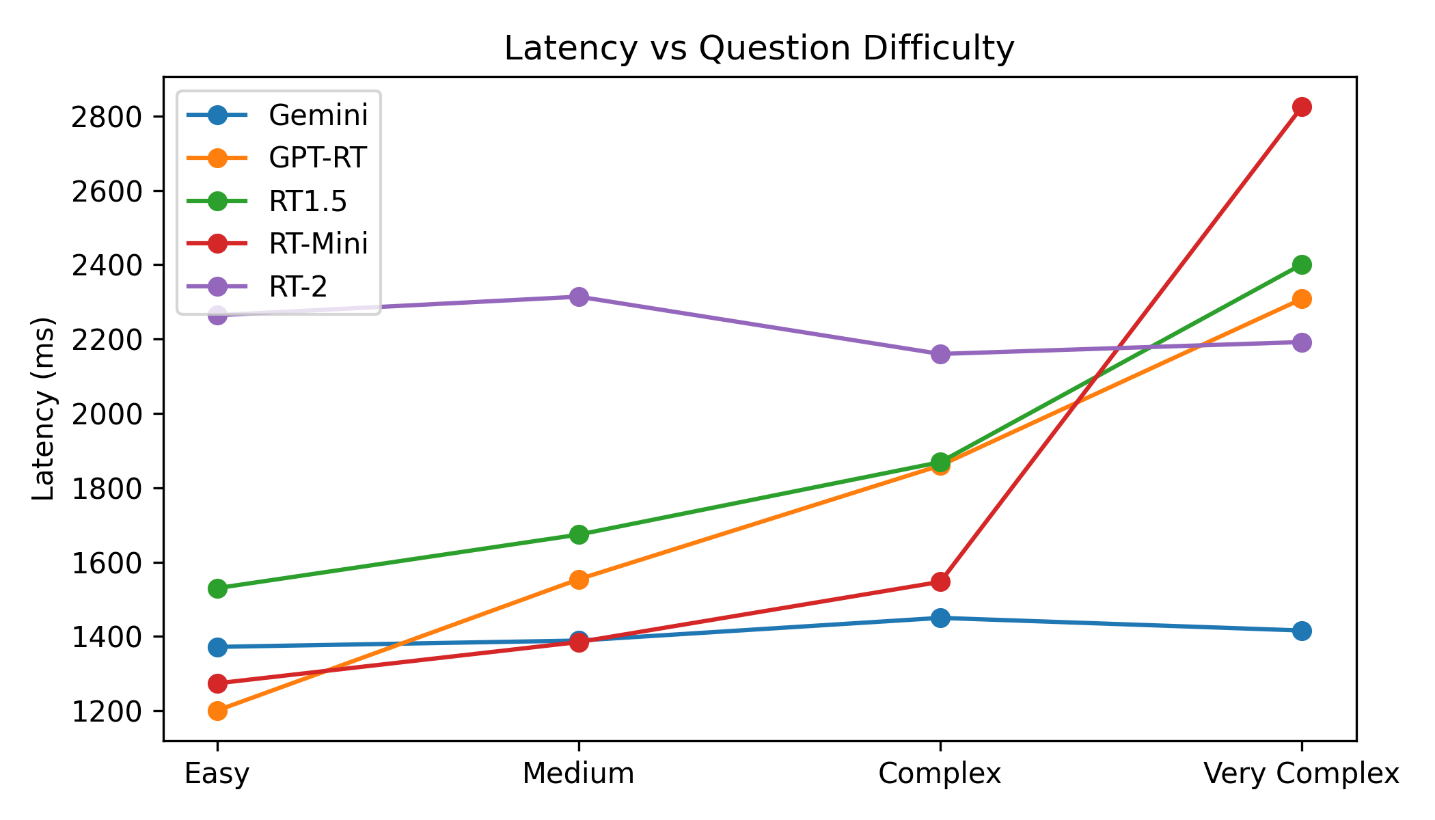
El hallazgo más relevante es el comportamiento de cada modelo ante el incremento de complejidad. Gemini 3.1 Live mantiene una latencia prácticamente constante (~1.400 ms) independientemente de la dificultad. Los modelos GPT, en cambio, escalan significativamente: GPT-Realtime pasa de 1.201 ms en preguntas fáciles a 2.308 ms en preguntas muy complejas.
Nota: GPT-Realtime se desplegó en la región Azure Sweden Central, mientras que Gemini 3.1 Live utiliza el enrutado automático de la infraestructura de Google. En consecuencia, parte de las diferencias observadas en el TTFT podrían estar influenciadas por la latencia de red entre el cliente y la infraestructura de cada proveedor.
| Dificultad | Gemini 3.1 Live | GPT-Realtime | GPT-Realtime 1.5 | GPT-Realtime Mini | GPT-Realtime 2 |
|---|---|---|---|---|---|
| Fácil | 1.372 ms | 1.201 ms | 1.530 ms | 1.274 ms | 2.264 ms |
| Media | 1.389 ms | 1.554 ms | 1.674 ms | 1.385 ms | 2.314 ms |
| Compleja | 1.450 ms | 1.860 ms | 1.869 ms | 1.547 ms | 2.160 ms |
| Muy compleja | 1.416 ms | 2.308 ms | 2.401 ms | 2.825 ms | 2.192 ms |
Hallazgos clave
Gemini es el más rápido y consistente. Con una media de 1.407 ms y una desviación estándar de solo ±118 ms, Gemini 3.1 Live es el proveedor más predecible. Responde siempre en el mismo rango, independientemente de lo que se le pregunte.
La latencia de Gemini NO escala con la complejidad. Pregunta fácil: 1.372 ms. Pregunta muy compleja: 1.416 ms. La diferencia es de apenas 44 ms, prácticamente ruido estadístico. Esto sugiere que el modelo de Gemini 3.1 Live está optimizado para latencia constante, no para dedicar más tiempo a razonar según la dificultad. Durante las pruebas no se apreciaron diferencias significativas en la calidad de las respuestas que justificasen esta latencia constante.
El hallazgo más interesante no es quién es más rápido, sino que Gemini tiene latencia constante sin importar la complejidad, mientras que GPT escala su tiempo de razonamiento con la dificultad.
GPT-Realtime es el más rápido en preguntas fáciles. En preguntas sencillas, GPT-Realtime llega a 1.201 ms, más rápido que Gemini. El problema llega con la complejidad: en preguntas muy complejas escala hasta 2.308 ms, casi el doble. Esto indica que dedica más tiempo de razonamiento cuanto más difícil es la pregunta.
GPT-Realtime-Mini tiene outliers severos. Dos preguntas muy complejas disparan su latencia a 4.446 ms y 3.781 ms. Con una desviación estándar de ±872 ms, es el más impredecible de todos, directamente no recomendable para producción con preguntas complejas.
Calidad de las respuestas. Más allá de la latencia, se observaron diferencias cualitativas entre modelos:
- Gemini: el único proveedor que responde con una hora plausible cuando se le pregunta. Mantiene voz y tono consistentes durante toda la conversación.
- GPT-Realtime, 1.5, 2: se niegan a dar la hora (probablemente por falta de acceso al reloj del sistema). También se detectaron cambios inesperados en la voz durante la conversación: en algunos momentos el asistente modificaba el timbre o la entonación de su voz de manera notable, llegando incluso a sonar como una voz del género opuesto. Estos cambios rompían la sensación de continuidad durante la interacción.
- GPT-Realtime-Mini: falla en razonamiento práctico. Cuando se le pregunta si es mejor ir a pie o en coche a un lavado de autos a 20 metros de casa, sugirió conducir. Fue el único modelo que respondió incorrectamente.
Estas observaciones son cualitativas, basadas en la experiencia durante las pruebas. No forman parte de un estudio de calidad sistemático, pero son relevantes para la decisión de producción.
Parte II: Comparativa de hardware para Audio2Face
Una vez que el LLM genera la respuesta en audio, ese audio debe convertirse en animaciones faciales: movimiento de labios, mejillas, cejas… Todo esto en tiempo real. NVIDIA Audio2Face (A2F) es el sistema que hace esa conversión, produciendo “blendshapes”, instrucciones numéricas que dictan exactamente cuánto se mueve cada músculo de la cara del avatar en cada instante.
Audio2Face es el componente más caro computacionalmente después del LLM. Puede ejecutarse de dos maneras:
- Local (Docker): el modelo corre en la GPU del propio ordenador del usuario. Latencia mínima (todo en local), pero requiere hardware dedicado y no escala a múltiples usuarios.
- Nube (Azure Container App): el modelo corre en una GPU A100 en la nube. Añade latencia de red (~10–20 ms por chunk). Aunque este tipo de arquitectura está orientada a escenarios multiusuario, en este estudio no se realizaron pruebas de concurrencia, por lo que no se ha evaluado su capacidad de escalado.
¿Qué es un chunk de audio?
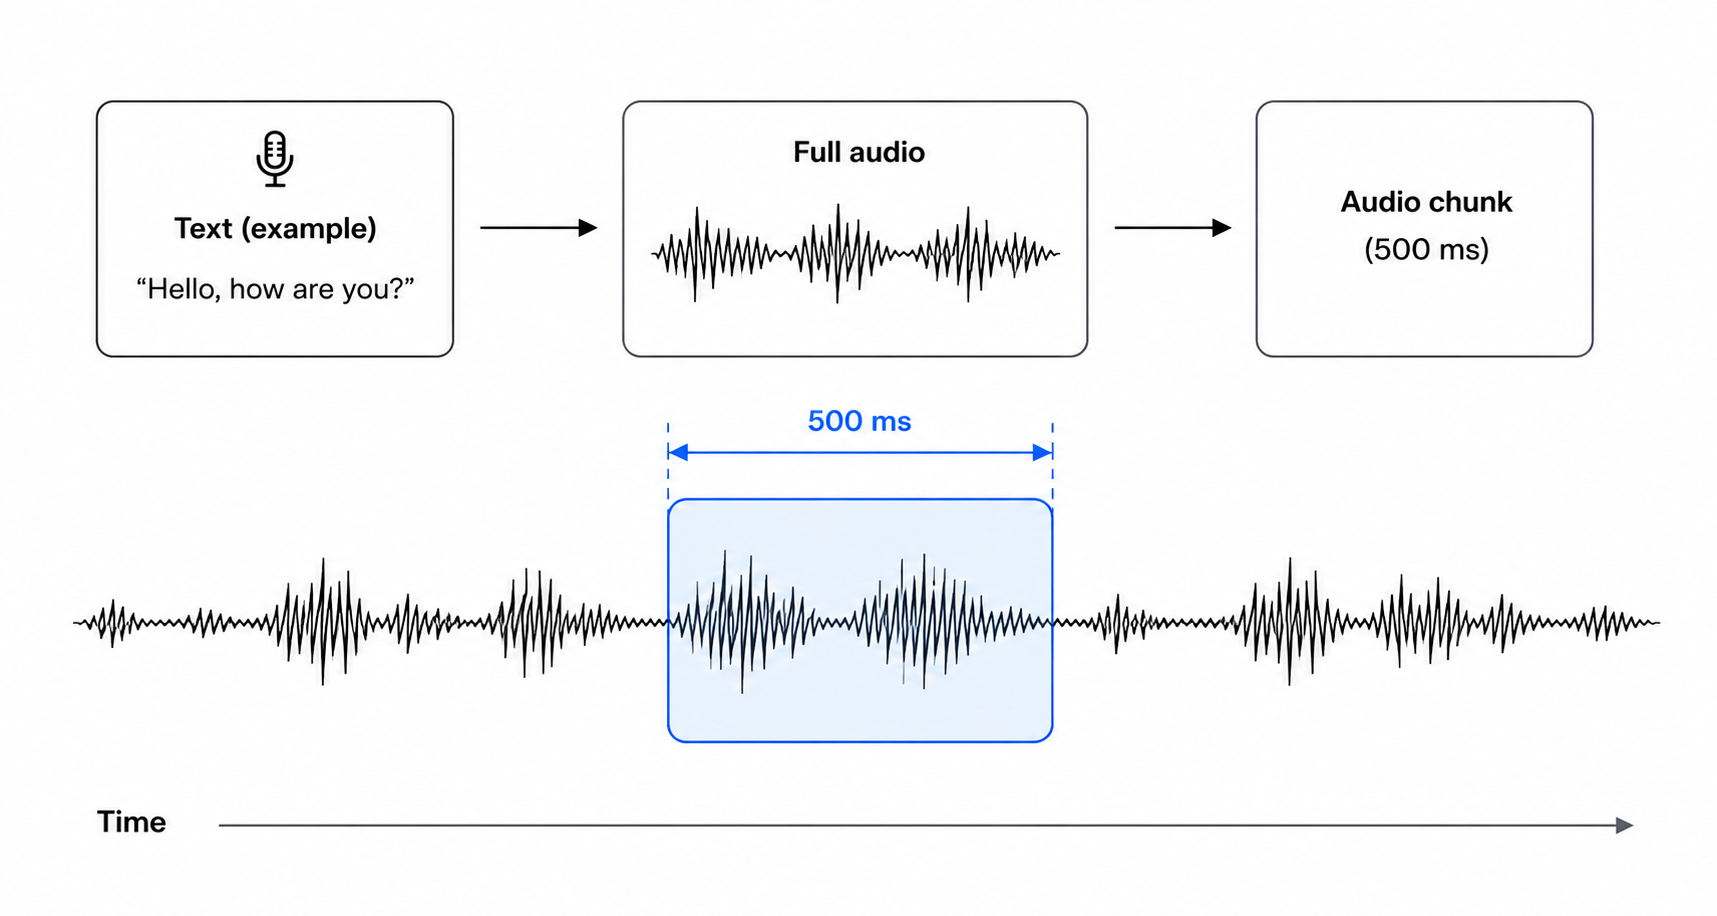
NVIDIA Audio2Face no procesa el audio completo de una sola vez, sino que lo recibe dividido en pequeños fragmentos (chunks) que se envían de forma continua a través de gRPC. Cada chunk contiene unos pocos cientos de milisegundos de audio y, en cuanto Audio2Face recibe uno de ellos, comienza a generar las animaciones faciales correspondientes sin esperar al resto de la frase.
El tamaño del chunk representa un compromiso entre latencia y eficiencia: chunks pequeños permiten iniciar antes la animación del avatar, pero incrementan el número de peticiones y el coste de procesamiento. Por el contrario, chunks más grandes reducen ese overhead, aunque obligan a esperar más tiempo antes de comenzar la animación.
Metodología
- Entornos de prueba: RTX 4070 (portátil, Docker local), RTX 4080 Super (sobremesa, Docker local), RTX 5090 (sobremesa, Docker local) y NVIDIA A100 (Azure Container App). El listado de los equipos con más detalle puede consultarse en el Anexo: Entornos de prueba.
- Diseño del estudio: barrido de 25 tamaños de chunk (de 300 ms a 1.500 ms en pasos de 50 ms), con 5 chunks por paso (125 chunks totales por entorno). El canal gRPC se reutiliza para eliminar overhead de conexión.
| Chunk | RTX 4070 | RTX 4080 Super | RTX 5090 | A100 (nube) | 4070→5090 | A100→5090 |
|---|---|---|---|---|---|---|
| 300 ms | 596 ms | 249 ms | 225 ms | 237 ms | 2,65× | 1,05× |
| 500 ms | 637 ms | 325 ms | 283 ms | 303 ms | 2,25× | 1,07× |
| 750 ms | 1.162 ms | 421 ms | 386 ms | 400 ms | 3,01× | 1,04× |
| 1.000 ms | 1.240 ms | 495 ms | 455 ms | 476 ms | 2,73× | 1,05× |
| 1.500 ms | 1.882 ms | 676 ms | 613 ms | 662 ms | 3,07× | 1,08× |
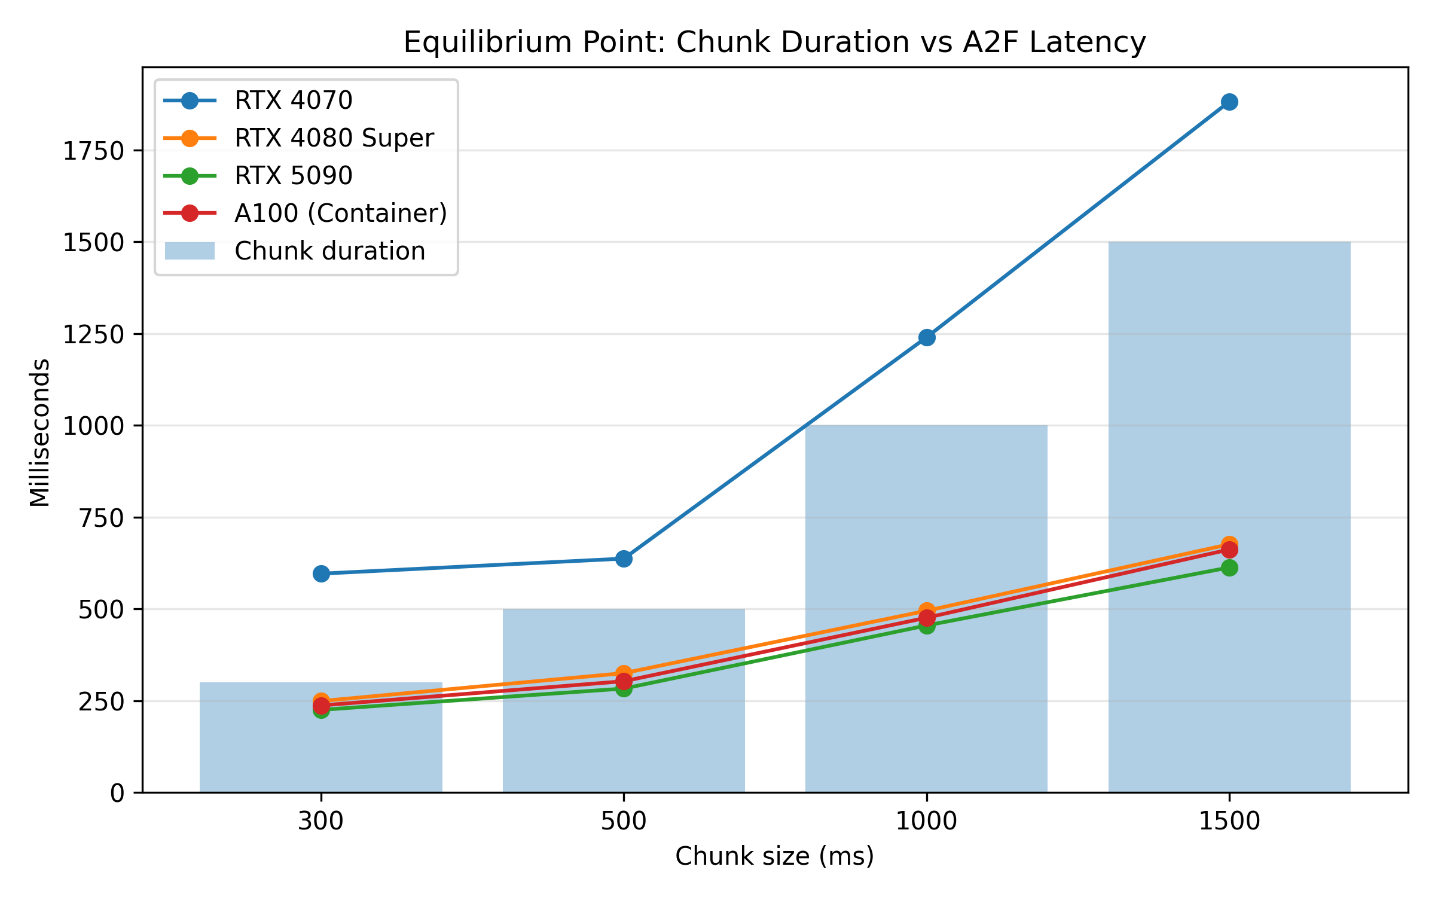
La RTX 5090 obtiene la menor latencia en todos los tamaños de chunk. Sin embargo, la diferencia respecto a la RTX 4080 Super es relativamente pequeña (24–63 ms en las pruebas realizadas), por lo que el impacto sobre la latencia total del sistema es reducido. Esto indica que, desde el punto de vista de la latencia, ambas GPUs ofrecen un comportamiento muy similar.
En cuanto a la NVIDIA A100 desplegada en Azure Container Apps, su rendimiento es también muy próximo al de la RTX 5090, con una pequeña latencia adicional atribuible a la comunicación por red. Este tipo de despliegue constituye una alternativa para arquitecturas en las que Audio2Face se ejecuta de forma centralizada. No obstante, este estudio se limita al análisis de latencia y no evalúa aspectos como el coste de operación o el rendimiento bajo cargas concurrentes.
Parte III: Análisis de latencia combinada LLM + A2F
Combinando ambos estudios, la latencia total del pipeline (excluido el buffer de reproducción, constante en todas las configuraciones) es la suma del TTFT del LLM y la latencia de A2F.
La latencia de A2F se mide desde que se envía un chunk de audio por gRPC hasta que se reciben los blendshapes correspondientes a la animación del avatar. En los despliegues locales es procesamiento puro, mientras que en la A100 incluye el ida y vuelta por red.
Los valores de A2F corresponden a un chunk de 500 ms, que es el valor práctico de producción, ya que es un punto de equilibrio entre reducir la espera antes de iniciar la animación y mantener el overhead de peticiones gRPC en un nivel razonable.
| LLM | Hardware A2F | TTFT LLM | A2F @500 ms | Total | Desv. típica |
|---|---|---|---|---|---|
| Gemini 3.1 Live | RTX 5090 | 1.407 ms | 283 ms | 1.690 ms | ±120 ms |
| Gemini 3.1 Live | A100 (nube) | 1.407 ms | 303 ms | 1.710 ms | ±119 ms |
| Gemini 3.1 Live | RTX 4080 Super | 1.407 ms | 325 ms | 1.732 ms | ±120 ms |
| Gemini 3.1 Live | RTX 4070 | 1.407 ms | 637 ms | 2.044 ms | ±122 ms |
| GPT-Realtime | RTX 5090 | 1.731 ms | 283 ms | 2.014 ms | ±401 ms |
| GPT-Realtime-2 | RTX 5090 | 2.176 ms | 283 ms | 2.459 ms | ±128 ms |
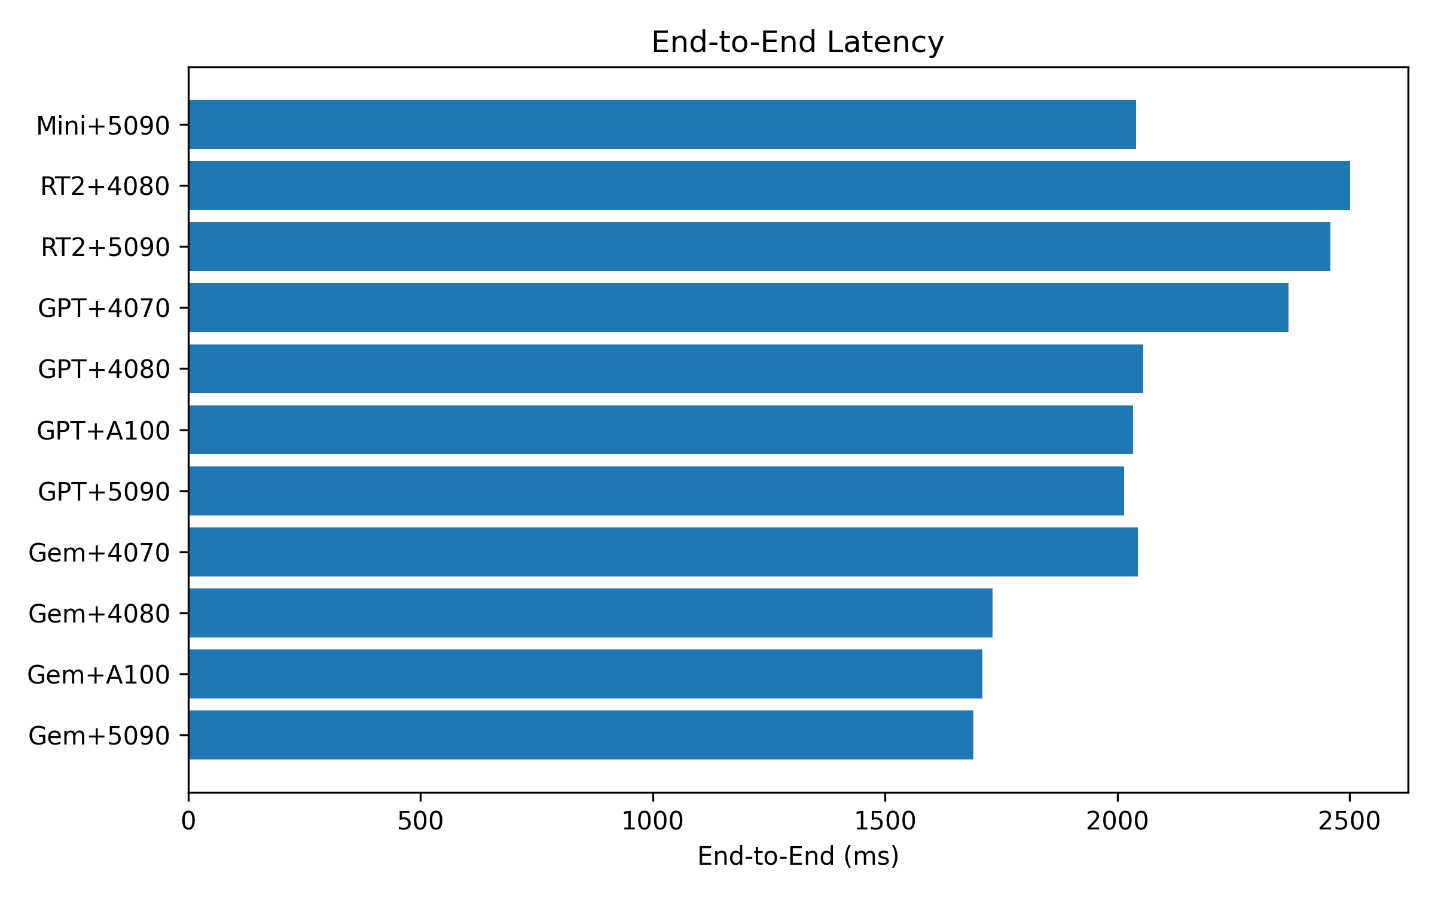
La elección del proveedor LLM tiene mayor impacto que la del hardware: la diferencia entre el mejor y peor modelo (Gemini vs GPT-Realtime-2) es ~770 ms, frente a ~354 ms entre la mejor y peor GPU (RTX 5090 vs RTX 4070) a 500 ms de chunk. La consistencia es tan relevante como la velocidad absoluta: Gemini + RTX 5090 alcanza ±120 ms de desviación estándar combinada, frente a ±401 ms de GPT-Realtime + RTX 5090 y ±872 ms de GPT-Realtime-Mini.
Recomendaciones para producción
Tras evaluar las distintas combinaciones de modelos de IA conversacional y configuraciones de hardware bajo la arquitectura descrita en este estudio, es posible establecer una recomendación para su despliegue en un entorno de producción. La tabla siguiente resume las configuraciones más relevantes en función de la latencia total obtenida y la consistencia observada durante las pruebas. En las condiciones evaluadas, la combinación Gemini 3.1 Live + RTX 5090 obtuvo el mejor rendimiento global, ofreciendo la menor latencia y la mayor estabilidad del conjunto de configuraciones analizadas.
| Prioridad | LLM | Hardware A2F | Latencia total | Justificación |
|---|---|---|---|---|
| 🥇 Óptima | Gemini 3.1 Live | RTX 5090 | ~1.690 ms | Menor latencia y mayor consistencia end-to-end |
| 🥈 Mejor opción nube | Gemini 3.1 Live | A100 (nube) | ~1.710 ms | Solo 20 ms adicionales; justificado para multiusuario |
| 🥉 Sin RTX 5090 | Gemini 3.1 Live | RTX 4080 Super | ~1.732 ms | Excelente relación coste/rendimiento |
| ⚠️ No recomendado | Cualquiera | RTX 4070 | >2.044 ms | No ofrece latencia de animación aceptable en ninguna configuración de chunk |
| ⚠️ No recomendado | GPT-RT-Mini | Cualquiera | Impredecible | ±873 ms desv. típica; picos de hasta 4,4 s en preguntas muy complejas |
Conclusiones
Este estudio analiza qué combinación de modelo de IA conversacional y hardware para Audio2Face ofrece la mejor experiencia en un avatar en tiempo real, medida principalmente a través de la latencia y su consistencia.
Entre los modelos evaluados, Gemini 3.1 Live es el más adecuado para producción: no solo es el más rápido en media, sino el más estable, respondiendo siempre en un rango muy similar independientemente de la complejidad de la pregunta. Los modelos GPT son competitivos en preguntas sencillas, pero su latencia crece con la dificultad y, en el caso de GPT-Realtime-Mini, llega a picos de más de 4 segundos que rompen completamente la naturalidad de la conversación.
En cuanto al hardware para la animación facial, con las gráficas que se han usado en este estudio, la RTX 5090 y la A100 en nube ofrecen un rendimiento muy similar. La RTX 4080 Super es una alternativa sólida con una diferencia inapreciable para el usuario. La RTX 4070, en cambio, introduce una latencia que compromete la fluidez en cualquier configuración, concluyendo que su uso no es recomendable para producción.
La combinación recomendada para producción es Gemini 3.1 Live con RTX 5090 o A100, con una latencia combinada de aproximadamente 1.700 ms y una variabilidad de ±120 ms, lo que garantiza una experiencia de conversación estable y natural.
Limitaciones del estudio
Los resultados y recomendaciones de este estudio deben interpretarse teniendo en cuenta las siguientes restricciones:
- Entorno monousuario. Todas las pruebas se realizaron con un único usuario concurrente. El comportamiento del sistema bajo carga múltiple (especialmente en la configuración con A100 en nube) no ha sido evaluado y puede diferir significativamente de los valores aquí presentados.
- Latencia de red no controlada. El TTFT de cada proveedor incluye la latencia de red entre el cliente y la infraestructura del modelo. GPT-Realtime se sirvió desde Azure Sweden Central, mientras que Gemini 3.1 Live utiliza enrutado automático de Google en función de la ubicación del cliente. Parte de las diferencias observadas entre proveedores puede deberse a esta variable, no al rendimiento intrínseco del modelo.
- Evaluación de calidad no sistemática. Las observaciones sobre calidad de respuesta (coherencia, tono de voz, capacidad de razonamiento) son cualitativas y se recogieron durante las pruebas de latencia. No forman parte de un estudio de calidad estructurado y no deben tomarse como conclusiones definitivas sobre las capacidades de cada modelo.
- Buffer de sincronización y render excluidos. La latencia total reportada no incluye el buffer de sincronización entre audio y blendshapes ni el tiempo de render de Evergine. Ambos componentes son constantes entre configuraciones y no afectan a la comparativa, pero sí a la latencia percibida real por el usuario.
Anexo: Banco de preguntas utilizado
| Nivel | Pregunta |
|---|---|
| Fácil | Hola, ¿cómo estás? |
| Fácil | ¿Qué hora es aproximadamente? |
| Fácil | ¿Cuál es la capital de Francia? |
| Fácil | ¿Cuántos días tiene una semana? |
| Fácil | ¿Qué color se obtiene al mezclar azul y amarillo? |
| Medio | Explícame brevemente qué es la inteligencia artificial. |
| Medio | ¿Cuáles son las principales diferencias entre un perro y un gato como mascotas? |
| Medio | ¿Por qué el cielo se ve azul durante el día? |
| Medio | ¿Qué ventajas tiene hacer ejercicio de forma regular? |
| Medio | ¿Qué diferencias hay entre un SSD y un disco duro tradicional? |
| Complejo | Estoy aprendiendo programación. ¿Qué lenguaje me recomendarías para empezar y por qué? |
| Complejo | Tengo un presupuesto de 1.500 € para comprar un ordenador para trabajar y jugar. ¿Cómo lo repartirías entre los distintos componentes? |
| Complejo | Explícame paso a paso cómo funciona una red neuronal de forma sencilla. |
| Complejo | ¿Qué ventajas y desventajas tiene trabajar de forma remota frente al trabajo presencial? |
| Complejo | Si quisiera aprender inglés desde cero en un año, ¿qué plan de estudio semanal me propondrías? |
| Muy complejo | Diseña un plan detallado para organizar un viaje de 10 días por Japón con un presupuesto de 2.500 €, indicando qué ciudades visitar, transporte recomendado y distribución aproximada del presupuesto. |
| Muy complejo | Imagina que eres el responsable tecnológico de una empresa de 200 empleados que quiere migrar toda su infraestructura a la nube. Explica paso a paso cómo planificarías la migración minimizando riesgos y tiempos de inactividad. |
| Muy complejo | Compara en profundidad los lenguajes C++, C# y Rust para el desarrollo de motores gráficos, analizando rendimiento, seguridad de memoria, facilidad de desarrollo y ecosistema. Finaliza con una recomendación razonada. |
| Muy complejo | Explica cómo funciona un modelo de inteligencia artificial basado en transformadores desde que recibe una frase hasta que genera una respuesta, describiendo conceptos como tokenización, embeddings, mecanismo de atención e inferencia. |
| Muy complejo | Voy a lavar mi coche en un lavadero que está a unos 20 metros de mi casa. ¿Crees que debería ir andando o en coche? Razona tu respuesta teniendo en cuenta que el objetivo es lavar el coche y que la distancia es muy corta. |
Anexo: Entornos de prueba
| Parámetro | Valor |
|---|---|
| Fecha de las mediciones | Julio de 2026 |
| Versión de Audio2Face | audio2face-3d:2.0 |
| Modelos | gemini-3.1-flash-live-preview, gpt-realtime, gpt-realtime-mini, gpt-realtime-2, gpt-realtime-1.5 |
| Equipo RTX 4070 | CPU: 13th Gen Intel(R) Core(TM) i7-13700H, RAM: 32 GB, OS: Windows |
| Equipo RTX 4080 Super | CPU: AMD Ryzen 7 7800X3D, RAM: 32 GB, OS: Windows |
| Equipo RTX 5090 | CPU: Intel Core i7-14700, RAM: 32 GB, OS: Windows |
| A100 (nube) | Provider: Azure Container Apps, Region: Sweden Central |