会話型AIアバター研究:LLMとAudio2Faceの比較
Plain Concepts Researchチームでは、本番環境に最適な構成を特定することを目的として、リアルタイム会話型アバターシステムのパフォーマンス評価に数ヶ月を費やしました。この研究を通じて、さまざまな会話型AIモデルとハードウェア構成を分析し、レイテンシ、応答の安定性、システム全体のパフォーマンスなどの指標を測定しました。その結果、ユーザーエクスペリエンスに最も大きな影響を与えるコンポーネントと、パフォーマンスと一貫性の最適なバランスを提供する組み合わせを特定することができました。
背景と動機
このプロジェクトの目標は、ユーザーとリアルタイムの音声対話が可能な会話型アバターを開発することです。アバターはユーザーの発言を聞き、言語モデルを使用して要求を解釈し、可能な限り自然な会話を提供することを目指して、音声と同期した顔のアニメーションで応答します。これを実現するには、音声処理、人工知能、顔のアニメーション、レンダリングといったさまざまなコンポーネントを連携させながら、システムの総レイテンシを最小限に抑える必要がありました。
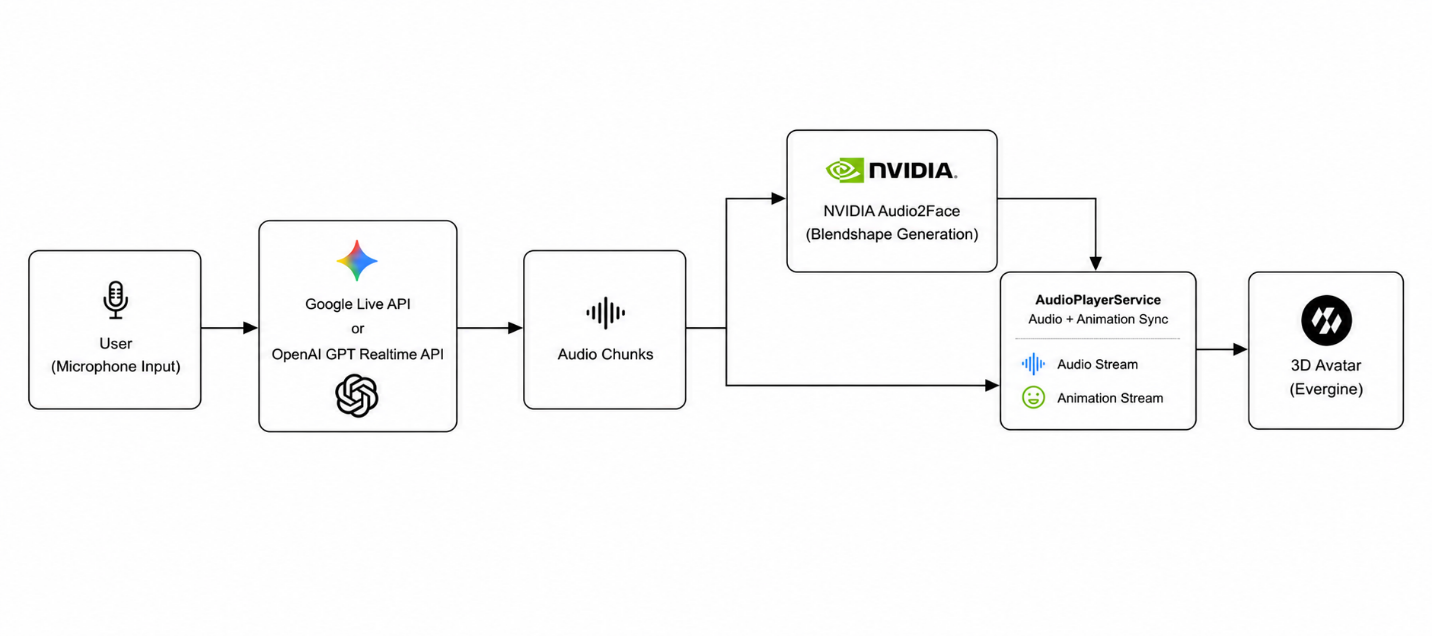
テスト中に使用されたパイプラインは、次のシーケンスに従います。ユーザーが話し、音声アクティビティ検出(VAD)システムが発話の終了を検出します。次に、LLM(この場合はGemini 3.1 LiveまたはGPT Realtimeモデル)が音声応答を生成します。これらの音声チャンクは、顔のアニメーション(ブレンドシェイプ)を生成するNVIDIA Audio2Faceと、音声再生サービスに同時に送信されます。再生サービスは、音声と対応するアニメーションの両方が揃うまで待機してから、それらを同期して再生します。最後に、Evergineグラフィックスエンジンを使用して、結果がアバター上にレンダリングされます。
インタラクションが自然に感じられるためには、ユーザーが話し終えてからアバターが発話とアニメーションを開始するまでの総経過時間が、可能な限り短く、かつ予測可能でなければなりません。実際、ユーザーエクスペリエンスの観点からは、予測不能なレイテンシのスパイクは、わずかに高くても安定したレイテンシよりも顕著で、妨げになります。
パート I: LLM プロバイダー比較
本番環境に最適なプロバイダーを特定するため、リアルタイム会話機能を持つ主要な言語モデルのパフォーマンスを比較しました。私たちの関心は、どのモデルが最も速く応答するかだけでなく、どのモデルが最も安定した予測可能なレイテンシを提供するかにもありました。これは、アバターとのインタラクションを自然に感じさせるための基本的な要素です。
このために、各評価プロバイダーの TTFT (Time To First Token) を測定しました。これは、クライアントの VAD がユーザーの発話終了を検出してから、モデルが生成した最初の音声バイトが到着するまでの経過時間です。方法論は全プロバイダーで同一であり、同じ VAD、同じ silence_duration_ms 値 (200 ms)、難易度別に構成された同じ20の質問バンクを使用しました。
TTFT とは何か、なぜ重要なのか?
TTFT は “Time To First Token” の略であり、音声コンテキストにおいては、最初の音声バイトが到着するまでの時間を指します。これは、ユーザーが話し終えてから、言語モデルの応答の最初の音声チャンクが到着するまでの間隔です。Audio2Face や再生バッファは含まれず、純粋に LLM の「思考」時間です。
TTFT が低いほど、音声の処理をより早く開始できます。そして、それが安定しているほど(標準偏差が低いほど)、ユーザーエクスペリエンスは予測可能になります。
モデル評価におけるもう一つの一般的な指標として TPOT (Time Per Output Token) がありますが、このシナリオではユーザーエクスペリエンスに関連する情報を提供しないため、本研究では TPOT を測定しませんでした。最初の音声チャンクが受信されると、ボトルネックは Audio2Face に移り、後続のチャンクが到着し続ける間、処理するのに十分な時間があります。したがって、TTFT はシステムの知覚応答性を最もよく表す指標です。
方法論
結果の比較可能性を確保するため、すべてのプロバイダーは同一条件下で測定されました。
- 音声アクティビティ検出器 (VAD): 全ケースで同一の音響検出器を使用。信号レベル (RMS) に基づき、しきい値 0.01、確認ウィンドウ 150 ms。ユーザーが話し終えたときにアクティブになります。
- サーバーサイレンス: 全プロバイダーで 200 ms。サーバーが LLM にリクエストを送信する前に待機する追加時間です。
- テスト質問: 4つの難易度レベル(簡単5問、中程度5問、複雑5問、非常に複雑5問)に構成された20の質問。分析から除外されるウォームアップ質問が1問含まれます。
20の質問はそれぞれプロバイダーごとに1回実行され、得られた TTFT が記録されました。集計指標(平均、標準偏差、最小値、最大値)は、モデルごとの20回の測定値セットから計算されました。
質問は、モデルに期待される推論努力に基づいて分類されました。簡単な質問は挨拶や簡単な一般常識に相当し、中程度の質問は簡単な説明を必要とし、複雑な質問は推論や推奨事項の作成を含み、非常に複雑な質問は計画、比較、または詳細な概念説明を伴う広範な応答を要求します。
完全なリストは、付録: 使用した質問バンクに記載されています。
デプロイメントリージョン: GPT Realtime は Azure Sweden Central リージョンから提供されます。Gemini Live は固定リージョンを公開しておらず、Google がリクエストを自動的にルーティングします。
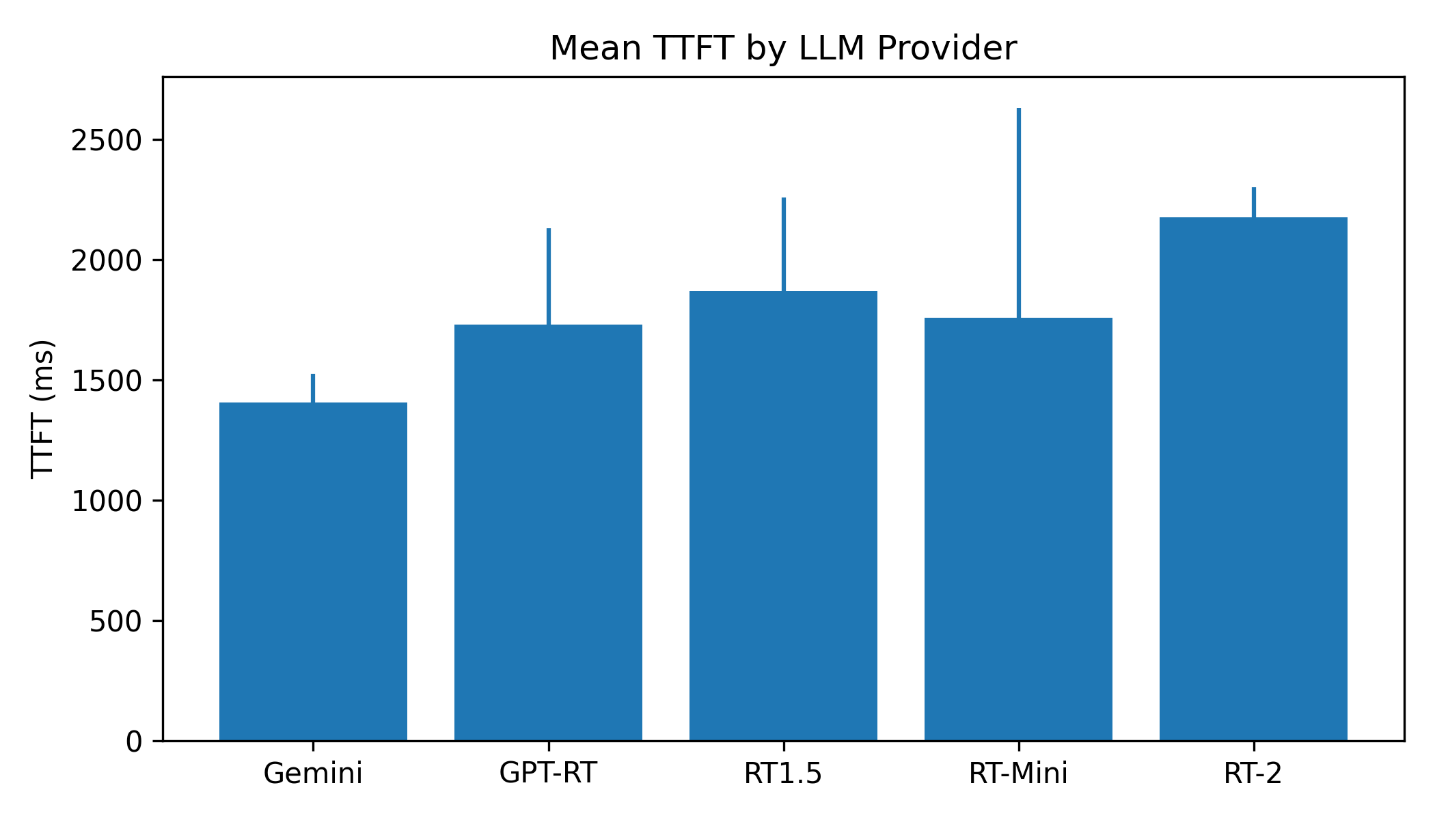
| プロバイダー | 平均 | 標準偏差 | 最小 | 最大 |
|---|---|---|---|---|
| Gemini 3.1 Live | 1,407 ms | ±118 ms | 1,191 ms | 1,626 ms |
| GPT-Realtime | 1,731 ms | ±399 ms | 834 ms | 2,783 ms |
| GPT-Realtime 1.5 | 1,869 ms | ±389 ms | 1,263 ms | 2,857 ms |
| GPT-Realtime-Mini | 1,758 ms | ±872 ms | 1,045 ms | 4,446 ms |
| GPT-Realtime-2 | 2,232 ms | ±126 ms | 1,931 ms | 2,523 ms |
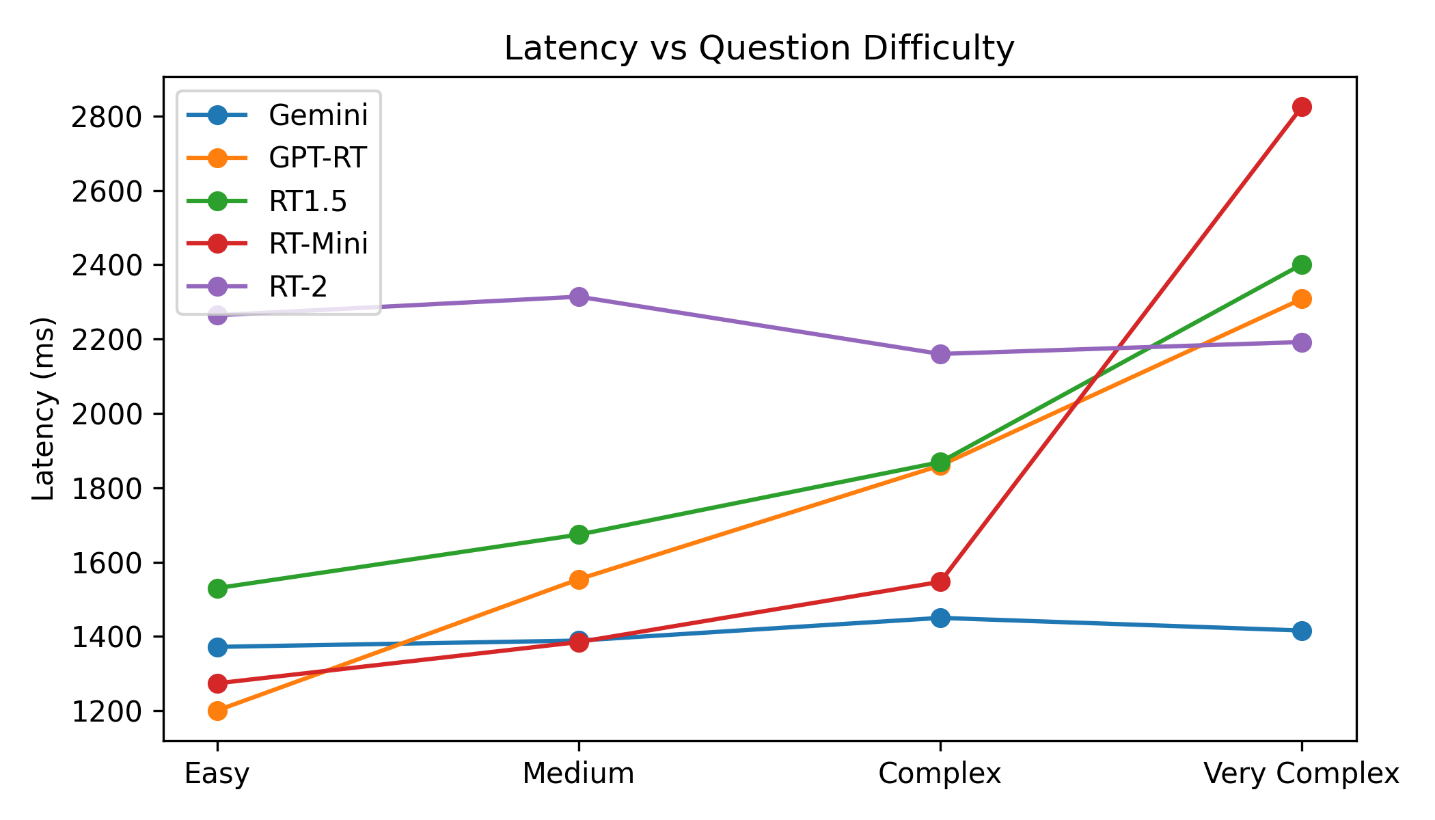
難易度別のレイテンシー
最も重要な発見は、複雑さが増すにつれての各モデルの振る舞いです。Gemini 3.1 Liveは難易度に関係なくほぼ一定のレイテンシー(約1,400 ms)を維持します。一方、GPTモデルは大幅に増加します。GPT-Realtimeは、簡単な質問での1,201 msから、非常に複雑な質問では2,308 msにまで上昇します。
注記: GPT-RealtimeはAzureのスウェーデン中部リージョンにデプロイされ、Gemini 3.1 LiveはGoogleの自動インフラストラクチャルーティングを使用しています。したがって、観測されたTTFTの差の一部は、クライアントと各プロバイダーのインフラストラクチャ間のネットワークレイテンシーの影響を受けている可能性があります。
| 難易度 | Gemini 3.1 Live | GPT-Realtime | GPT-Realtime 1.5 | GPT-Realtime Mini | GPT-Realtime 2 |
|---|---|---|---|---|---|
| 簡単 | 1,372 ms | 1,201 ms | 1,530 ms | 1,274 ms | 2,264 ms |
| 中程度 | 1,389 ms | 1,554 ms | 1,674 ms | 1,385 ms | 2,314 ms |
| 複雑 | 1,450 ms | 1,860 ms | 1,869 ms | 1,547 ms | 2,160 ms |
| 非常に複雑 | 1,416 ms | 2,308 ms | 2,401 ms | 2,825 ms | 2,192 ms |
主な調査結果
Geminiは最速かつ最も一貫性があります。 平均1,407 ms、標準偏差わずか±118 msで、Gemini 3.1 Liveは最も予測可能なプロバイダーです。質問内容に関わらず、常に同じ範囲内で応答します。
Geminiのレイテンシは複雑さに比例しません。 簡単な質問: 1,372 ms。非常に複雑な質問: 1,416 ms。その差はわずか44 msで、これはほぼ統計的なノイズです。このことから、Gemini 3.1 Liveモデルは、難易度に応じて推論時間を費やすのではなく、一定のレイテンシに最適化されていることが示唆されます。テスト中、この一定のレイテンシを正当化するような応答品質の有意な差は観測されませんでした。
最も興味深い発見は、どちらが速いかではなく、Geminiは複雑さに関係なくレイテンシが一定であるのに対し、GPTは難易度に応じて推論時間をスケールさせるという点です。
GPT-Realtimeは簡単な質問で最速です。 単純な質問では、GPT-Realtimeは1,201 msに達し、Geminiよりも高速です。問題は複雑さにあります。非常に複雑な質問では2,308 msと、ほぼ倍になります。これは、質問が難しいほど推論時間を多く割いていることを示しています。
GPT-Realtime-Miniには深刻な外れ値があります。 2つの非常に複雑な質問で、レイテンシが4,446 msと3,781 msに急増します。標準偏差が±872 msと、全モデル中で最も予測不可能であり、複雑な質問を伴う本番環境には推奨できません。
応答品質。 レイテンシ以外にも、モデル間で定性的な違いが観測されました。
- Gemini: 時刻を尋ねられた際に、もっともらしい時刻で応答した唯一のプロバイダーです。会話を通じて一貫した音声とトーンを維持します。
- GPT-Realtime, 1.5, 2: 時刻を返すことを拒否します(おそらくシステムクロックへのアクセスがないため)。会話中に予期しない音声の変化も検出されました。特定の瞬間に、アシスタントの声の音色や抑揚が顕著に変化し、時には異性の声のように聞こえることがありました。これらの変化は、インタラクション中の連続性の感覚を損ないました。
- GPT-Realtime-Mini: 実用的な推論に失敗します。自宅から20メートルの洗車場へ歩くのと車で行くのとどちらが良いか尋ねたところ、車で行くことを提案しました。これは誤った回答をした唯一のモデルでした。
これらの観測は定性的なものであり、テスト中の経験に基づいています。体系的な品質調査の一部ではありませんが、本番環境での判断に関連するものです。
第II部: Audio2Faceのハードウェア比較
LLMが音声応答を生成した後、その音声を顔のアニメーション(唇の動き、頬、眉毛)にリアルタイムで変換する必要があります。NVIDIA Audio2Face (A2F) はこの変換を実行するシステムであり、任意の瞬間にアバターの各顔の筋肉がどれだけ動くかを正確に指示する数値命令である「ブレンドシェイプ」を生成します。
Audio2Faceは、LLMに次いで計算負荷の高いコンポーネントです。これは2つの方法で実行できます。
- ローカル (Docker): モデルはユーザー自身のコンピューターのGPU上で実行されます。レイテンシは最小(すべてローカル)ですが、専用のハードウェアが必要であり、複数ユーザーへのスケールには対応しません。
- クラウド (Azure Container App): モデルはクラウド上のA100 GPUで実行されます。ネットワークレイテンシ(チャンクあたり約10~20 ms)が追加されます。このタイプのアーキテクチャはマルチユーザーシナリオ向けに設計されていますが、本研究では同時実行テストは実施されていないため、そのスケーリング能力は評価されていません。
音声チャンクとは?
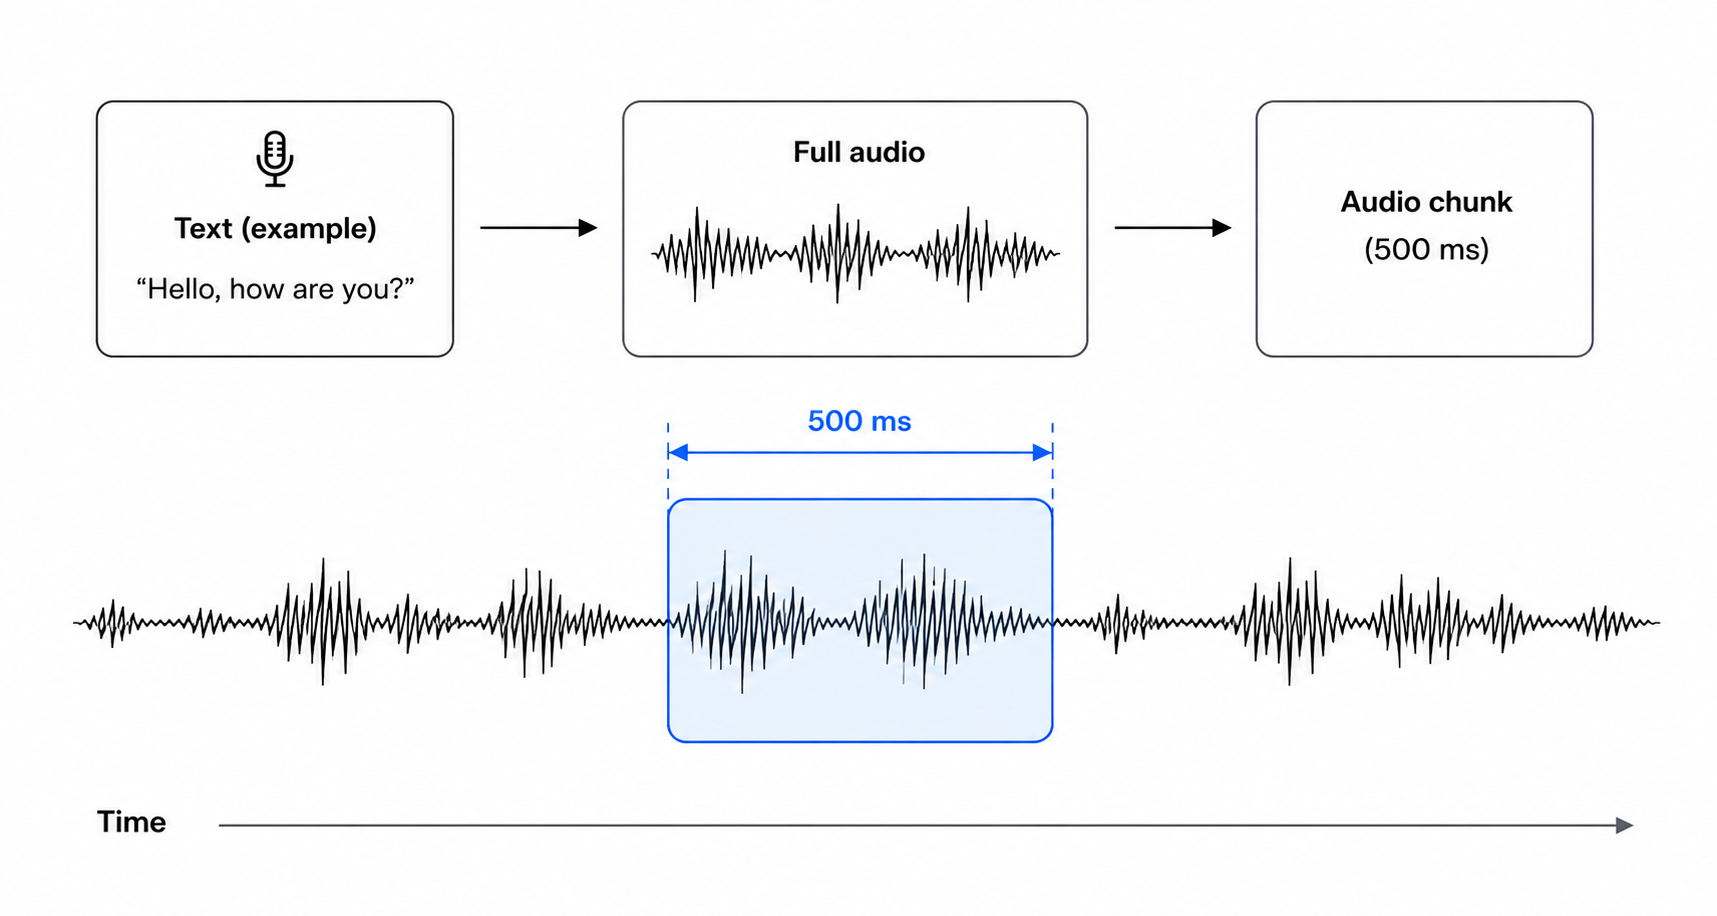
NVIDIA Audio2Faceは音声全体を一度に処理するのではなく、gRPC経由で継続的に送信される小さな断片(チャンク)に分割されたものを受け取ります。各チャンクには数百ミリ秒の音声が含まれており、Audio2Faceはチャンクを受信次第、文の残りを待たずに対応する顔のアニメーションの生成を開始します。
チャンクサイズは、レイテンシと効率性のトレードオフを表します。チャンクが小さいほどアバターアニメーションの開始は早まりますが、リクエスト数と処理オーバーヘッドが増加します。逆に、チャンクが大きいほどそのオーバーヘッドは減少しますが、アニメーション開始までに長く待つ必要があります。
方法論
- テスト環境: RTX 4070 (ラップトップ、ローカルDocker)、RTX 4080 Super (デスクトップ、ローカルDocker)、RTX 5090 (デスクトップ、ローカルDocker)、およびNVIDIA A100 (Azure Container App)。詳細なハードウェアリストは、付録: テスト環境に記載されています。
- 調査設計: 25のチャンクサイズ(300 msから1,500 msまで50 ms刻み)をスイープし、ステップごとに5チャンク(環境ごとに合計125チャンク)。gRPCチャネルは再利用され、接続オーバーヘッドが排除されています。
| チャンク | RTX 4070 | RTX 4080 Super | RTX 5090 | A100 (クラウド) | 4070→5090 | A100→5090 |
|---|---|---|---|---|---|---|
| 300 ms | 596 ms | 249 ms | 225 ms | 237 ms | 2.65× | 1.05× |
| 500 ms | 637 ms | 325 ms | 283 ms | 303 ms | 2.25× | 1.07× |
| 750 ms | 1,162 ms | 421 ms | 386 ms | 400 ms | 3.01× | 1.04× |
| 1,000 ms | 1,240 ms | 495 ms | 455 ms | 476 ms | 2.73× | 1.05× |
| 1,500 ms | 1,882 ms | 676 ms | 613 ms | 662 ms | 3.07× | 1.08× |
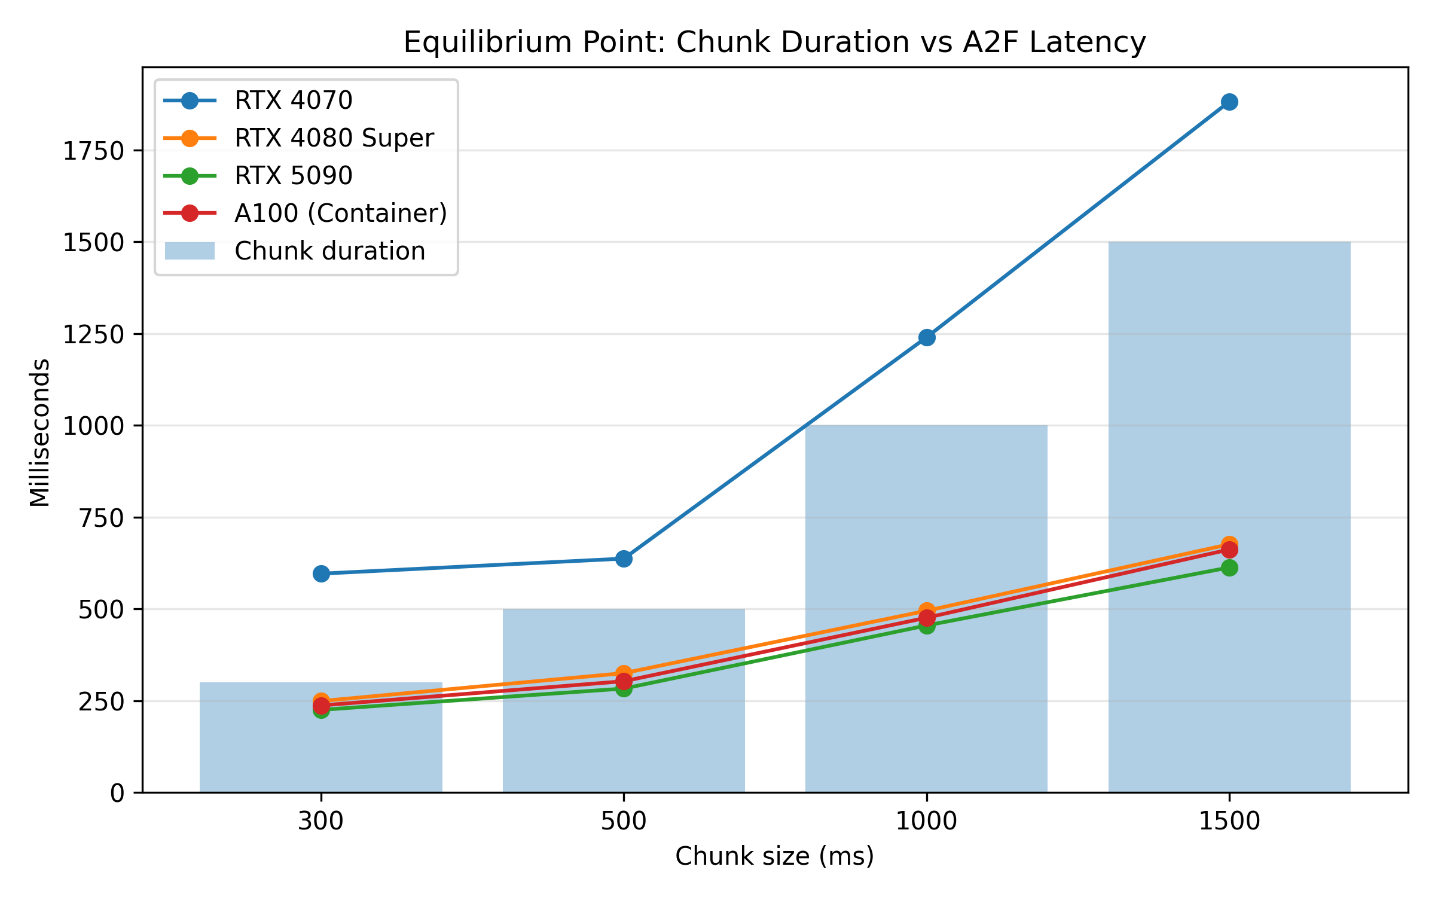
RTX 5090は、すべてのチャンクサイズで最も低いレイテンシを達成しています。ただし、RTX 4080 Superとの差は比較的小さく(実施テストでは24~63 ms)、システム全体のレイテンシへの影響は限定的です。これは、レイテンシの観点からは、両方のGPUが非常に似た動作を示すことを意味します。
Azure Container AppsにデプロイされたNVIDIA A100に関しては、そのパフォーマンスもRTX 5090に非常に近く、ネットワーク通信に起因するわずかな追加レイテンシが見られます。このタイプのデプロイは、Audio2Faceを中央で実行するアーキテクチャの代替手段となります。ただし、この調査はレイテンシ分析に限定されており、運用コストや同時負荷時のパフォーマンスといった側面は評価していません。
パートIII: LLM + A2F 統合レイテンシ分析
両方の調査を組み合わせると、パイプライン全体のレイテンシ(すべての構成で一定である再生バッファを除く)は、LLMのTTFTとA2Fレイテンシの合計になります。
A2Fレイテンシは、オーディオチャンクがgRPC経由で送信されてから、アバターアニメーション用の対応するブレンドシェイプを受信するまでを測定します。ローカルデプロイではこれは純粋な処理時間ですが、A100ではネットワークのラウンドトリップが含まれます。
A2Fの値は500 msのチャンクに対応します。これは実用的な本番用の値であり、アニメーション開始までの待ち時間を短縮することと、gRPCリクエストのオーバーヘッドを妥当なレベルに抑えることのバランスが取れています。
| LLM | A2F ハードウェア | TTFT LLM | A2F @500 ms | 合計 | 標準偏差 |
|---|---|---|---|---|---|
| Gemini 3.1 Live | RTX 5090 | 1,407 ms | 283 ms | 1,690 ms | ±120 ms |
| Gemini 3.1 Live | A100 (クラウド) | 1,407 ms | 303 ms | 1,710 ms | ±119 ms |
| Gemini 3.1 Live | RTX 4080 Super | 1,407 ms | 325 ms | 1,732 ms | ±120 ms |
| Gemini 3.1 Live | RTX 4070 | 1,407 ms | 637 ms | 2,044 ms | ±122 ms |
| GPT-Realtime | RTX 5090 | 1,731 ms | 283 ms | 2,014 ms | ±401 ms |
| GPT-Realtime-2 | RTX 5090 | 2,176 ms | 283 ms | 2,459 ms | ±128 ms |
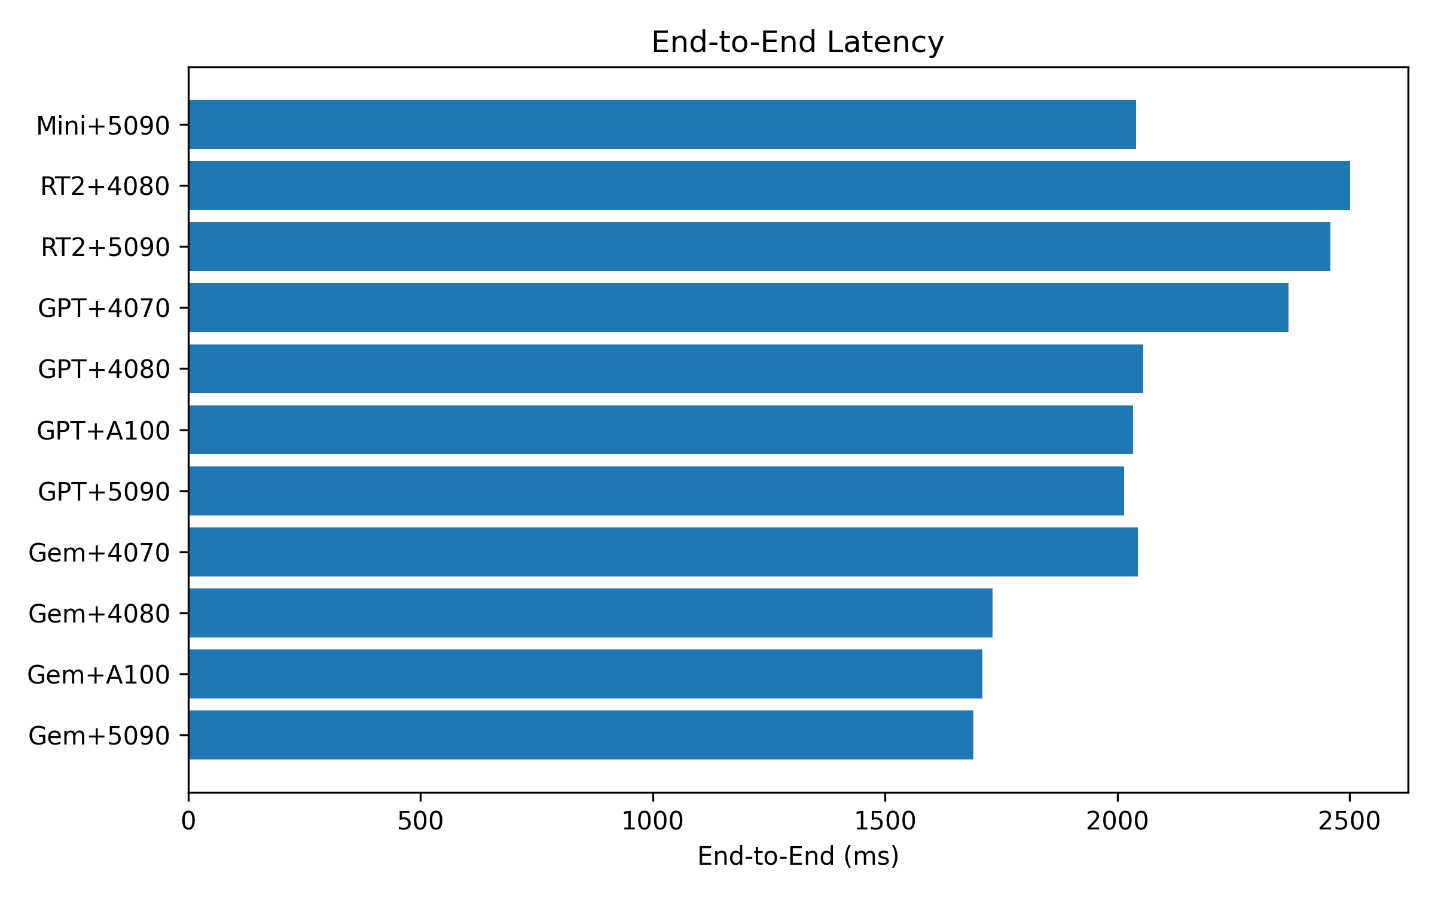
LLMプロバイダーの選択は、ハードウェアの選択よりも大きな影響を与えます。最良モデルと最悪モデル(Gemini対GPT-Realtime-2)の差は約770 msであるのに対し、500 msチャンクにおける最良GPUと最悪GPU(RTX 5090対RTX 4070)の差は約354 msです。一貫性は絶対速度と同様に重要です。Gemini + RTX 5090は±120 msの複合標準偏差を達成しているのに対し、GPT-Realtime + RTX 5090では±401 ms、GPT-Realtime-Miniでは±872 msです。
本番環境への推奨事項
この調査で説明したアーキテクチャの下で、会話型AIモデルとハードウェア構成のさまざまな組み合わせを評価した結果、本番環境へのデプロイに関する推奨事項を確立することが可能です。次の表は、テスト中に得られた総レイテンシと観測された一貫性に基づいて、最も関連性の高い構成をまとめたものです。評価された条件下では、Gemini 3.1 Live + RTX 5090の組み合わせが最高の総合パフォーマンスを達成し、分析されたすべての構成の中で最も低いレイテンシと最高の安定性を提供しました。
| 優先度 | LLM | A2F ハードウェア | 合計レイテンシ | 評価理由 |
|---|---|---|---|---|
| 🥇 最適 | Gemini 3.1 Live | RTX 5090 | 約1,690 ms | 最小のレイテンシと最高のエンドツーエンド一貫性 |
| 🥈 最適なクラウドオプション | Gemini 3.1 Live | A100 (クラウド) | 約1,710 ms | わずか20 msの増加。マルチユーザーシナリオで妥当 |
| 🥉 RTX 5090非搭載 | Gemini 3.1 Live | RTX 4080 Super | 約1,732 ms | 優れたコストパフォーマンス比 |
| ⚠️ 非推奨 | 任意 | RTX 4070 | >2,044 ms | どのチャンク設定でも許容可能なアニメーションレイテンシを提供しない |
| ⚠️ 非推奨 | GPT-RT-Mini | 任意 | 予測不可能 | 標準偏差±873 ms。非常に複雑な質問では最大4.4秒のピーク |
結論
本研究は、リアルタイムアバターにおいて、どの会話AIモデルとAudio2Faceハードウェアの組み合わせが最良の体験を提供するかを、主にレイテンシとその一貫性によって分析するものです。
評価したモデルの中で、Gemini 3.1 Liveが本番環境に最も適しています。平均的に最速であるだけでなく、最も安定しており、質問の複雑さに関係なく常に非常に類似した範囲で応答します。GPTモデルは単純な質問では競争力がありますが、難易度が上がるとレイテンシが増加し、GPT-Realtime-Miniの場合は4秒を超えるピークに達し、会話の自然さを完全に損ないます。
顔のアニメーション用ハードウェアに関して、本研究で使用したGPUの中では、RTX 5090とクラウドA100が非常に類似したパフォーマンスを提供します。RTX 4080 Superは、ユーザーにとって無視できる差の堅実な代替手段です。しかし、RTX 4070はどの設定でも流暢さを損なうレイテンシを導入するため、本番環境には推奨できないという結論に至りました。
推奨される本番環境の組み合わせは、Gemini 3.1 LiveとRTX 5090またはA100であり、合計レイテンシは約1,700 ms、変動は±120 msで、安定した自然な会話体験を保証します。
研究の制限事項
本研究の結果と推奨事項は、以下の制約を念頭に置いて解釈されるべきです。
- シングルユーザー環境。 すべてのテストは単一の同時ユーザーで実施されました。複数の同時負荷がかかる状況(特にA100クラウド設定)でのシステムの動作は評価されておらず、ここに示された値とは大きく異なる可能性があります。
- 制御されていないネットワークレイテンシ。 各プロバイダーのTTFTには、クライアントとモデルのインフラストラクチャ間のネットワークレイテンシが含まれます。GPT-RealtimeはAzure Sweden Centralから提供され、Gemini 3.1 Liveはクライアントの場所に基づくGoogleの自動ルーティングを使用しています。プロバイダー間で観察された差異の一部は、モデル固有のパフォーマンスではなく、この変数に起因する可能性があります。
- 非体系的な品質評価。 応答品質(一貫性、声のトーン、推論能力)に関する観察は定性的なものであり、レイテンシテスト中に収集されました。これらは構造化された品質調査の一部ではなく、各モデルの能力に関する最終的な結論として受け取るべきではありません。
- 同期バッファとレンダリングは除外。 報告された合計レイテンシには、音声とブレンドシェイプ間の同期バッファ、およびEvergineのレンダリング時間は含まれていません。これらのコンポーネントはすべての設定で一定であり、比較には影響しませんが、ユーザーが知覚する実際のレイテンシには影響します。
付録: 使用した質問バンク
| レベル | 質問 |
|---|---|
| 簡単 | こんにちは、お元気ですか? |
| 簡単 | 今、だいたい何時ですか? |
| 簡単 | フランスの首都はどこですか? |
| 簡単 | 1週間は何日ですか? |
| 簡単 | 青と黄色を混ぜると何色になりますか? |
| 中程度 | 人工知能とは何か簡単に説明してください。 |
| 中程度 | ペットとしての犬と猫の主な違いは何ですか? |
| 中程度 | なぜ空は日中、青く見えるのですか? |
| 中程度 | 定期的な運動の利点は何ですか? |
| 中程度 | SSDと従来のハードドライブの違いは何ですか? |
| 複雑 | プログラミングを学んでいます。最初にどの言語をお勧めしますか?また、その理由は? |
| 複雑 | 仕事とゲーム用のコンピューターを購入するために1,500ユーロの予算があります。各コンポーネントにどのように配分しますか? |
| 複雑 | ニューラルネットワークの仕組みを簡単な言葉で段階的に説明してください。 |
| 複雑 | リモートワークとオフィス勤務のメリットとデメリットは何ですか? |
| 複雑 | 1年で英語をゼロから学びたい場合、どのような週間学習計画を提案しますか? |
| 非常に複雑 | 2,500ユーロの予算で日本への10日間の旅行の詳細な計画を立ててください。訪問する都市、推奨交通手段、おおよその予算配分を示してください。 |
| 非常に複雑 | あなたが従業員200名の企業の技術責任者で、全インフラをクラウドに移行したいとします。リスクとダウンタイムを最小限に抑えながら、移行をどのように計画するか段階的に説明してください。 |
| 非常に複雑 | グラフィックスエンジン開発におけるC++、C#、Rust言語を、パフォーマンス、メモリ安全性、開発の容易さ、エコシステムの観点から詳細に比較してください。合理的な推奨事項で締めくくってください。 |
| 非常に複雑 | トランスフォーマーベースのAIモデルが、文章を受け取ってから応答を生成するまでの仕組みを、トークン化、埋め込み、アテンションメカニズム、推論などの概念を説明しながら解説してください。 |
| 非常に複雑 | 自宅から約20メートル離れた洗車場で車を洗おうと思います。歩くべきか、運転すべきか?目的が車を洗うことであり、距離が非常に短いことを考慮して、理由を述べてください。 |
付録: テスト環境
| パラメータ | 値 |
|---|---|
| 測定日 | 2026年7月 |
| Audio2Face バージョン | audio2face-3d:2.0 |
| モデル | gemini-3.1-flash-live-preview, gpt-realtime, gpt-realtime-mini, gpt-realtime-2, gpt-realtime-1.5 |
| RTX 4070 マシン | CPU: 13th Gen Intel(R) Core(TM) i7-13700H, RAM: 32 GB, OS: Windows |
| RTX 4080 Super マシン | CPU: AMD Ryzen 7 7800X3D, RAM: 32 GB, OS: Windows |
| RTX 5090 マシン | CPU: Intel Core i7-14700, RAM: 32 GB, OS: Windows |
| A100 (クラウド) | プロバイダー: Azure Container Apps, リージョン: Sweden Central |