Étude d’un avatar d’IA conversationnelle : comparaison de LLM et d’Audio2Face
Au sein de l’équipe Plain Concepts Research, nous avons consacré plusieurs mois à évaluer les performances d’un système d’avatar conversationnel en temps réel, dans le but d’identifier la configuration la plus adaptée à un environnement de production. Tout au long de cette recherche, nous avons analysé différents modèles d’IA conversationnelle et configurations matérielles, en mesurant des indicateurs tels que la latence, la stabilité des réponses et les performances globales du système. Les résultats nous ont permis d’identifier les composants qui ont le plus d’impact sur l’expérience utilisateur et la combinaison qui offre le meilleur équilibre entre performances et régularité.
Contexte et motivation
L’objectif de ce projet est de développer un avatar conversationnel capable d’interagir vocalement avec les utilisateurs en temps réel. L’avatar écoute l’utilisateur, interprète sa demande à l’aide d’un modèle de langage et répond à la fois par la voix et par des animations faciales synchronisées, afin d’offrir une conversation aussi naturelle que possible. Pour y parvenir, nous devions coordonner différents composants — traitement de la voix, intelligence artificielle, animation faciale et rendu — tout en réduisant au minimum la latence totale du système.
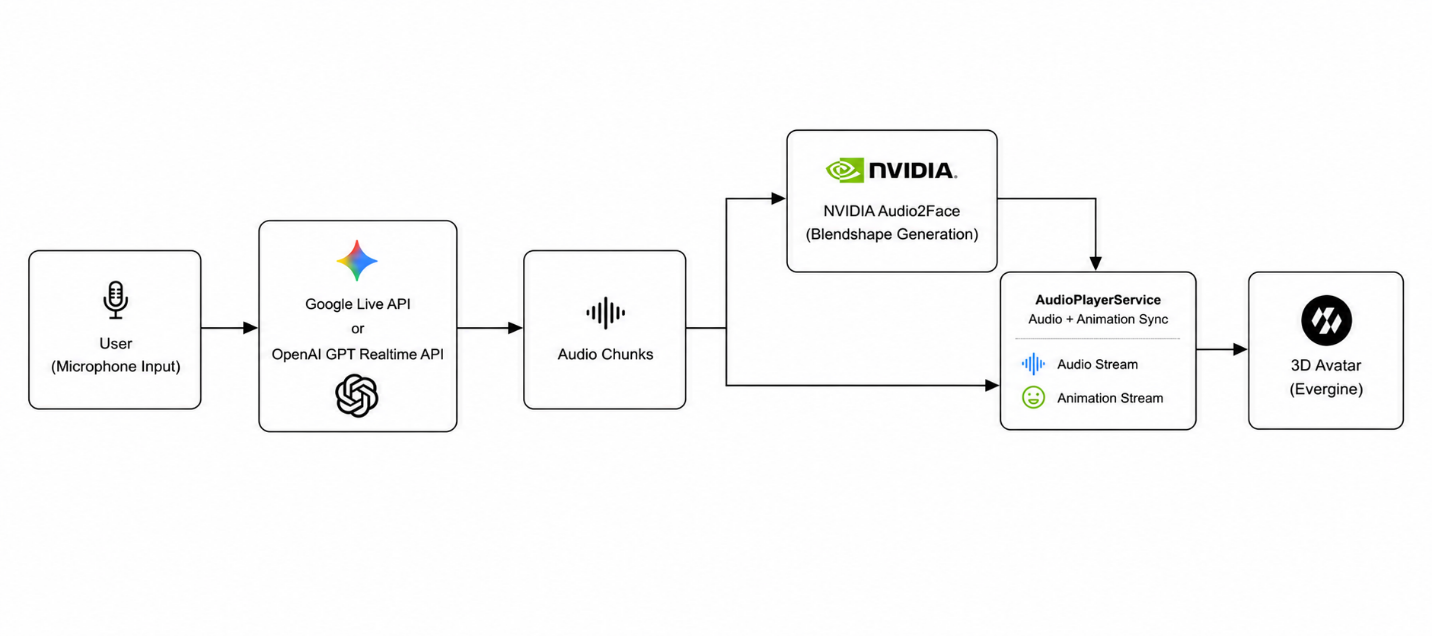
Le pipeline utilisé pendant les tests suit cette séquence : l’utilisateur parle, et un système de détection d’activité vocale (VAD) détecte la fin de son tour de parole. Le LLM (ici, Gemini 3.1 Live ou un modèle GPT Realtime) génère alors une réponse audio. Ces fragments audio sont envoyés simultanément à NVIDIA Audio2Face, qui génère les animations faciales (blendshapes), et au service de lecture audio. Ce service attend de disposer à la fois de l’audio et de l’animation correspondante avant de les lire de manière synchronisée. Enfin, le résultat est rendu sur l’avatar à l’aide du moteur graphique Evergine.
Pour que l’interaction paraisse naturelle, le temps total écoulé entre le moment où l’utilisateur cesse de parler et celui où l’avatar commence à parler et à s’animer doit être aussi court et prévisible que possible. En effet, du point de vue de l’expérience utilisateur, des pics de latence imprévisibles sont plus perceptibles et plus gênants qu’une latence légèrement plus élevée mais stable.
Partie I : comparaison des fournisseurs de LLM
Pour identifier le fournisseur le plus adapté à un environnement de production, nous avons comparé les performances des principaux modèles de langage dotés de capacités de conversation en temps réel. Nous voulions savoir non seulement lequel répondait le plus vite, mais aussi lequel offrait la latence la plus stable et la plus prévisible — un facteur essentiel pour que l’interaction avec l’avatar paraisse naturelle.
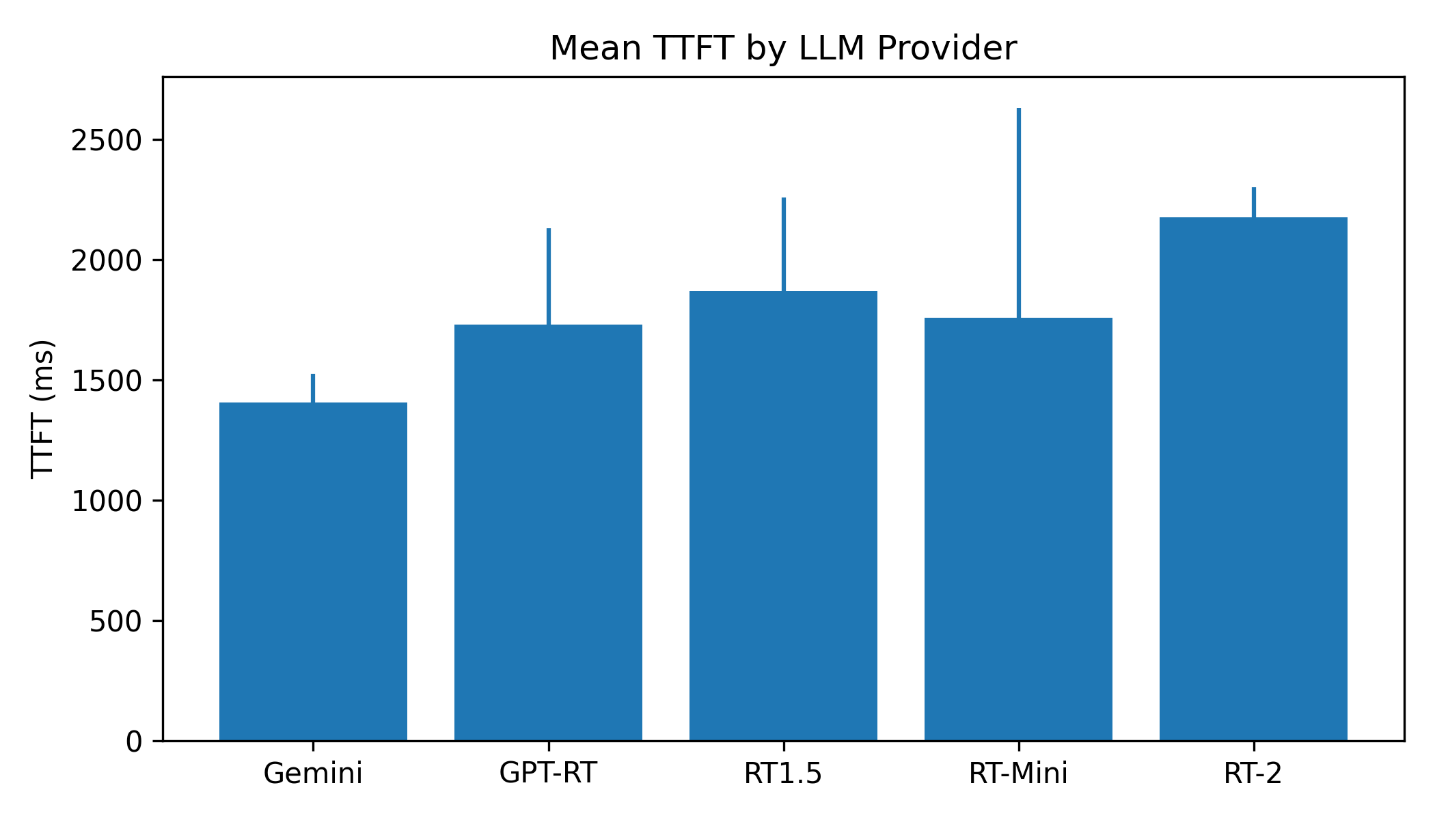
Pour cela, nous avons mesuré le TTFT (Time To First Token) de chaque fournisseur évalué, c’est-à-dire le temps écoulé entre le moment où le VAD du client détecte la fin du tour de parole de l’utilisateur et l’arrivée du premier octet audio généré par le modèle. La méthodologie était identique pour tous les fournisseurs : le même VAD, la même valeur de silence_duration_ms (200 ms) et la même banque de 20 questions classées par niveau de difficulté.
Qu’est-ce que le TTFT et pourquoi est-il important ?
TTFT signifie « Time To First Token » ou, dans le contexte audio, le temps jusqu’au premier octet audio. C’est l’intervalle entre le moment où l’utilisateur cesse de parler et l’arrivée du premier fragment audio de la réponse du modèle de langage. Il n’inclut ni Audio2Face ni le buffer de lecture : il s’agit uniquement du temps de « réflexion » du LLM.
Plus le TTFT est faible, plus le traitement de l’audio peut commencer tôt. Et plus il est stable (écart-type faible), plus l’expérience utilisateur est prévisible.
Bien qu’une autre métrique courante dans l’évaluation des modèles soit le TPOT (Time Per Output Token), cette étude ne l’a pas mesuré car, dans ce scénario, il n’apporte pas d’information pertinente pour l’expérience utilisateur. Une fois le premier fragment audio reçu, le goulot d’étranglement se déplace vers Audio2Face, qui dispose de suffisamment de temps pour traiter les fragments suivants au fur et à mesure de leur arrivée. Le TTFT est donc la métrique qui représente le mieux la réactivité perçue du système.
Méthodologie
Tous les fournisseurs ont été mesurés dans les mêmes conditions afin de garantir des résultats comparables :
- Détecteur d’activité vocale (VAD) : le même détecteur acoustique dans tous les cas, basé sur le niveau du signal (RMS), avec un seuil de 0.01 et une fenêtre de confirmation de 150 ms. Il se déclenche lorsque l’utilisateur cesse de parler.
- Silence serveur : 200 ms pour tous les fournisseurs, soit le temps supplémentaire que le serveur attend avant d’envoyer la requête au LLM.
- Questions de test : 20 questions réparties en quatre niveaux de difficulté (5 faciles, 5 moyennes, 5 complexes, 5 très complexes), plus 1 question d’échauffement exclue de l’analyse.
Chacune des 20 questions a été exécutée une fois par fournisseur, en enregistrant le TTFT obtenu. Les métriques agrégées (moyenne, écart-type, minimum et maximum) ont été calculées à partir de l’ensemble des 20 mesures par modèle.
Les questions ont été classées selon l’effort de raisonnement attendu du modèle. Les questions faciles correspondent à des salutations ou à des connaissances générales simples ; les questions moyennes demandent de brèves explications ; les questions complexes impliquent un raisonnement ou l’élaboration de recommandations ; et les questions très complexes exigent des réponses détaillées avec planification, comparaison ou explication approfondie de concepts.
La liste complète figure en annexe : Banque de questions utilisée.
Région de déploiement : GPT Realtime est servi depuis la région Azure Sweden Central. Gemini Live n’expose pas de région fixe : Google route automatiquement les requêtes.
| Fournisseur | Moyenne | Écart-type | Min. | Max. |
|---|---|---|---|---|
| Gemini 3.1 Live | 1 407 ms | ±118 ms | 1 191 ms | 1 626 ms |
| GPT-Realtime | 1 731 ms | ±399 ms | 834 ms | 2 783 ms |
| GPT-Realtime 1.5 | 1 869 ms | ±389 ms | 1 263 ms | 2 857 ms |
| GPT-Realtime-Mini | 1 758 ms | ±872 ms | 1 045 ms | 4 446 ms |
| GPT-Realtime-2 | 2 232 ms | ±126 ms | 1 931 ms | 2 523 ms |
Latence selon le niveau de difficulté
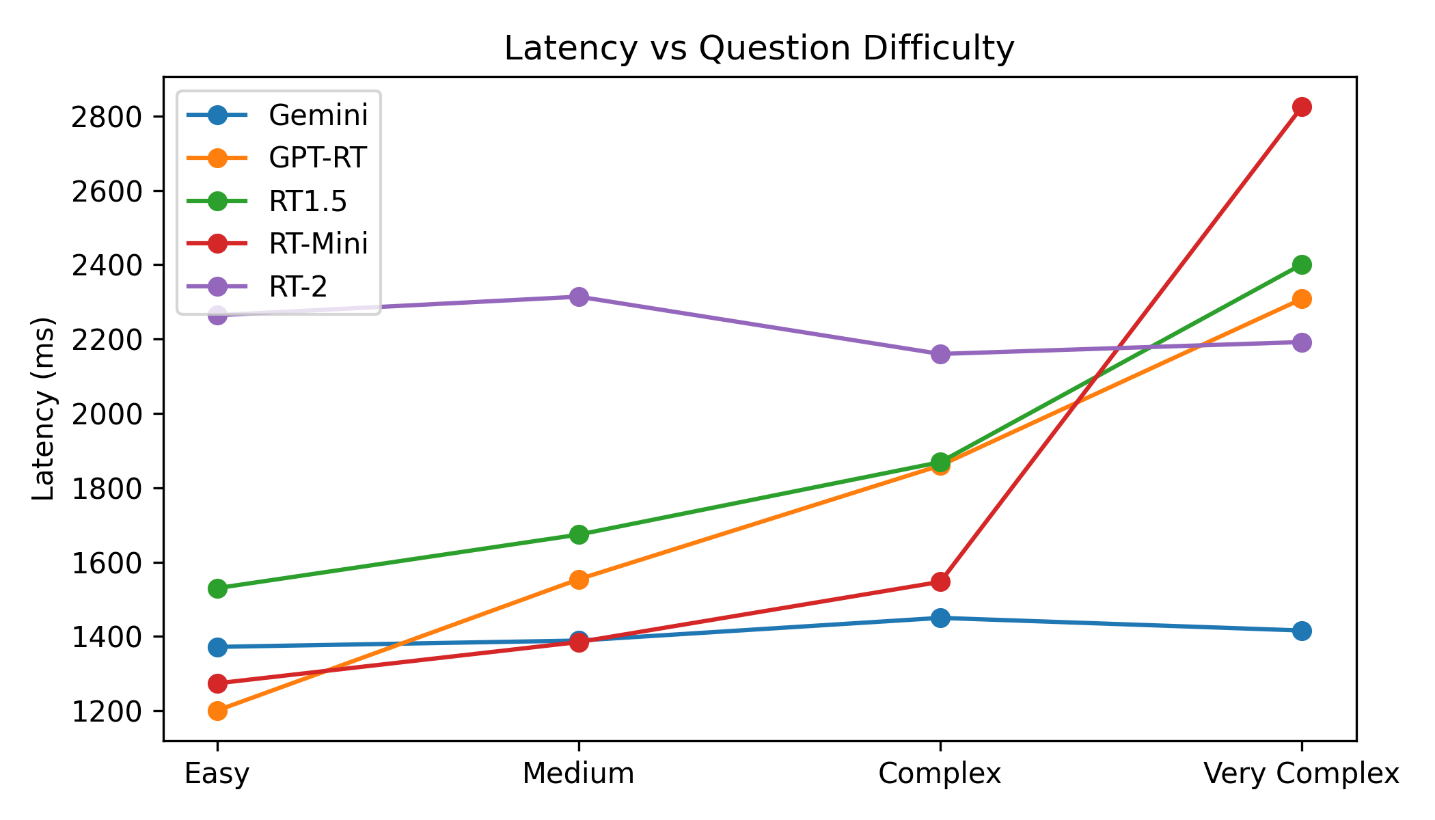
Le constat le plus marquant concerne le comportement de chaque modèle à mesure que la complexité augmente. Gemini 3.1 Live conserve une latence quasi constante (~1 400 ms) quelle que soit la difficulté. Les modèles GPT, en revanche, augmentent nettement : GPT-Realtime passe de 1 201 ms sur les questions faciles à 2 308 ms sur les questions très complexes.
Remarque : GPT-Realtime a été déployé dans la région Azure Sweden Central, tandis que Gemini 3.1 Live utilise le routage automatique de l’infrastructure de Google. Par conséquent, une partie des différences de TTFT observées peut être influencée par la latence réseau entre le client et l’infrastructure de chaque fournisseur.
| Difficulté | Gemini 3.1 Live | GPT-Realtime | GPT-Realtime 1.5 | GPT-Realtime Mini | GPT-Realtime 2 |
|---|---|---|---|---|---|
| Facile | 1 372 ms | 1 201 ms | 1 530 ms | 1 274 ms | 2 264 ms |
| Moyenne | 1 389 ms | 1 554 ms | 1 674 ms | 1 385 ms | 2 314 ms |
| Complexe | 1 450 ms | 1 860 ms | 1 869 ms | 1 547 ms | 2 160 ms |
| Très complexe | 1 416 ms | 2 308 ms | 2 401 ms | 2 825 ms | 2 192 ms |
Principaux résultats
Gemini est le plus rapide et le plus régulier. Avec une moyenne de 1 407 ms et un écart type de seulement ±118 ms, Gemini 3.1 Live est le fournisseur le plus prévisible. Il répond systématiquement dans la même plage, quelle que soit la question posée.
La latence de Gemini n’augmente PAS avec la complexité. Question facile : 1 372 ms. Question très complexe : 1 416 ms. L’écart n’est que de 44 ms, soit pratiquement du bruit statistique. Cela suggère que le modèle Gemini 3.1 Live est optimisé pour une latence constante, et non pour consacrer davantage de temps au raisonnement selon la difficulté. Pendant les tests, aucune différence notable de qualité de réponse n’a été observée qui justifierait cette latence constante.
Le résultat le plus intéressant n’est pas de savoir qui est le plus rapide, mais que Gemini présente une latence constante quelle que soit la complexité, alors que GPT ajuste son temps de raisonnement à la difficulté.
GPT-Realtime est le plus rapide sur les questions faciles. Sur les questions simples, GPT-Realtime atteint 1 201 ms, soit plus vite que Gemini. Le problème apparaît avec la complexité : sur les questions très complexes, il monte à 2 308 ms, presque le double. Cela indique qu’il consacre d’autant plus de temps au raisonnement que la question est difficile.
GPT-Realtime-Mini présente de fortes valeurs aberrantes. Deux questions très complexes font grimper sa latence à 4 446 ms et 3 781 ms. Avec un écart type de ±872 ms, c’est le plus imprévisible de tous : il n’est pas recommandé en production pour des questions complexes.
Qualité des réponses. Au-delà de la latence, des différences qualitatives ont été observées entre les modèles :
- Gemini : le seul fournisseur qui donne une heure plausible lorsqu’on la lui demande. Il conserve une voix et un ton cohérents tout au long de la conversation.
- GPT-Realtime, 1.5, 2 : refusent de donner l’heure (probablement faute d’accès à l’horloge système). Des changements de voix inattendus ont également été détectés pendant la conversation : à certains moments, l’assistant modifiait sensiblement le timbre ou l’intonation de sa voix, ressemblant parfois à une voix du sexe opposé. Ces changements rompaient le sentiment de continuité de l’interaction.
- GPT-Realtime-Mini : échoue au raisonnement pratique. À la question de savoir s’il vaut mieux aller à pied ou en voiture à une station de lavage située à 20 mètres de chez soi, il a suggéré d’y aller en voiture. C’est le seul modèle à avoir mal répondu.
Ces observations sont qualitatives et reposent sur l’expérience acquise pendant les tests. Elles ne font pas partie d’une étude de qualité systématique, mais elles sont pertinentes pour la décision de mise en production.
Partie II : comparaison matérielle pour Audio2Face
Une fois que le LLM a généré la réponse audio, cet audio doit être converti en animations faciales : mouvement des lèvres, des joues, des sourcils, le tout en temps réel. NVIDIA Audio2Face (A2F) est le système qui réalise cette conversion en produisant des « blendshapes », des instructions numériques qui indiquent précisément dans quelle mesure chaque muscle du visage de l’avatar bouge à chaque instant.
Audio2Face est le composant le plus coûteux en calcul après le LLM. Il peut s’exécuter de deux façons :
- Local (Docker) : le modèle s’exécute sur le GPU de l’ordinateur de l’utilisateur. Latence minimale (tout est local), mais cela exige du matériel dédié et ne passe pas à l’échelle pour plusieurs utilisateurs.
- Cloud (Azure Container App) : le modèle s’exécute sur un GPU A100 dans le cloud. Cela ajoute de la latence réseau (~10–20 ms par chunk). Bien que ce type d’architecture soit conçu pour des scénarios multi-utilisateurs, aucun test de concurrence n’a été réalisé dans cette étude ; sa capacité de montée en charge n’a donc pas été évaluée.
Qu’est-ce qu’un chunk audio ?
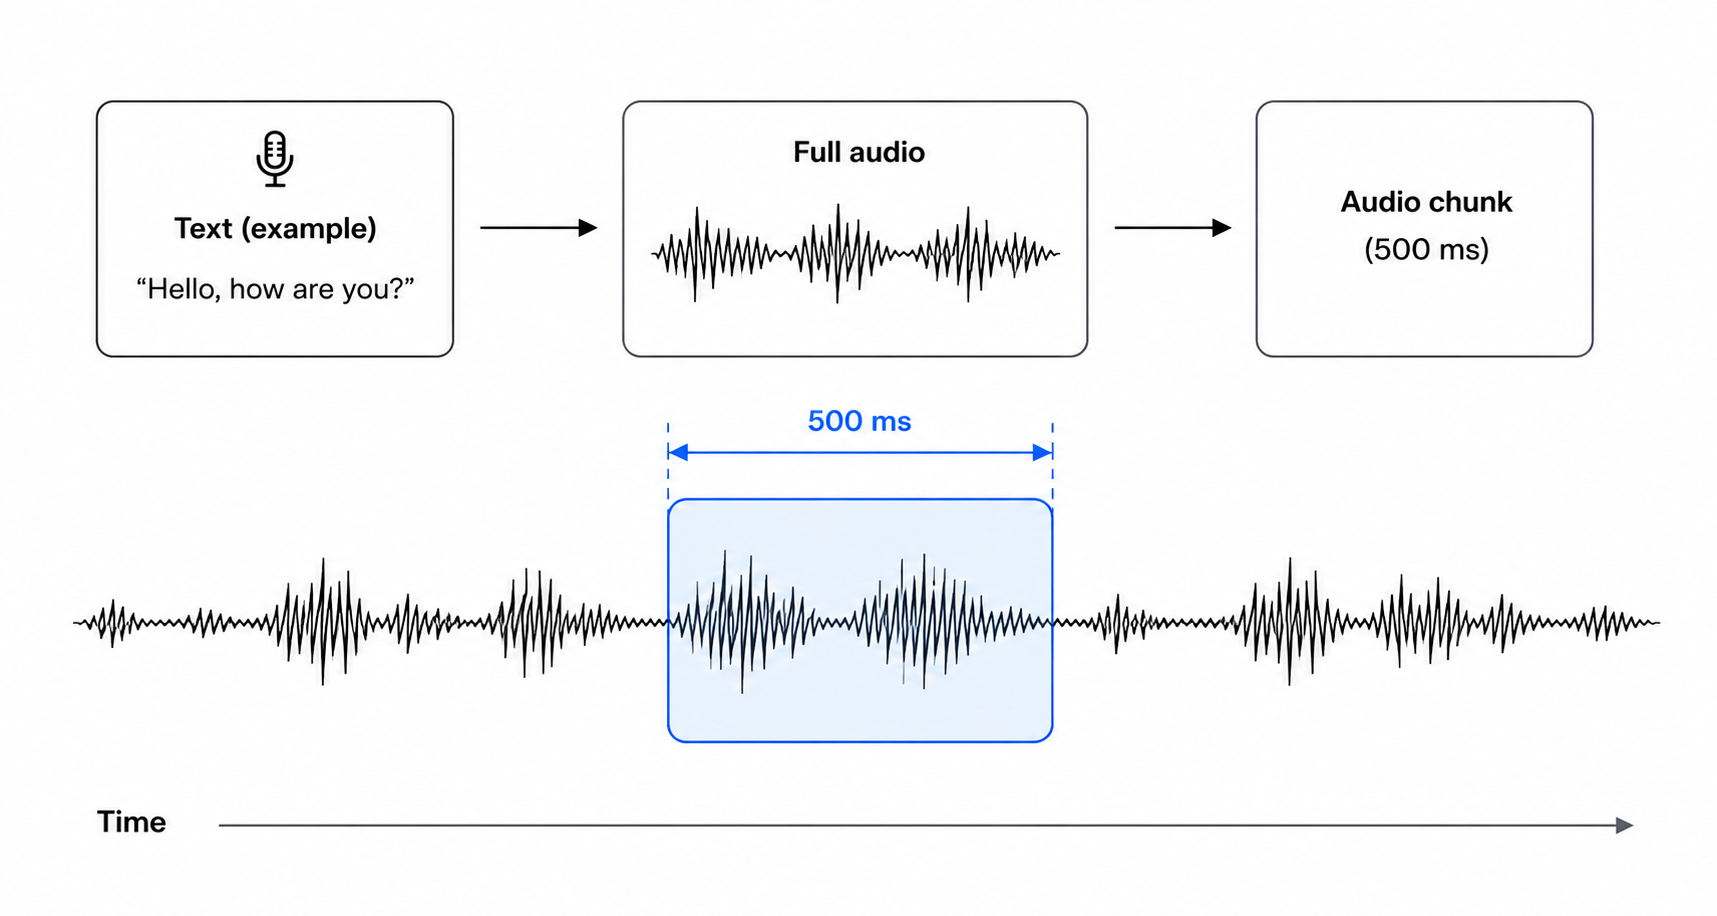
NVIDIA Audio2Face ne traite pas l’audio complet en une seule fois : il le reçoit découpé en petits fragments (chunks) envoyés en continu via gRPC. Chaque chunk contient quelques centaines de millisecondes d’audio et, dès qu’Audio2Face en reçoit un, il commence à générer les animations faciales correspondantes sans attendre la fin de la phrase.
La taille des chunks représente un compromis entre latence et efficacité : des chunks plus petits permettent de démarrer plus tôt l’animation de l’avatar, mais augmentent le nombre de requêtes et la surcharge de traitement. À l’inverse, des chunks plus grands réduisent cette surcharge mais obligent à attendre plus longtemps avant que l’animation puisse commencer.
Méthodologie
- Environnements de test : RTX 4070 (portable, Docker local), RTX 4080 Super (poste fixe, Docker local), RTX 5090 (poste fixe, Docker local) et NVIDIA A100 (Azure Container App). La liste détaillée du matériel figure dans l’Annexe : environnements de test.
- Conception de l’étude : balayage de 25 tailles de chunk (de 300 ms à 1 500 ms par pas de 50 ms), avec 5 chunks par pas (125 chunks au total par environnement). Le canal gRPC est réutilisé pour éliminer la surcharge de connexion.
| Chunk | RTX 4070 | RTX 4080 Super | RTX 5090 | A100 (cloud) | 4070→5090 | A100→5090 |
|---|---|---|---|---|---|---|
| 300 ms | 596 ms | 249 ms | 225 ms | 237 ms | 2.65× | 1.05× |
| 500 ms | 637 ms | 325 ms | 283 ms | 303 ms | 2.25× | 1.07× |
| 750 ms | 1 162 ms | 421 ms | 386 ms | 400 ms | 3.01× | 1.04× |
| 1 000 ms | 1 240 ms | 495 ms | 455 ms | 476 ms | 2.73× | 1.05× |
| 1 500 ms | 1 882 ms | 676 ms | 613 ms | 662 ms | 3.07× | 1.08× |
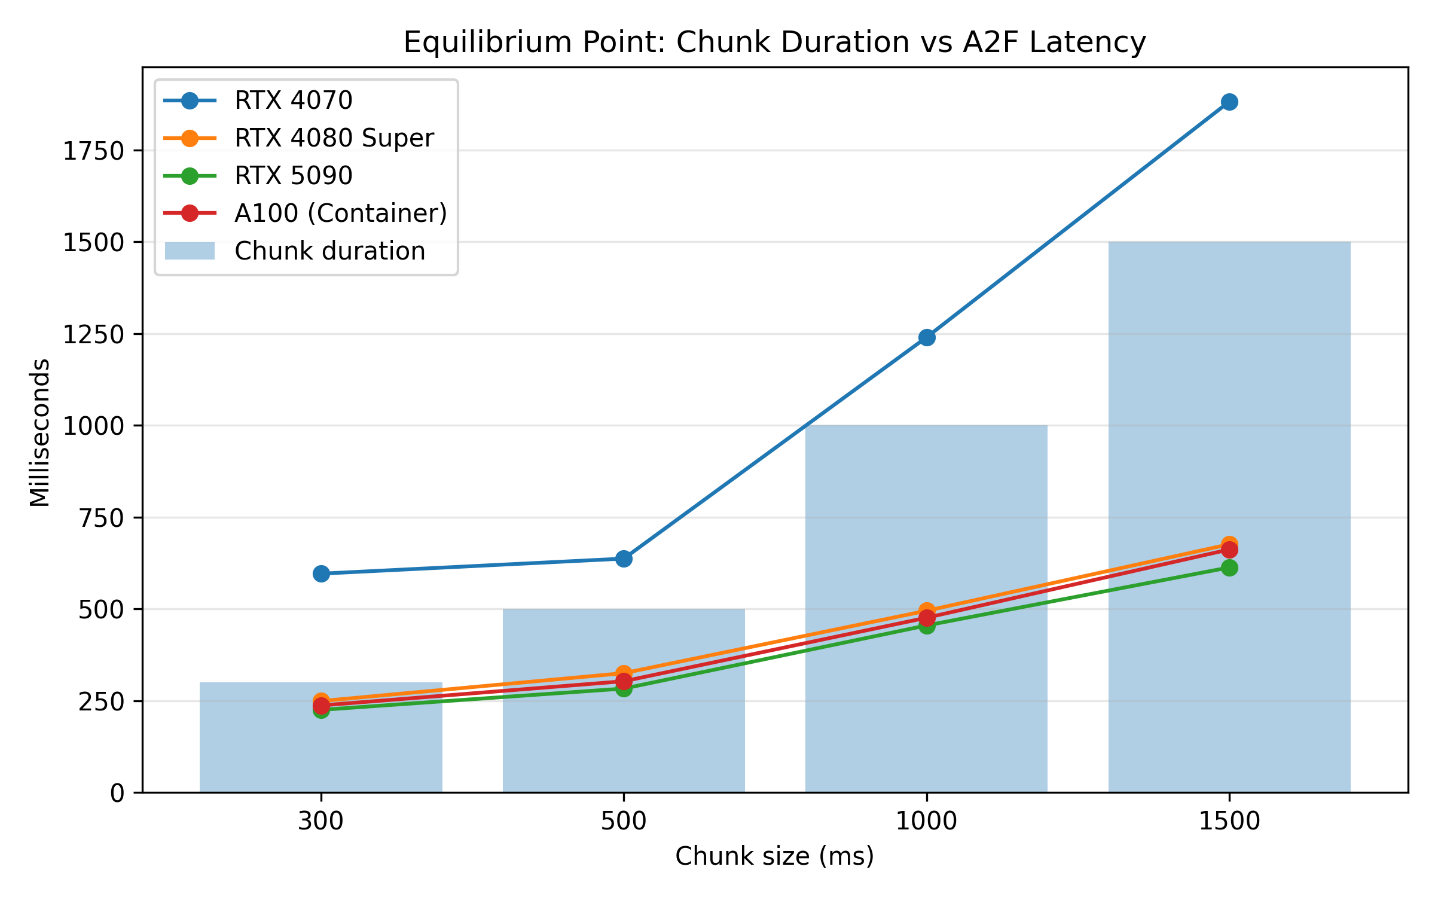
La RTX 5090 obtient la latence la plus faible pour toutes les tailles de chunk. Toutefois, l’écart avec la RTX 4080 Super est relativement faible (24 à 63 ms lors des tests réalisés), de sorte que l’impact sur la latence totale du système reste limité. Du point de vue de la latence, les deux GPU offrent donc un comportement très similaire.
Quant au NVIDIA A100 déployé sur Azure Container Apps, ses performances sont elles aussi très proches de celles de la RTX 5090, avec une légère latence supplémentaire imputable à la communication réseau. Ce type de déploiement constitue une alternative pour les architectures où Audio2Face s’exécute de manière centralisée. Cette étude se limite toutefois à l’analyse de la latence et n’évalue pas des aspects tels que le coût d’exploitation ou les performances sous charge concurrente.
Partie III : analyse de la latence combinée LLM + A2F
En combinant les deux études, la latence totale du pipeline (hors buffer de lecture, constant pour toutes les configurations) correspond à la somme du TTFT du LLM et de la latence d’A2F.
La latence d’A2F est mesurée entre l’envoi d’un chunk audio via gRPC et la réception des blendshapes correspondants pour l’animation de l’avatar. Dans les déploiements locaux, il s’agit de temps de traitement pur, tandis que sur l’A100 elle inclut l’aller-retour réseau.
Les valeurs d’A2F correspondent à un chunk de 500 ms, la valeur pratique retenue en production : c’est un bon équilibre entre la réduction de l’attente avant le début de l’animation et le maintien de la surcharge des requêtes gRPC à un niveau raisonnable.
| LLM | Matériel A2F | TTFT LLM | A2F à 500 ms | Total | Écart-type |
|---|---|---|---|---|---|
| Gemini 3.1 Live | RTX 5090 | 1 407 ms | 283 ms | 1 690 ms | ±120 ms |
| Gemini 3.1 Live | A100 (cloud) | 1 407 ms | 303 ms | 1 710 ms | ±119 ms |
| Gemini 3.1 Live | RTX 4080 Super | 1 407 ms | 325 ms | 1 732 ms | ±120 ms |
| Gemini 3.1 Live | RTX 4070 | 1 407 ms | 637 ms | 2 044 ms | ±122 ms |
| GPT-Realtime | RTX 5090 | 1 731 ms | 283 ms | 2 014 ms | ±401 ms |
| GPT-Realtime-2 | RTX 5090 | 2 176 ms | 283 ms | 2 459 ms | ±128 ms |
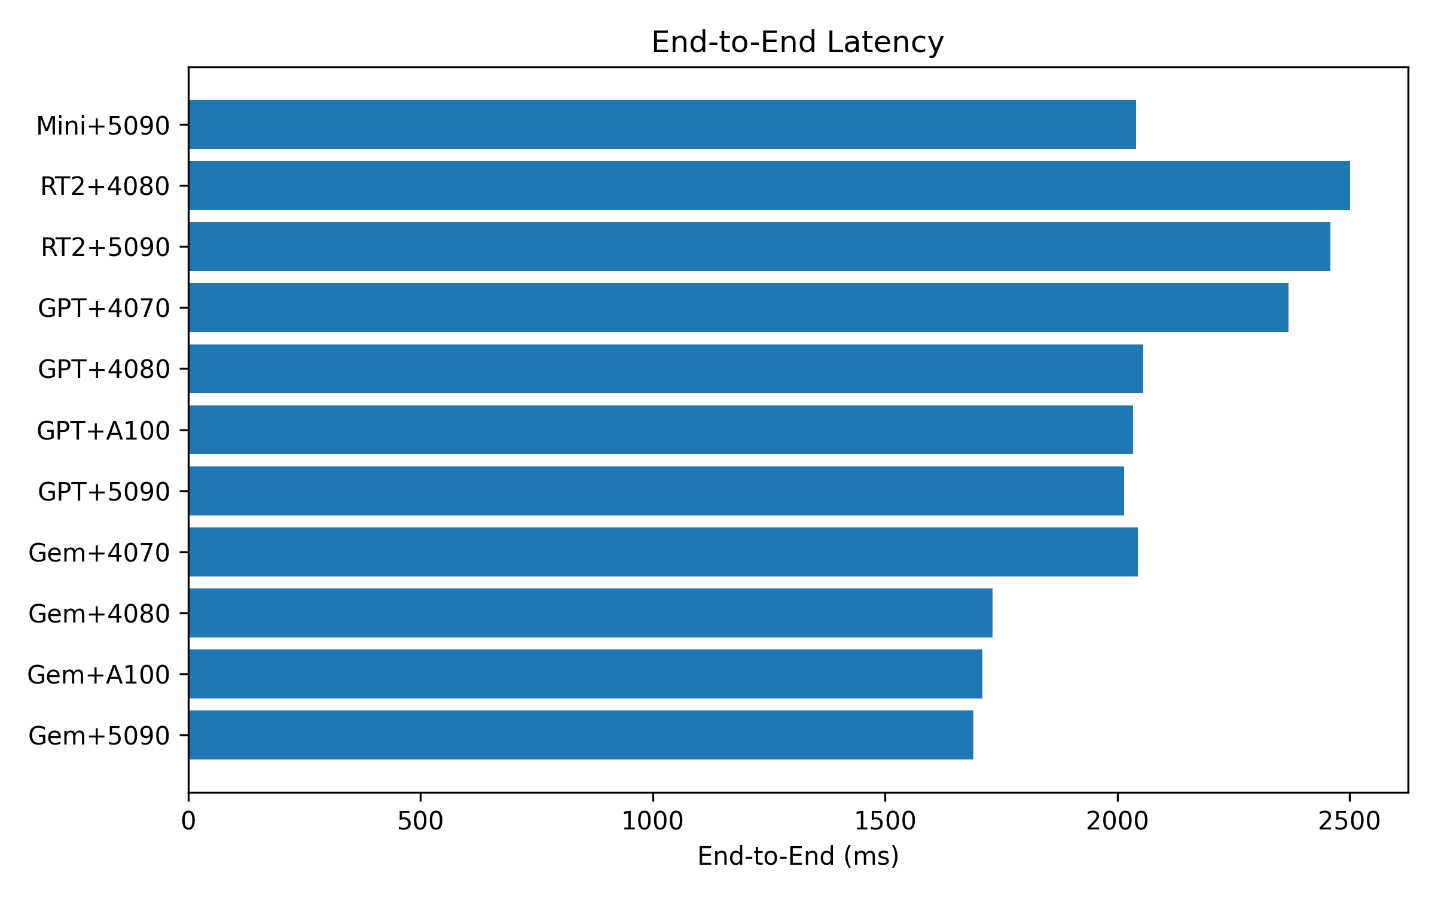
Le choix du fournisseur de LLM a plus d’impact que le choix du matériel : l’écart entre le meilleur et le moins bon modèle (Gemini vs GPT-Realtime-2) est d’environ 770 ms, contre environ 354 ms entre le meilleur et le moins bon GPU (RTX 5090 vs RTX 4070) avec un chunk de 500 ms. La régularité compte autant que la vitesse absolue : Gemini + RTX 5090 atteint un écart type combiné de ±120 ms, contre ±401 ms pour GPT-Realtime + RTX 5090 et ±872 ms pour GPT-Realtime-Mini.
Recommandations pour la production
Après avoir évalué les différentes combinaisons de modèles d’IA conversationnelle et de configurations matérielles dans l’architecture décrite dans cette étude, il est possible d’établir une recommandation pour un déploiement en environnement de production. Le tableau suivant résume les configurations les plus pertinentes selon la latence totale obtenue et la régularité observée pendant les tests. Dans les conditions évaluées, la combinaison Gemini 3.1 Live + RTX 5090 a obtenu les meilleures performances globales, avec la latence la plus faible et la plus grande stabilité de toutes les configurations analysées.
| Priorité | LLM | Matériel A2F | Latence totale | Justification |
|---|---|---|---|---|
| 🥇 Optimal | Gemini 3.1 Live | RTX 5090 | ~1 690 ms | Latence la plus faible et meilleure régularité de bout en bout |
| 🥈 Meilleure option cloud | Gemini 3.1 Live | A100 (cloud) | ~1 710 ms | Seulement 20 ms de plus ; justifié pour les scénarios multi-utilisateurs |
| 🥉 Sans RTX 5090 | Gemini 3.1 Live | RTX 4080 Super | ~1 732 ms | Excellent rapport coût/performances |
| ⚠️ Non recommandé | Tous | RTX 4070 | >2 044 ms | N’offre une latence d’animation acceptable dans aucune configuration de chunk |
| ⚠️ Non recommandé | GPT-RT-Mini | Tous | Imprévisible | Écart type de ±873 ms ; pics jusqu’à 4,4 s sur les questions très complexes |
Conclusions
Cette étude analyse quelle combinaison de modèle d’IA conversationnelle et de matériel Audio2Face offre la meilleure expérience pour un avatar en temps réel, mesurée principalement à travers la latence et sa régularité.
Parmi les modèles évalués, Gemini 3.1 Live est le plus adapté à la production : non seulement il est le plus rapide en moyenne, mais il est aussi le plus stable, répondant toujours dans une plage très similaire quelle que soit la complexité de la question. Les modèles GPT sont compétitifs sur les questions simples, mais leur latence augmente avec la difficulté et, dans le cas de GPT-Realtime-Mini, atteint des pics de plus de 4 secondes qui brisent complètement le naturel de la conversation.
En ce qui concerne le matériel d’animation faciale, parmi les GPU utilisés dans cette étude, la RTX 5090 et l’A100 dans le cloud offrent des performances très similaires. La RTX 4080 Super est une alternative solide, avec une différence négligeable pour l’utilisateur. La RTX 4070, en revanche, introduit une latence qui nuit à la fluidité dans toutes les configurations ; elle n’est donc pas recommandée pour la production.
La combinaison recommandée pour la production est Gemini 3.1 Live avec une RTX 5090 ou un A100, avec une latence combinée d’environ 1 700 ms et une variabilité de ±120 ms, garantissant une expérience conversationnelle stable et naturelle.
Limites de l’étude
Les résultats et recommandations de cette étude doivent être interprétés en tenant compte des contraintes suivantes :
- Environnement mono-utilisateur. Tous les tests ont été réalisés avec un seul utilisateur simultané. Le comportement du système sous une charge concurrente multiple (en particulier dans la configuration A100 dans le cloud) n’a pas été évalué et peut différer sensiblement des valeurs présentées ici.
- Latence réseau non contrôlée. Le TTFT de chaque fournisseur inclut la latence réseau entre le client et l’infrastructure du modèle. GPT-Realtime était servi depuis Azure Sweden Central, tandis que Gemini 3.1 Live utilise le routage automatique de Google en fonction de la localisation du client. Une partie des différences observées entre fournisseurs peut être due à cette variable et non aux performances intrinsèques du modèle.
- Évaluation de la qualité non systématique. Les observations sur la qualité des réponses (cohérence, ton de voix, capacité de raisonnement) sont qualitatives et ont été recueillies pendant les tests de latence. Elles ne font pas partie d’une étude de qualité structurée et ne doivent pas être considérées comme des conclusions définitives sur les capacités de chaque modèle.
- Buffer de synchronisation et rendu exclus. La latence totale indiquée n’inclut ni le buffer de synchronisation entre l’audio et les blendshapes, ni le temps de rendu d’Evergine. Ces deux composants sont constants d’une configuration à l’autre et n’affectent pas la comparaison, mais ils influent sur la latence réellement perçue par l’utilisateur.
Annexe : banque de questions utilisée
| Niveau | Question |
|---|---|
| Facile | Bonjour, comment allez-vous ? |
| Facile | Quelle heure est-il approximativement ? |
| Facile | Quelle est la capitale de la France ? |
| Facile | Combien y a-t-il de jours dans une semaine ? |
| Facile | Quelle couleur obtient-on en mélangeant du bleu et du jaune ? |
| Moyenne | Expliquez brièvement ce qu’est l’intelligence artificielle. |
| Moyenne | Quelles sont les principales différences entre un chien et un chat comme animal de compagnie ? |
| Moyenne | Pourquoi le ciel paraît-il bleu pendant la journée ? |
| Moyenne | Quels sont les bienfaits d’une activité physique régulière ? |
| Moyenne | Quelles sont les différences entre un SSD et un disque dur traditionnel ? |
| Complexe | J’apprends la programmation. Par quel langage me conseilleriez-vous de commencer, et pourquoi ? |
| Complexe | J’ai un budget de 1 500 € pour acheter un ordinateur pour le travail et le jeu. Comment le répartiriez-vous entre les différents composants ? |
| Complexe | Expliquez étape par étape, en termes simples, comment fonctionne un réseau de neurones. |
| Complexe | Quels sont les avantages et les inconvénients du télétravail par rapport au travail en présentiel ? |
| Complexe | Si je voulais apprendre l’anglais à partir de zéro en un an, quel programme d’étude hebdomadaire me proposeriez-vous ? |
| Très complexe | Concevez un plan détaillé pour un voyage de 10 jours au Japon avec un budget de 2 500 €, en indiquant les villes à visiter, les transports recommandés et la répartition approximative du budget. |
| Très complexe | Imaginez que vous êtes le responsable technique d’une entreprise de 200 salariés qui souhaite migrer toute son infrastructure vers le cloud. Expliquez étape par étape comment vous planifieriez la migration en minimisant les risques et les interruptions de service. |
| Très complexe | Comparez en profondeur les langages C++, C# et Rust pour le développement de moteurs graphiques, en analysant les performances, la sécurité mémoire, la facilité de développement et l’écosystème. Concluez par une recommandation argumentée. |
| Très complexe | Expliquez comment fonctionne un modèle d’IA basé sur les transformers, de la réception d’une phrase jusqu’à la génération d’une réponse, en décrivant des notions telles que la tokenisation, les embeddings, le mécanisme d’attention et l’inférence. |
| Très complexe | Je vais laver ma voiture dans une station de lavage située à environ 20 mètres de chez moi. Pensez-vous que je devrais y aller à pied ou en voiture ? Argumentez votre réponse en tenant compte du fait que l’objectif est de laver la voiture et que la distance est très courte. |
Annexe : environnements de test
| Paramètre | Valeur |
|---|---|
| Date de mesure | Juillet 2026 |
| Version d’Audio2Face | audio2face-3d:2.0 |
| Modèles | gemini-3.1-flash-live-preview, gpt-realtime, gpt-realtime-mini, gpt-realtime-2, gpt-realtime-1.5 |
| Machine RTX 4070 | CPU : 13th Gen Intel(R) Core(TM) i7-13700H, RAM : 32 Go, OS : Windows |
| Machine RTX 4080 Super | CPU : AMD Ryzen 7 7800X3D, RAM : 32 Go, OS : Windows |
| Machine RTX 5090 | CPU : Intel Core i7-14700, RAM : 32 Go, OS : Windows |
| A100 (cloud) | Fournisseur : Azure Container Apps, région : Sweden Central |