Studie zu Conversational-AI-Avataren: Vergleich von LLMs und Audio2Face
Im Research-Team von Plain Concepts haben wir mehrere Monate lang die Performance eines dialogfähigen Echtzeit-Avatarsystems evaluiert, um die am besten geeignete Konfiguration für eine Produktivumgebung zu ermitteln. Im Rahmen dieser Untersuchung haben wir verschiedene Conversational-AI-Modelle und Hardwarekonfigurationen analysiert und Kennzahlen wie Latenz, Stabilität der Antworten und Gesamtperformance des Systems gemessen. Anhand der Ergebnisse konnten wir feststellen, welche Komponenten den größten Einfluss auf das Benutzererlebnis haben und welche Kombination das beste Gleichgewicht zwischen Performance und Konstanz bietet.
Kontext und Motivation
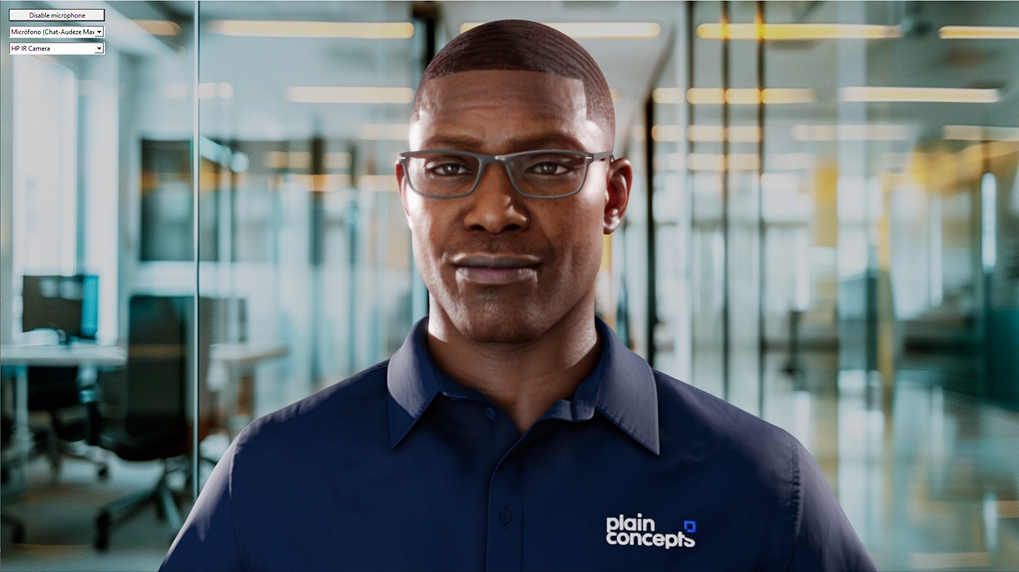
Ziel dieses Projekts ist die Entwicklung eines dialogfähigen Avatars, der in Echtzeit per Sprache mit Benutzern interagieren kann. Der Avatar hört dem Benutzer zu, interpretiert seine Anfrage mithilfe eines Sprachmodells und antwortet sowohl mit Sprache als auch mit synchronisierten Gesichtsanimationen, um ein möglichst natürliches Gespräch zu ermöglichen. Dazu mussten wir verschiedene Komponenten – Sprachverarbeitung, künstliche Intelligenz, Gesichtsanimation und Rendering – aufeinander abstimmen und gleichzeitig die Gesamtlatenz des Systems minimieren.
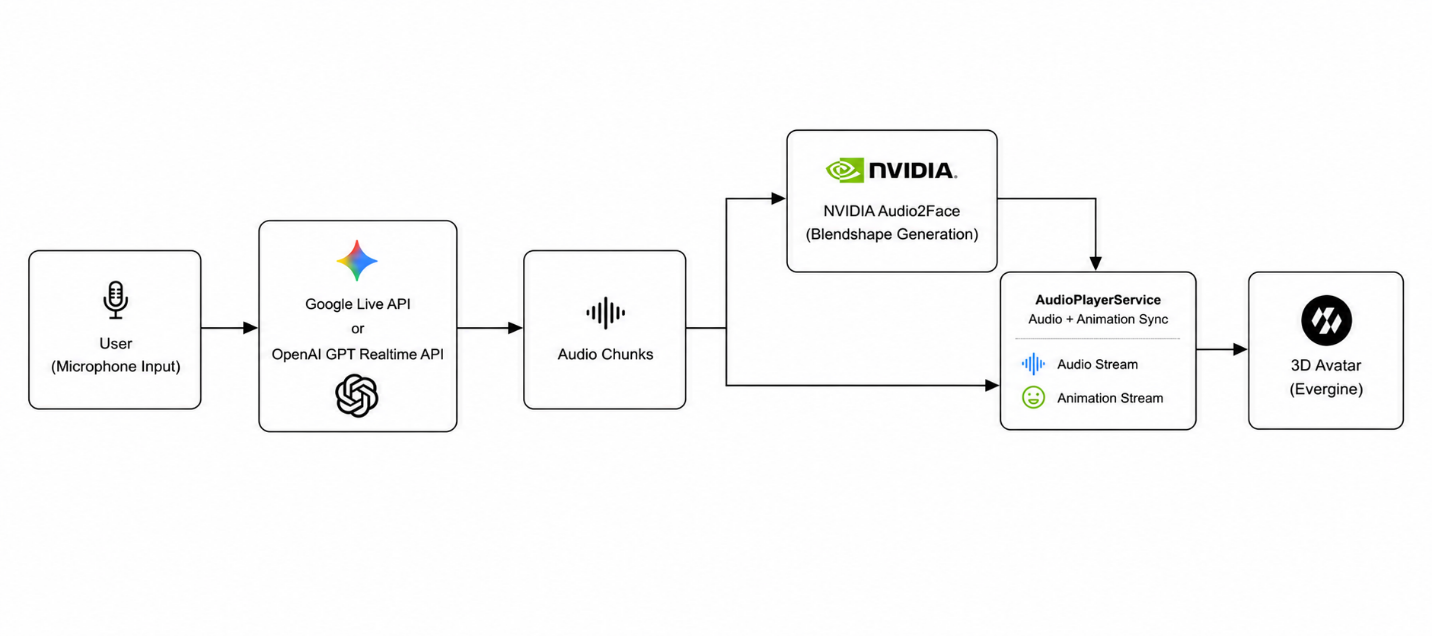
Die in den Tests verwendete Pipeline folgt diesem Ablauf: Der Benutzer spricht, und ein Voice-Activity-Detection-System (VAD) erkennt das Ende seines Redebeitrags. Das LLM (in diesem Fall Gemini 3.1 Live oder ein GPT-Realtime-Modell) erzeugt daraufhin eine Audioantwort. Diese Audio-Chunks werden gleichzeitig an NVIDIA Audio2Face, das die Gesichtsanimationen (Blendshapes) erzeugt, und an den Audiowiedergabedienst gesendet. Der Wiedergabedienst wartet, bis sowohl das Audio als auch die zugehörige Animation vorliegen, und gibt beide dann synchron wieder. Abschließend wird das Ergebnis mit der Grafik-Engine Evergine auf dem Avatar gerendert.
Damit sich die Interaktion natürlich anfühlt, muss die Zeitspanne zwischen dem Ende der Benutzeräußerung und dem Moment, in dem der Avatar zu sprechen und sich zu bewegen beginnt, so kurz und vorhersehbar wie möglich sein. Aus Sicht des Benutzererlebnisses sind unvorhersehbare Latenzspitzen sogar auffälliger und störender als eine etwas höhere, aber stabile Latenz.
Teil I: Vergleich der LLM-Anbieter
Um den am besten geeigneten Anbieter für eine Produktivumgebung zu ermitteln, haben wir die Performance der führenden Sprachmodelle mit Echtzeit-Dialogfunktionen verglichen. Uns interessierte nicht nur, welches am schnellsten antwortet, sondern auch, welches die stabilste und vorhersehbarste Latenz bietet – ein entscheidender Faktor dafür, dass sich die Interaktion mit dem Avatar natürlich anfühlt.
Dazu haben wir die TTFT (Time To First Token) jedes evaluierten Anbieters gemessen – also die Zeit zwischen dem Moment, in dem die VAD des Clients das Ende des Redebeitrags erkennt, und dem Eintreffen des ersten vom Modell erzeugten Audio-Bytes. Die Methodik war für alle Anbieter identisch: dieselbe VAD, derselbe silence_duration_ms-Wert (200 ms) und derselbe Katalog mit 20 nach Schwierigkeitsgrad geordneten Fragen.
Was ist TTFT und warum ist sie wichtig?
TTFT steht für “Time To First Token” bzw. im Audiokontext für die Zeit bis zum ersten Audio-Byte. Gemeint ist das Intervall zwischen dem Ende der Benutzeräußerung und dem Eintreffen des ersten Audio-Chunks der Antwort des Sprachmodells. Audio2Face und der Wiedergabepuffer sind nicht enthalten – es handelt sich ausschließlich um die “Denkzeit” des LLM.
Je niedriger die TTFT, desto früher kann die Audioverarbeitung beginnen. Und je stabiler sie ist (geringere Standardabweichung), desto vorhersehbarer ist das Benutzererlebnis.
Eine weitere gängige Kennzahl bei der Modellbewertung ist TPOT (Time Per Output Token). In dieser Studie wurde TPOT jedoch nicht gemessen, da sie in diesem Szenario keine relevanten Informationen über das Benutzererlebnis liefert. Sobald der erste Audio-Chunk eingetroffen ist, verlagert sich der Engpass auf Audio2Face, das genügend Zeit hat, die nachfolgenden Chunks zu verarbeiten, während diese weiter eintreffen. Daher ist die TTFT die Kennzahl, die die wahrgenommene Reaktionsfähigkeit des Systems am besten widerspiegelt.
Methodik
Alle Anbieter wurden unter denselben Bedingungen gemessen, um vergleichbare Ergebnisse zu gewährleisten:
- Voice Activity Detector (VAD): in allen Fällen derselbe akustische Detektor auf Basis des Signalpegels (RMS) mit einem Schwellenwert von 0,01 und einem Bestätigungsfenster von 150 ms. Er wird ausgelöst, wenn der Benutzer aufhört zu sprechen.
- Server-Stille: 200 ms für alle Anbieter – die zusätzliche Zeit, die der Server wartet, bevor er die Anfrage an das LLM sendet.
- Testfragen: 20 Fragen in vier Schwierigkeitsstufen (5 einfach, 5 mittel, 5 komplex, 5 sehr komplex) sowie 1 Aufwärmfrage, die nicht in die Analyse einfloss.
Jede der 20 Fragen wurde pro Anbieter einmal ausgeführt und die jeweils erzielte TTFT erfasst. Aggregierte Kennzahlen (Mittelwert, Standardabweichung, Minimum und Maximum) wurden aus den 20 Messungen pro Modell berechnet.
Die Fragen wurden nach dem erwarteten Denkaufwand des Modells eingestuft. Einfache Fragen sind Begrüßungen oder einfaches Allgemeinwissen; mittlere Fragen erfordern kurze Erklärungen; komplexe Fragen erfordern logisches Schlussfolgern oder das Ausarbeiten von Empfehlungen; sehr komplexe Fragen verlangen ausführliche Antworten mit Planung, Vergleichen oder detaillierten Erläuterungen von Konzepten.
Die vollständige Liste finden Sie im Anhang: Verwendeter Fragenkatalog.
Bereitstellungsregion: GPT Realtime wird aus der Azure-Region Sweden Central bereitgestellt. Gemini Live gibt keine feste Region an; Google leitet die Anfragen automatisch weiter.
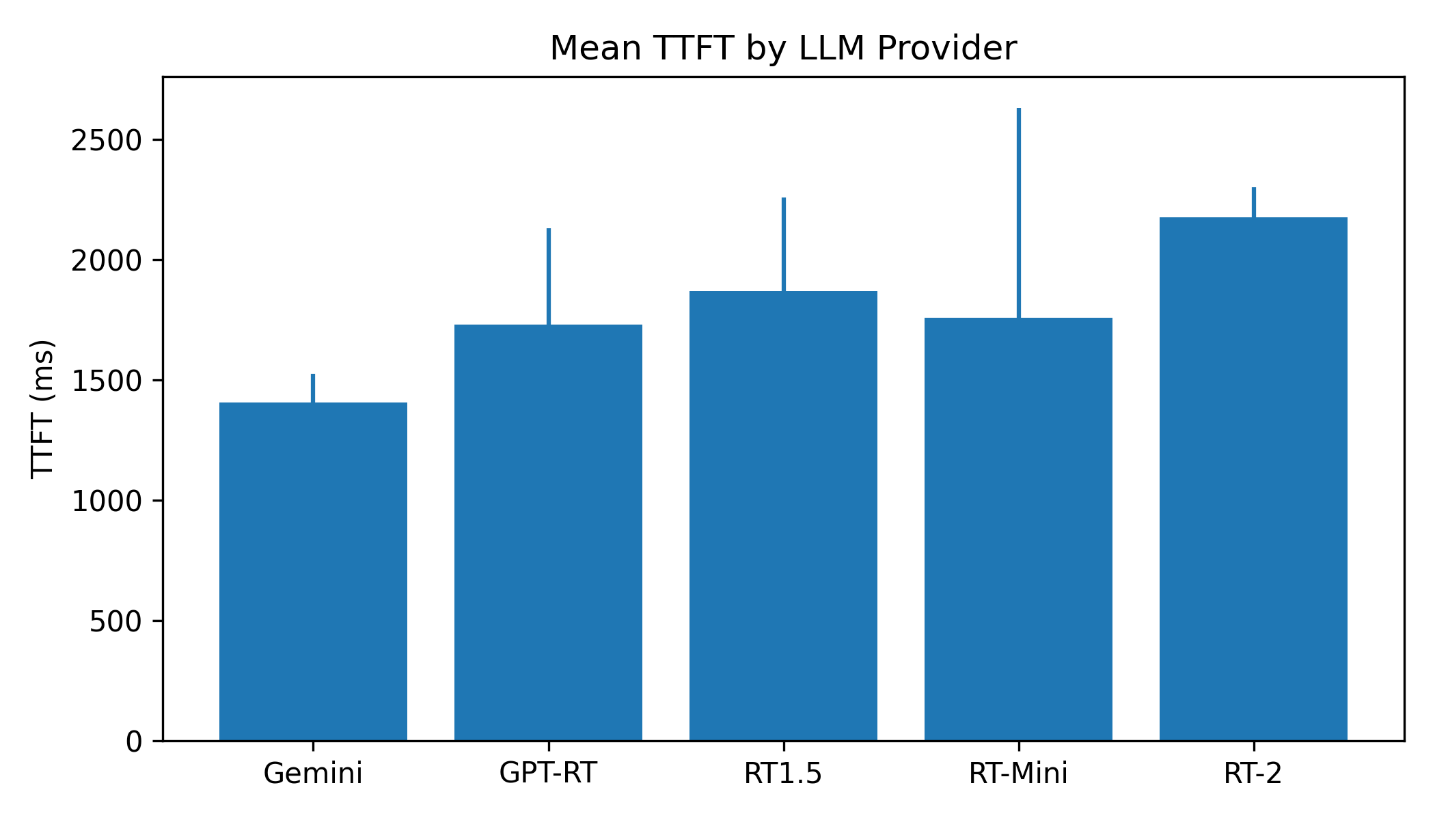
| Anbieter | Mittelwert | Std.-Abw. | Min. | Max. |
|---|---|---|---|---|
| Gemini 3.1 Live | 1.407 ms | ±118 ms | 1.191 ms | 1.626 ms |
| GPT-Realtime | 1.731 ms | ±399 ms | 834 ms | 2.783 ms |
| GPT-Realtime 1.5 | 1.869 ms | ±389 ms | 1.263 ms | 2.857 ms |
| GPT-Realtime-Mini | 1.758 ms | ±872 ms | 1.045 ms | 4.446 ms |
| GPT-Realtime-2 | 2.232 ms | ±126 ms | 1.931 ms | 2.523 ms |
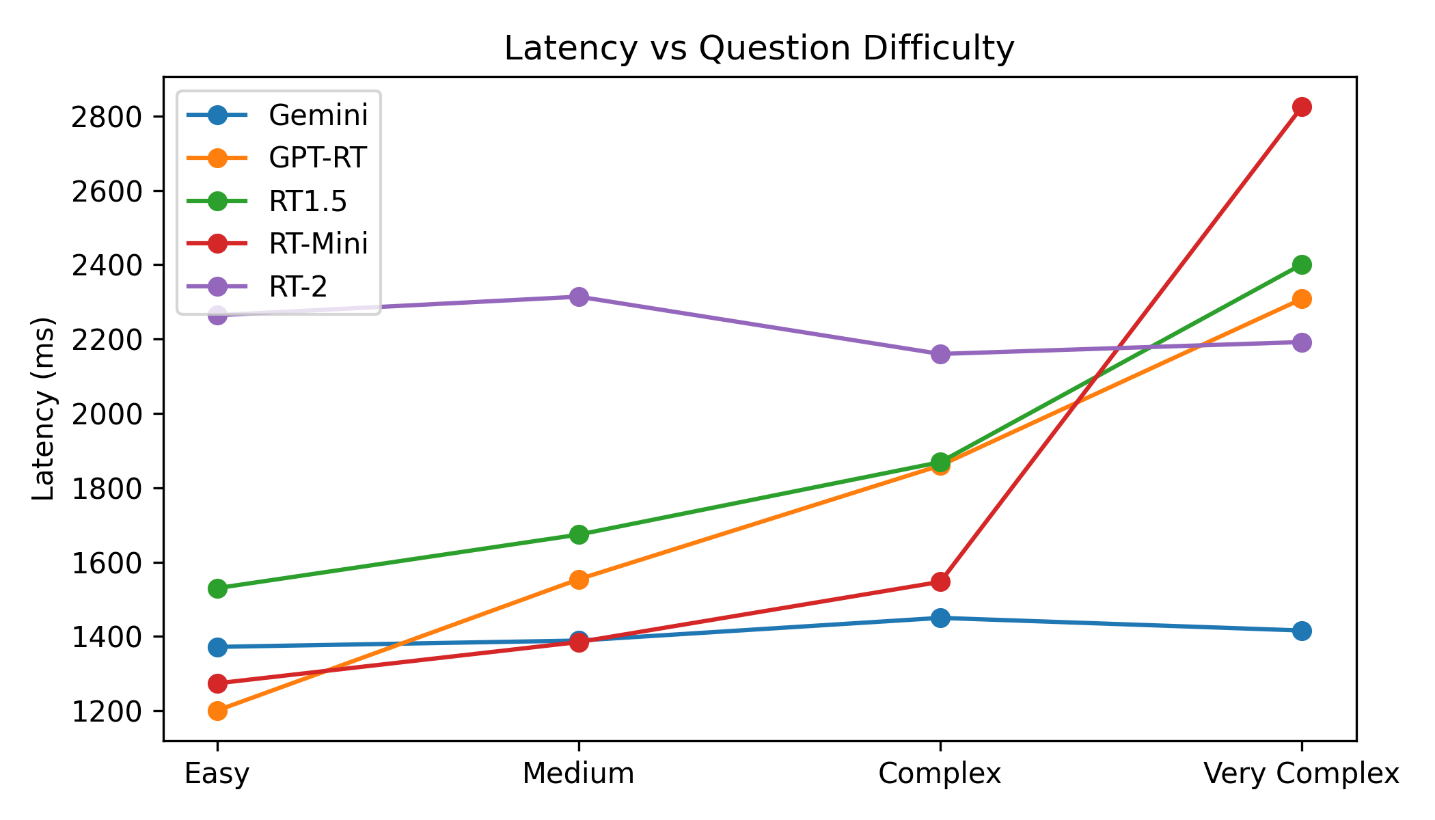
Latenz nach Schwierigkeitsgrad
Das wichtigste Ergebnis ist das Verhalten der einzelnen Modelle bei steigender Komplexität. Gemini 3.1 Live hält unabhängig vom Schwierigkeitsgrad eine nahezu konstante Latenz (~1.400 ms). Die GPT-Modelle hingegen skalieren deutlich: GPT-Realtime steigt von 1.201 ms bei einfachen Fragen auf 2.308 ms bei sehr komplexen.
Hinweis: GPT-Realtime wurde in der Azure-Region Sweden Central bereitgestellt, während Gemini 3.1 Live das automatische Infrastruktur-Routing von Google nutzt. Ein Teil der beobachteten TTFT-Unterschiede kann daher von der Netzwerklatenz zwischen Client und der Infrastruktur des jeweiligen Anbieters beeinflusst sein.
| Schwierigkeit | Gemini 3.1 Live | GPT-Realtime | GPT-Realtime 1.5 | GPT-Realtime Mini | GPT-Realtime 2 |
|---|---|---|---|---|---|
| Einfach | 1.372 ms | 1.201 ms | 1.530 ms | 1.274 ms | 2.264 ms |
| Mittel | 1.389 ms | 1.554 ms | 1.674 ms | 1.385 ms | 2.314 ms |
| Komplex | 1.450 ms | 1.860 ms | 1.869 ms | 1.547 ms | 2.160 ms |
| Sehr komplex | 1.416 ms | 2.308 ms | 2.401 ms | 2.825 ms | 2.192 ms |
Wichtigste Ergebnisse
Gemini ist am schnellsten und am konsistentesten. Mit einem Mittelwert von 1.407 ms und einer Standardabweichung von nur ±118 ms ist Gemini 3.1 Live der am besten vorhersagbare Anbieter. Unabhängig von der gestellten Frage antwortet es konstant im selben Bereich.
Die Latenz von Gemini skaliert NICHT mit der Komplexität. Einfache Frage: 1.372 ms. Sehr komplexe Frage: 1.416 ms. Der Unterschied beträgt nur 44 ms – im Grunde statistisches Rauschen. Das deutet darauf hin, dass das Modell Gemini 3.1 Live auf eine konstante Latenz optimiert ist und nicht darauf, je nach Schwierigkeit mehr Zeit zum Nachdenken aufzuwenden. Während der Tests wurden keine nennenswerten Unterschiede in der Antwortqualität festgestellt, die diese konstante Latenz rechtfertigen würden.
Das interessanteste Ergebnis ist nicht, wer schneller ist, sondern dass Gemini unabhängig von der Komplexität eine konstante Latenz aufweist, während GPT seine Denkzeit mit der Schwierigkeit skaliert.
GPT-Realtime ist bei einfachen Fragen am schnellsten. Bei einfachen Fragen erreicht GPT-Realtime 1.201 ms und ist damit schneller als Gemini. Das Problem entsteht mit der Komplexität: Bei sehr komplexen Fragen steigt die Latenz auf 2.308 ms, fast das Doppelte. Das zeigt, dass das Modell umso mehr Zeit zum Nachdenken aufwendet, je schwieriger die Frage ist.
GPT-Realtime-Mini weist starke Ausreißer auf. Zwei sehr komplexe Fragen treiben seine Latenz auf 4.446 ms und 3.781 ms. Mit einer Standardabweichung von ±872 ms ist es das am wenigsten vorhersagbare Modell von allen – für den Produktivbetrieb mit komplexen Fragen nicht empfehlenswert.
Antwortqualität. Über die Latenz hinaus wurden qualitative Unterschiede zwischen den Modellen beobachtet:
- Gemini: der einzige Anbieter, der auf Nachfrage eine plausible Uhrzeit nennt. Stimme und Tonfall bleiben während des gesamten Gesprächs konsistent.
- GPT-Realtime, 1.5, 2: verweigern die Angabe der Uhrzeit (vermutlich mangels Zugriff auf die Systemuhr). Außerdem wurden während des Gesprächs unerwartete Stimmwechsel festgestellt: In bestimmten Momenten veränderte der Assistent deutlich Klangfarbe oder Intonation und klang mitunter wie eine Stimme des anderen Geschlechts. Diese Wechsel störten das Gefühl von Kontinuität in der Interaktion.
- GPT-Realtime-Mini: scheitert am praktischen Denken. Auf die Frage, ob man besser zu Fuß oder mit dem Auto zu einer 20 Meter entfernten Waschanlage gehen solle, empfahl es das Auto. Es war das einzige Modell, das falsch antwortete.
Diese Beobachtungen sind qualitativ und beruhen auf den Erfahrungen während der Tests. Sie sind nicht Teil einer systematischen Qualitätsstudie, aber für die Entscheidung über den Produktiveinsatz relevant.
Teil II: Hardwarevergleich für Audio2Face
Sobald das LLM die Audioantwort erzeugt hat, muss dieses Audio in Gesichtsanimationen umgewandelt werden: Lippenbewegung, Wangen, Augenbrauen – alles in Echtzeit. NVIDIA Audio2Face (A2F) ist das System, das diese Umwandlung durchführt und dabei „Blendshapes“ erzeugt – numerische Anweisungen, die genau festlegen, wie stark sich jeder Gesichtsmuskel des Avatars zu jedem Zeitpunkt bewegt.
Audio2Face ist nach dem LLM die rechenintensivste Komponente. Es kann auf zwei Arten betrieben werden:
- Lokal (Docker): Das Modell läuft auf der GPU des eigenen Rechners. Minimale Latenz (alles lokal), erfordert jedoch dedizierte Hardware und skaliert nicht auf mehrere Benutzer.
- Cloud (Azure Container App): Das Modell läuft auf einer A100-GPU in der Cloud. Das fügt Netzwerklatenz hinzu (~10–20 ms pro Chunk). Obwohl diese Art von Architektur für Mehrbenutzerszenarien ausgelegt ist, wurden in dieser Studie keine Nebenläufigkeitstests durchgeführt; ihre Skalierbarkeit wurde daher nicht bewertet.
Was ist ein Audio-Chunk?
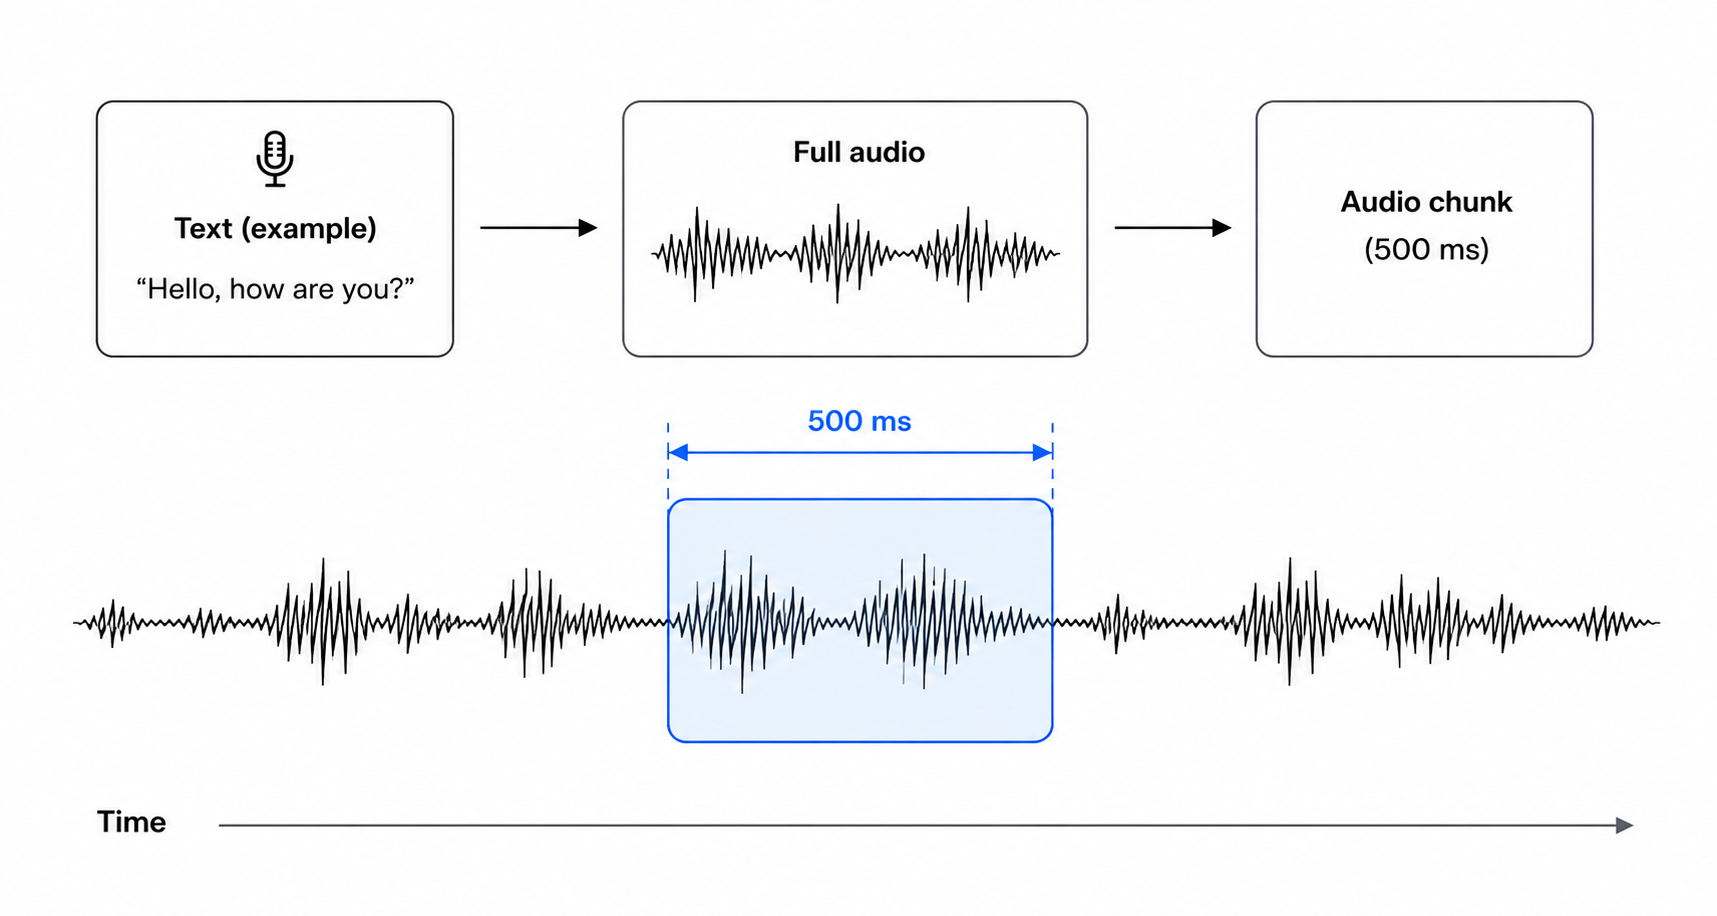
NVIDIA Audio2Face verarbeitet nicht das gesamte Audio auf einmal, sondern erhält es in kleine Fragmente (Chunks) aufgeteilt, die kontinuierlich per gRPC gesendet werden. Jeder Chunk enthält einige hundert Millisekunden Audio, und sobald Audio2Face einen Chunk empfängt, beginnt es mit der Erzeugung der entsprechenden Gesichtsanimationen, ohne auf den Rest des Satzes zu warten.
Die Chunk-Größe ist ein Kompromiss zwischen Latenz und Effizienz: Kleinere Chunks lassen die Avatar-Animation früher beginnen, erhöhen aber die Anzahl der Anfragen und den Verarbeitungs-Overhead. Größere Chunks verringern diesen Overhead, erfordern jedoch eine längere Wartezeit, bevor die Animation beginnen kann.
Methodik
- Testumgebungen: RTX 4070 (Laptop, lokales Docker), RTX 4080 Super (Desktop, lokales Docker), RTX 5090 (Desktop, lokales Docker) und NVIDIA A100 (Azure Container App). Eine detaillierte Hardwareliste finden Sie im Anhang: Testumgebungen.
- Studiendesign: Durchlauf über 25 Chunk-Größen (von 300 ms bis 1.500 ms in 50-ms-Schritten) mit 5 Chunks pro Schritt (insgesamt 125 Chunks pro Umgebung). Der gRPC-Kanal wird wiederverwendet, um den Verbindungs-Overhead auszuschließen.
| Chunk | RTX 4070 | RTX 4080 Super | RTX 5090 | A100 (Cloud) | 4070→5090 | A100→5090 |
|---|---|---|---|---|---|---|
| 300 ms | 596 ms | 249 ms | 225 ms | 237 ms | 2.65× | 1.05× |
| 500 ms | 637 ms | 325 ms | 283 ms | 303 ms | 2.25× | 1.07× |
| 750 ms | 1.162 ms | 421 ms | 386 ms | 400 ms | 3.01× | 1.04× |
| 1.000 ms | 1.240 ms | 495 ms | 455 ms | 476 ms | 2.73× | 1.05× |
| 1.500 ms | 1.882 ms | 676 ms | 613 ms | 662 ms | 3.07× | 1.08× |
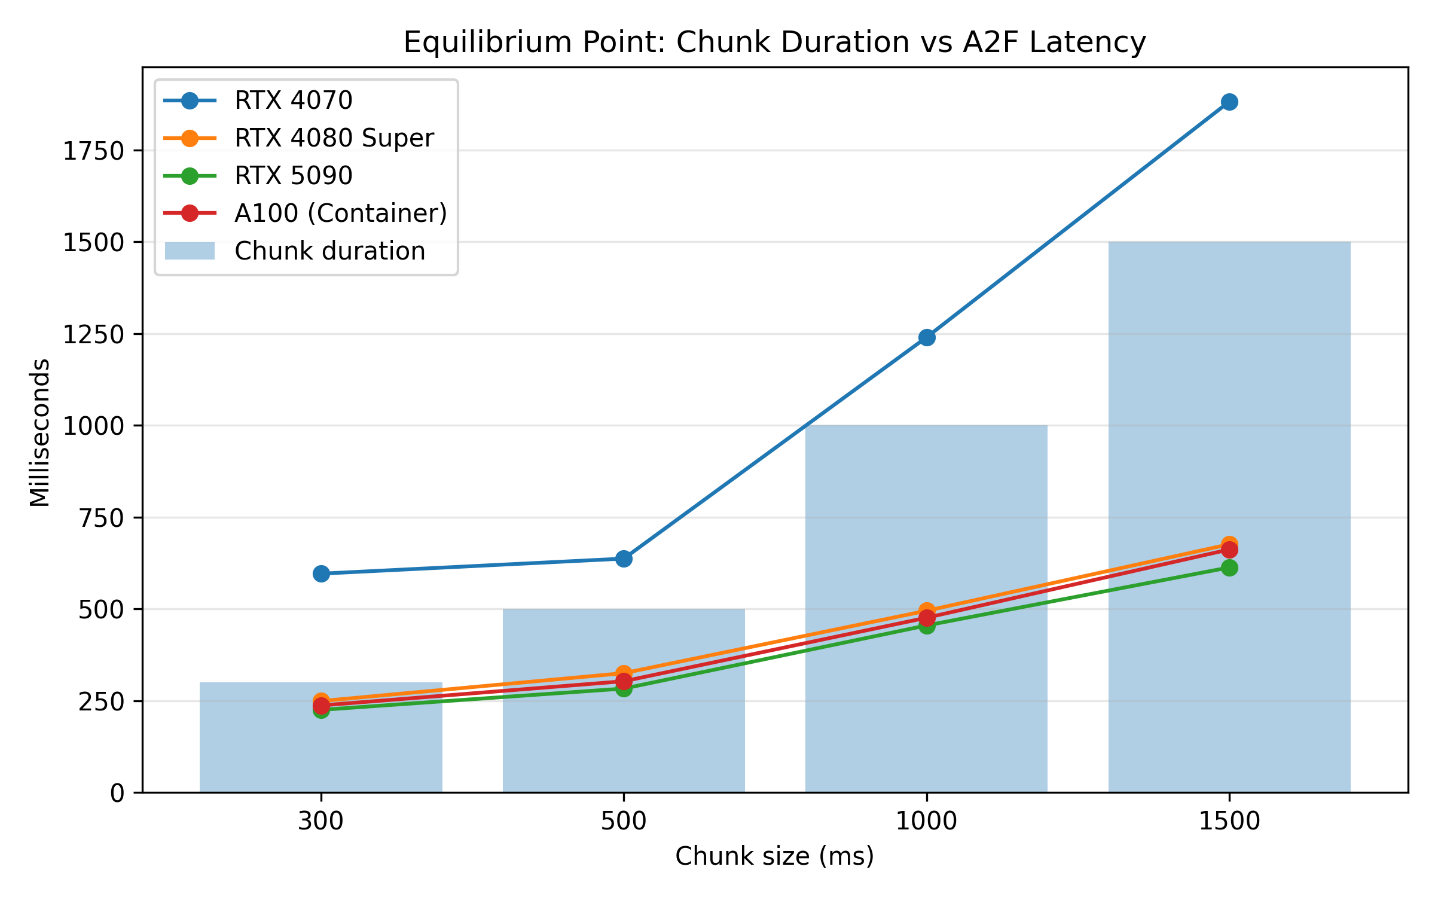
Die RTX 5090 erzielt bei allen Chunk-Größen die niedrigste Latenz. Der Unterschied zur RTX 4080 Super ist jedoch relativ gering (24–63 ms in den durchgeführten Tests), sodass der Einfluss auf die Gesamtlatenz des Systems begrenzt ist. Hinsichtlich der Latenz verhalten sich beide GPUs also sehr ähnlich.
Die auf Azure Container Apps bereitgestellte NVIDIA A100 liegt in ihrer Leistung ebenfalls sehr nah an der RTX 5090, mit einer geringen zusätzlichen Latenz, die auf die Netzwerkkommunikation zurückzuführen ist. Diese Art der Bereitstellung ist eine Alternative für Architekturen, in denen Audio2Face zentral ausgeführt wird. Diese Studie beschränkt sich jedoch auf die Latenzanalyse und bewertet keine Aspekte wie Betriebskosten oder Leistung unter paralleler Last.
Teil III: Kombinierte Latenzanalyse von LLM + A2F
Fasst man beide Studien zusammen, ergibt sich die Gesamtlatenz der Pipeline (ohne den Wiedergabepuffer, der in allen Konfigurationen konstant ist) aus der Summe der TTFT des LLM und der A2F-Latenz.
Die A2F-Latenz wird von dem Moment gemessen, in dem ein Audio-Chunk per gRPC gesendet wird, bis zum Empfang der zugehörigen Blendshapes für die Avatar-Animation. Bei lokalen Bereitstellungen ist dies reine Verarbeitungszeit, bei der A100 ist der Netzwerk-Roundtrip enthalten.
Die A2F-Werte beziehen sich auf einen 500-ms-Chunk, den praxisgerechten Wert für den Produktivbetrieb – er bietet einen guten Kompromiss zwischen einer kurzen Wartezeit bis zum Animationsbeginn und einem vertretbaren gRPC-Anfrage-Overhead.
| LLM | A2F-Hardware | TTFT LLM | A2F @500 ms | Gesamt | Std.-Abw. |
|---|---|---|---|---|---|
| Gemini 3.1 Live | RTX 5090 | 1.407 ms | 283 ms | 1.690 ms | ±120 ms |
| Gemini 3.1 Live | A100 (Cloud) | 1.407 ms | 303 ms | 1.710 ms | ±119 ms |
| Gemini 3.1 Live | RTX 4080 Super | 1.407 ms | 325 ms | 1.732 ms | ±120 ms |
| Gemini 3.1 Live | RTX 4070 | 1.407 ms | 637 ms | 2.044 ms | ±122 ms |
| GPT-Realtime | RTX 5090 | 1.731 ms | 283 ms | 2.014 ms | ±401 ms |
| GPT-Realtime-2 | RTX 5090 | 2.176 ms | 283 ms | 2.459 ms | ±128 ms |
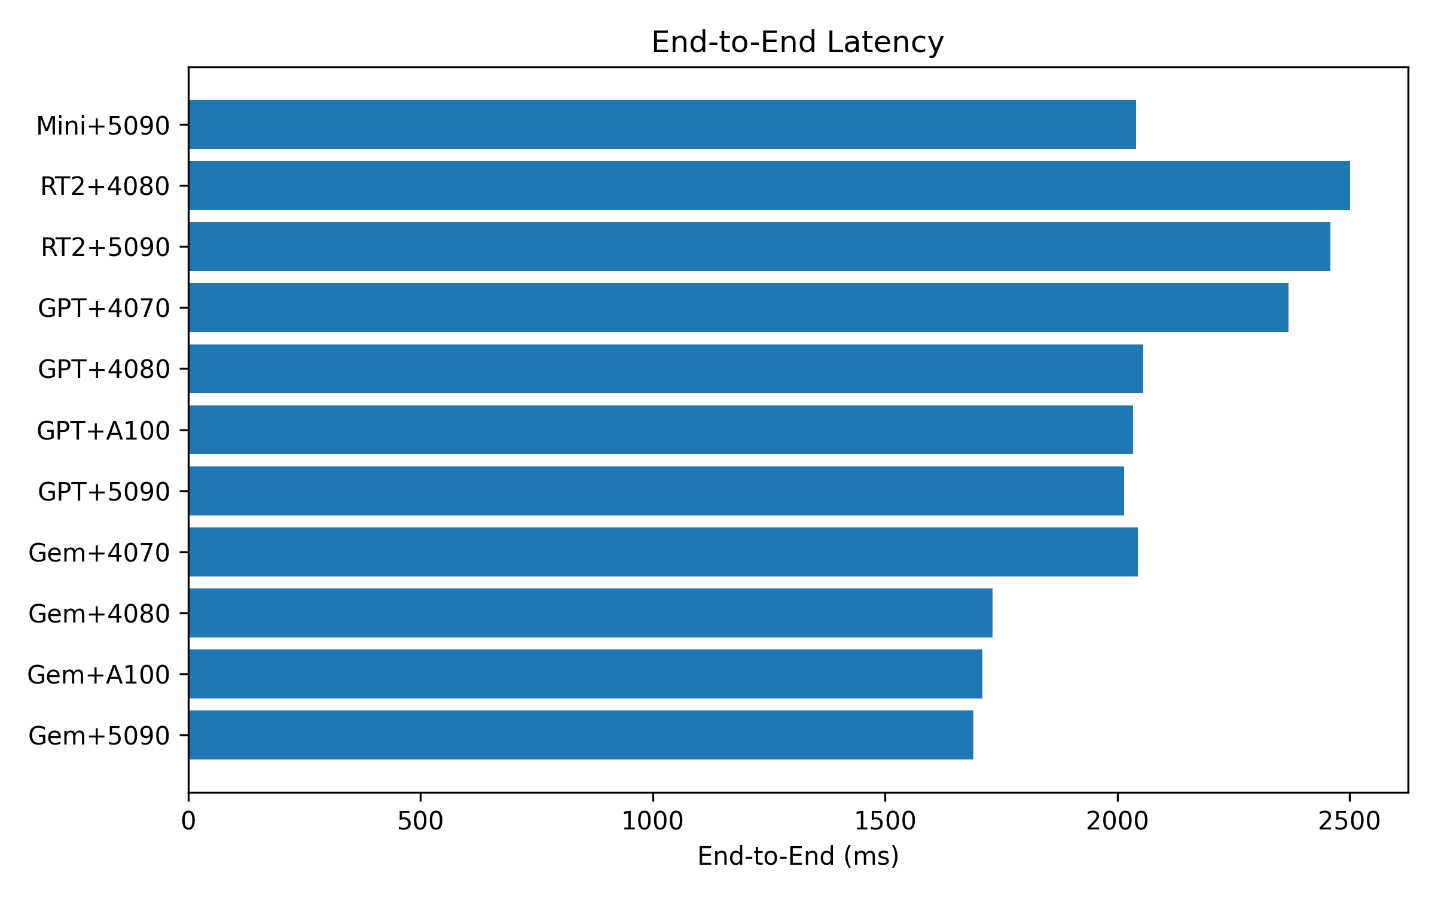
Die Wahl des LLM-Anbieters wirkt sich stärker aus als die Wahl der Hardware: Der Unterschied zwischen dem besten und dem schlechtesten Modell (Gemini vs. GPT-Realtime-2) beträgt ~770 ms, gegenüber ~354 ms zwischen der besten und der schlechtesten GPU (RTX 5090 vs. RTX 4070) bei 500-ms-Chunks. Konsistenz ist ebenso wichtig wie absolute Geschwindigkeit: Gemini + RTX 5090 erreicht eine kombinierte Standardabweichung von ±120 ms, gegenüber ±401 ms bei GPT-Realtime + RTX 5090 und ±872 ms bei GPT-Realtime-Mini.
Empfehlungen für den Produktivbetrieb
Nach der Bewertung der verschiedenen Kombinationen aus Conversational-AI-Modellen und Hardwarekonfigurationen in der in dieser Studie beschriebenen Architektur lässt sich eine Empfehlung für den Einsatz in einer Produktivumgebung ableiten. Die folgende Tabelle fasst die relevantesten Konfigurationen anhand der ermittelten Gesamtlatenz und der während der Tests beobachteten Konsistenz zusammen. Unter den getesteten Bedingungen erzielte die Kombination Gemini 3.1 Live + RTX 5090 die beste Gesamtleistung mit der niedrigsten Latenz und der höchsten Stabilität aller untersuchten Konfigurationen.
| Priorität | LLM | A2F-Hardware | Gesamtlatenz | Begründung |
|---|---|---|---|---|
| 🥇 Optimal | Gemini 3.1 Live | RTX 5090 | ~1.690 ms | Niedrigste Latenz und höchste End-to-End-Konsistenz |
| 🥈 Beste Cloud-Option | Gemini 3.1 Live | A100 (Cloud) | ~1.710 ms | Nur 20 ms mehr; gerechtfertigt für Mehrbenutzerszenarien |
| 🥉 Ohne RTX 5090 | Gemini 3.1 Live | RTX 4080 Super | ~1.732 ms | Hervorragendes Preis-Leistungs-Verhältnis |
| ⚠️ Nicht empfohlen | Beliebig | RTX 4070 | >2.044 ms | Bietet in keiner Chunk-Konfiguration eine akzeptable Animationslatenz |
| ⚠️ Nicht empfohlen | GPT-RT-Mini | Beliebig | Unvorhersehbar | ±873 ms Standardabw.; Spitzen von bis zu 4,4 s bei sehr komplexen Fragen |
Fazit
Diese Studie untersucht, welche Kombination aus Conversational-AI-Modell und Audio2Face-Hardware das beste Erlebnis bei einem Echtzeit-Avatar bietet, gemessen vor allem an der Latenz und ihrer Konsistenz.
Unter den untersuchten Modellen eignet sich Gemini 3.1 Live am besten für den Produktivbetrieb: Es ist nicht nur im Durchschnitt am schnellsten, sondern auch am stabilsten und antwortet unabhängig von der Komplexität der Frage stets in einem sehr ähnlichen Bereich. Die GPT-Modelle sind bei einfachen Fragen konkurrenzfähig, ihre Latenz wächst jedoch mit der Schwierigkeit und erreicht im Fall von GPT-Realtime-Mini Spitzen von über 4 Sekunden, die die Natürlichkeit des Gesprächs vollständig zerstören.
Bei der Hardware für die Gesichtsanimation bieten unter den in dieser Studie verwendeten GPUs die RTX 5090 und die A100 in der Cloud eine sehr ähnliche Leistung. Die RTX 4080 Super ist eine solide Alternative mit einem für den Benutzer vernachlässigbaren Unterschied. Die RTX 4070 hingegen verursacht in jeder Konfiguration eine Latenz, die die Flüssigkeit beeinträchtigt, und wird daher für den Produktivbetrieb nicht empfohlen.
Die empfohlene Kombination für den Produktivbetrieb ist Gemini 3.1 Live mit RTX 5090 oder A100, mit einer kombinierten Latenz von etwa 1.700 ms und einer Schwankung von ±120 ms. Das gewährleistet ein stabiles und natürliches Gesprächserlebnis.
Einschränkungen der Studie
Die Ergebnisse und Empfehlungen dieser Studie sollten unter Berücksichtigung der folgenden Einschränkungen interpretiert werden:
- Einzelbenutzerumgebung. Alle Tests wurden mit einem einzigen gleichzeitigen Benutzer durchgeführt. Das Systemverhalten unter paralleler Last mehrerer Benutzer (insbesondere in der A100-Cloud-Konfiguration) wurde nicht bewertet und kann erheblich von den hier dargestellten Werten abweichen.
- Nicht kontrollierte Netzwerklatenz. Die TTFT jedes Anbieters enthält die Netzwerklatenz zwischen dem Client und der Infrastruktur des Modells. GPT-Realtime wurde aus Azure Sweden Central bereitgestellt, während Gemini 3.1 Live das automatische Routing von Google auf Basis des Client-Standorts nutzt. Ein Teil der beobachteten Unterschiede zwischen den Anbietern kann auf diese Variable zurückzuführen sein und nicht auf die eigentliche Leistung des Modells.
- Nicht systematische Qualitätsbewertung. Die Beobachtungen zur Antwortqualität (Kohärenz, Tonfall, Denkfähigkeit) sind qualitativ und wurden während der Latenztests gesammelt. Sie sind nicht Teil einer strukturierten Qualitätsstudie und sollten nicht als abschließende Aussagen über die Fähigkeiten der einzelnen Modelle verstanden werden.
- Synchronisationspuffer und Rendering nicht berücksichtigt. Die angegebene Gesamtlatenz umfasst weder den Synchronisationspuffer zwischen Audio und Blendshapes noch die Rendering-Zeit von Evergine. Beide Komponenten sind in allen Konfigurationen konstant und beeinflussen den Vergleich nicht, wohl aber die tatsächlich vom Benutzer wahrgenommene Latenz.
Anhang: Verwendeter Fragenkatalog
| Stufe | Frage |
|---|---|
| Einfach | Hallo, wie geht es Ihnen? |
| Einfach | Wie spät ist es ungefähr? |
| Einfach | Was ist die Hauptstadt von Frankreich? |
| Einfach | Wie viele Tage hat eine Woche? |
| Einfach | Welche Farbe entsteht, wenn man Blau und Gelb mischt? |
| Mittel | Erklären Sie kurz, was künstliche Intelligenz ist. |
| Mittel | Was sind die wichtigsten Unterschiede zwischen einem Hund und einer Katze als Haustier? |
| Mittel | Warum erscheint der Himmel tagsüber blau? |
| Mittel | Welche Vorteile hat regelmäßige Bewegung? |
| Mittel | Was sind die Unterschiede zwischen einer SSD und einer herkömmlichen Festplatte? |
| Komplex | Ich lerne Programmieren. Mit welcher Sprache würden Sie mir den Einstieg empfehlen und warum? |
| Komplex | Ich habe ein Budget von 1.500 € für einen Computer für Arbeit und Gaming. Wie würden Sie es auf die verschiedenen Komponenten verteilen? |
| Komplex | Erklären Sie Schritt für Schritt und in einfachen Worten, wie ein neuronales Netz funktioniert. |
| Komplex | Was sind die Vor- und Nachteile von Remote-Arbeit gegenüber Arbeit vor Ort? |
| Komplex | Wenn ich in einem Jahr Englisch von Grund auf lernen wollte, welchen wöchentlichen Lernplan würden Sie vorschlagen? |
| Sehr komplex | Entwerfen Sie einen detaillierten Plan für eine 10-tägige Reise nach Japan mit einem Budget von 2.500 € und geben Sie an, welche Städte besucht werden sollten, welche Verkehrsmittel empfehlenswert sind und wie sich das Budget ungefähr aufteilt. |
| Sehr komplex | Stellen Sie sich vor, Sie sind Technologieverantwortlicher in einem Unternehmen mit 200 Mitarbeitern, das seine gesamte Infrastruktur in die Cloud migrieren möchte. Erklären Sie Schritt für Schritt, wie Sie die Migration planen würden, um Risiken und Ausfallzeiten zu minimieren. |
| Sehr komplex | Vergleichen Sie eingehend die Sprachen C++, C# und Rust für die Entwicklung von Grafik-Engines und analysieren Sie dabei Leistung, Speichersicherheit, Entwicklungsaufwand und Ökosystem. Schließen Sie mit einer begründeten Empfehlung. |
| Sehr komplex | Erklären Sie, wie ein Transformer-basiertes KI-Modell arbeitet – vom Empfang eines Satzes bis zur Erzeugung einer Antwort – und beschreiben Sie dabei Konzepte wie Tokenisierung, Embeddings, Attention-Mechanismus und Inferenz. |
| Sehr komplex | Ich möchte mein Auto in einer Waschanlage etwa 20 Meter von meinem Haus entfernt waschen. Sollte ich zu Fuß gehen oder fahren? Begründen Sie Ihre Antwort unter Berücksichtigung, dass das Ziel ist, das Auto zu waschen, und dass die Entfernung sehr kurz ist. |
Anhang: Testumgebungen
| Parameter | Wert |
|---|---|
| Messdatum | Juli 2026 |
| Audio2Face-Version | audio2face-3d:2.0 |
| Modelle | gemini-3.1-flash-live-preview, gpt-realtime, gpt-realtime-mini, gpt-realtime-2, gpt-realtime-1.5 |
| RTX-4070-Rechner | CPU: 13th Gen Intel(R) Core(TM) i7-13700H, RAM: 32 GB, Betriebssystem: Windows |
| RTX-4080-Super-Rechner | CPU: AMD Ryzen 7 7800X3D, RAM: 32 GB, Betriebssystem: Windows |
| RTX-5090-Rechner | CPU: Intel Core i7-14700, RAM: 32 GB, Betriebssystem: Windows |
| A100 (Cloud) | Anbieter: Azure Container Apps, Region: Sweden Central |