数学运算,前所未有地快
在最新的Evergine 2022.9.28版本中,我们发布了Evergine.Mathematics库的新版本,该版本使用了由CPU制造商设计的硬件加速指令集。
这得益于为Net6创建的新硬件内置API,它允许在x86、x64和ARM64目标架构上使用单指令多数据流(SIMD)指令(如果硬件支持)。通过这个新API,我们可以检查硬件中是否存在这些扩展,并在可能的情况下使用128位和256位寄存器向量来向量化代码,在单个周期(周期是CPU中的基本时间单位)内执行多个基本操作。
我们已使用这些指令来优化Evergine.Mathematics库中最重要的结构体(如Matrix4x4、Vector4、Matrix3x3和Quaternion)内部的操作,结果令人印象深刻。
基准测试
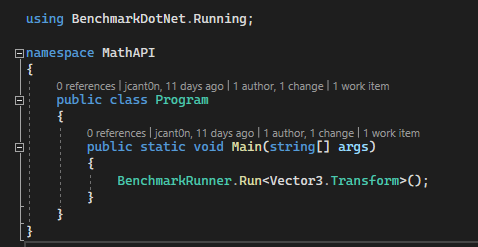
为了创建一些微基准测试,我们使用了benchmarkdotnet。以下是启动Matrix4x4对比的设置。
program.cs文件内容:
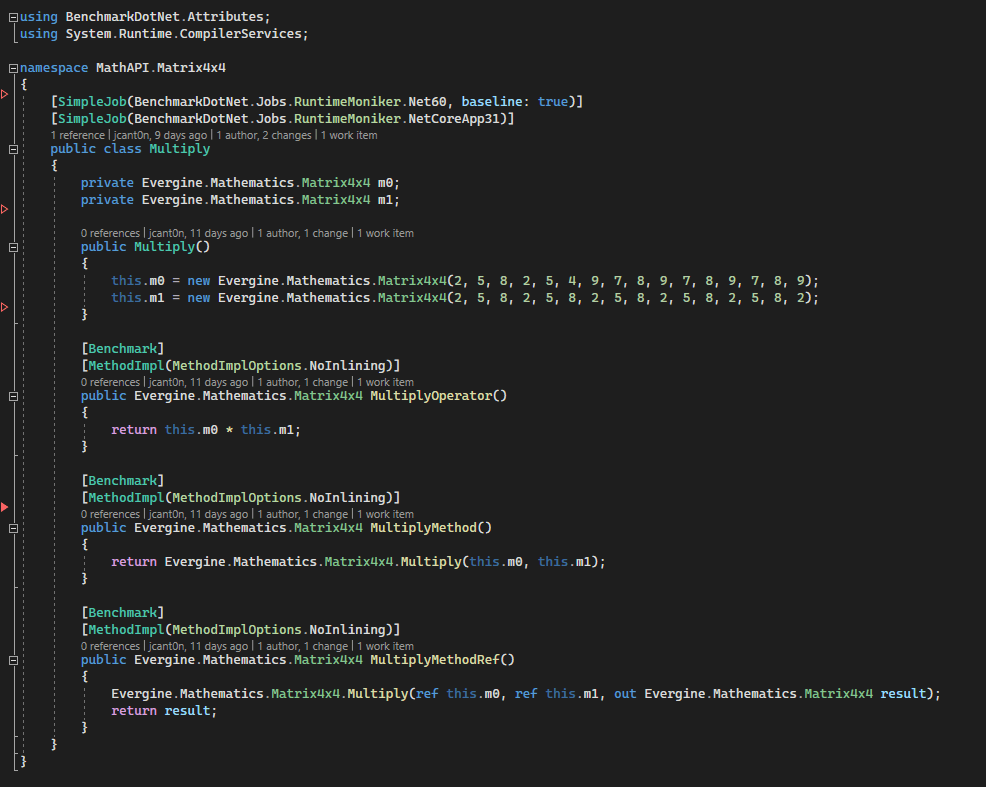
Matrix4x4乘法测试内容:
本文中所有x86和x64基准测试所使用的CPU为:
Intel Core i9-10980HK CPU 2.40GHz,1个CPU,16个逻辑核心和8个物理核心
benchmarkdotnet生成的详细结果如下:
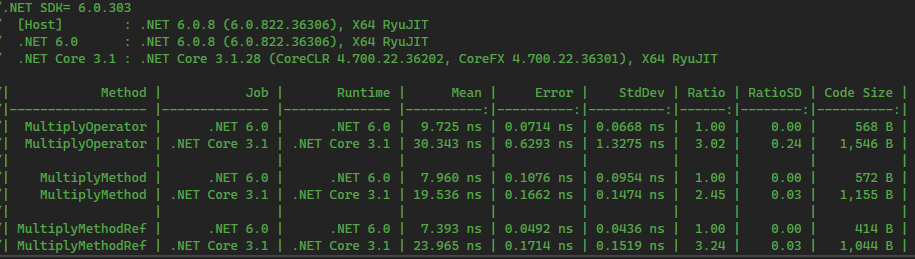
如您所见,使用MultiplyMethodRef(矩阵参数通过引用传递而非复制)的更快路径,即在此例中使用SSE SIMD指令的Net6新路径,仅需7.393纳秒,而旧路径需要23.965纳秒。代码大小也从1,044字节减少到414字节。对于3D图形引擎中最常用的数学运算之一来说,这些结果确实非常出色。
为了直观地展示在x86和x64架构上的性能提升,我们为每个数学结构体创建了一些图表。
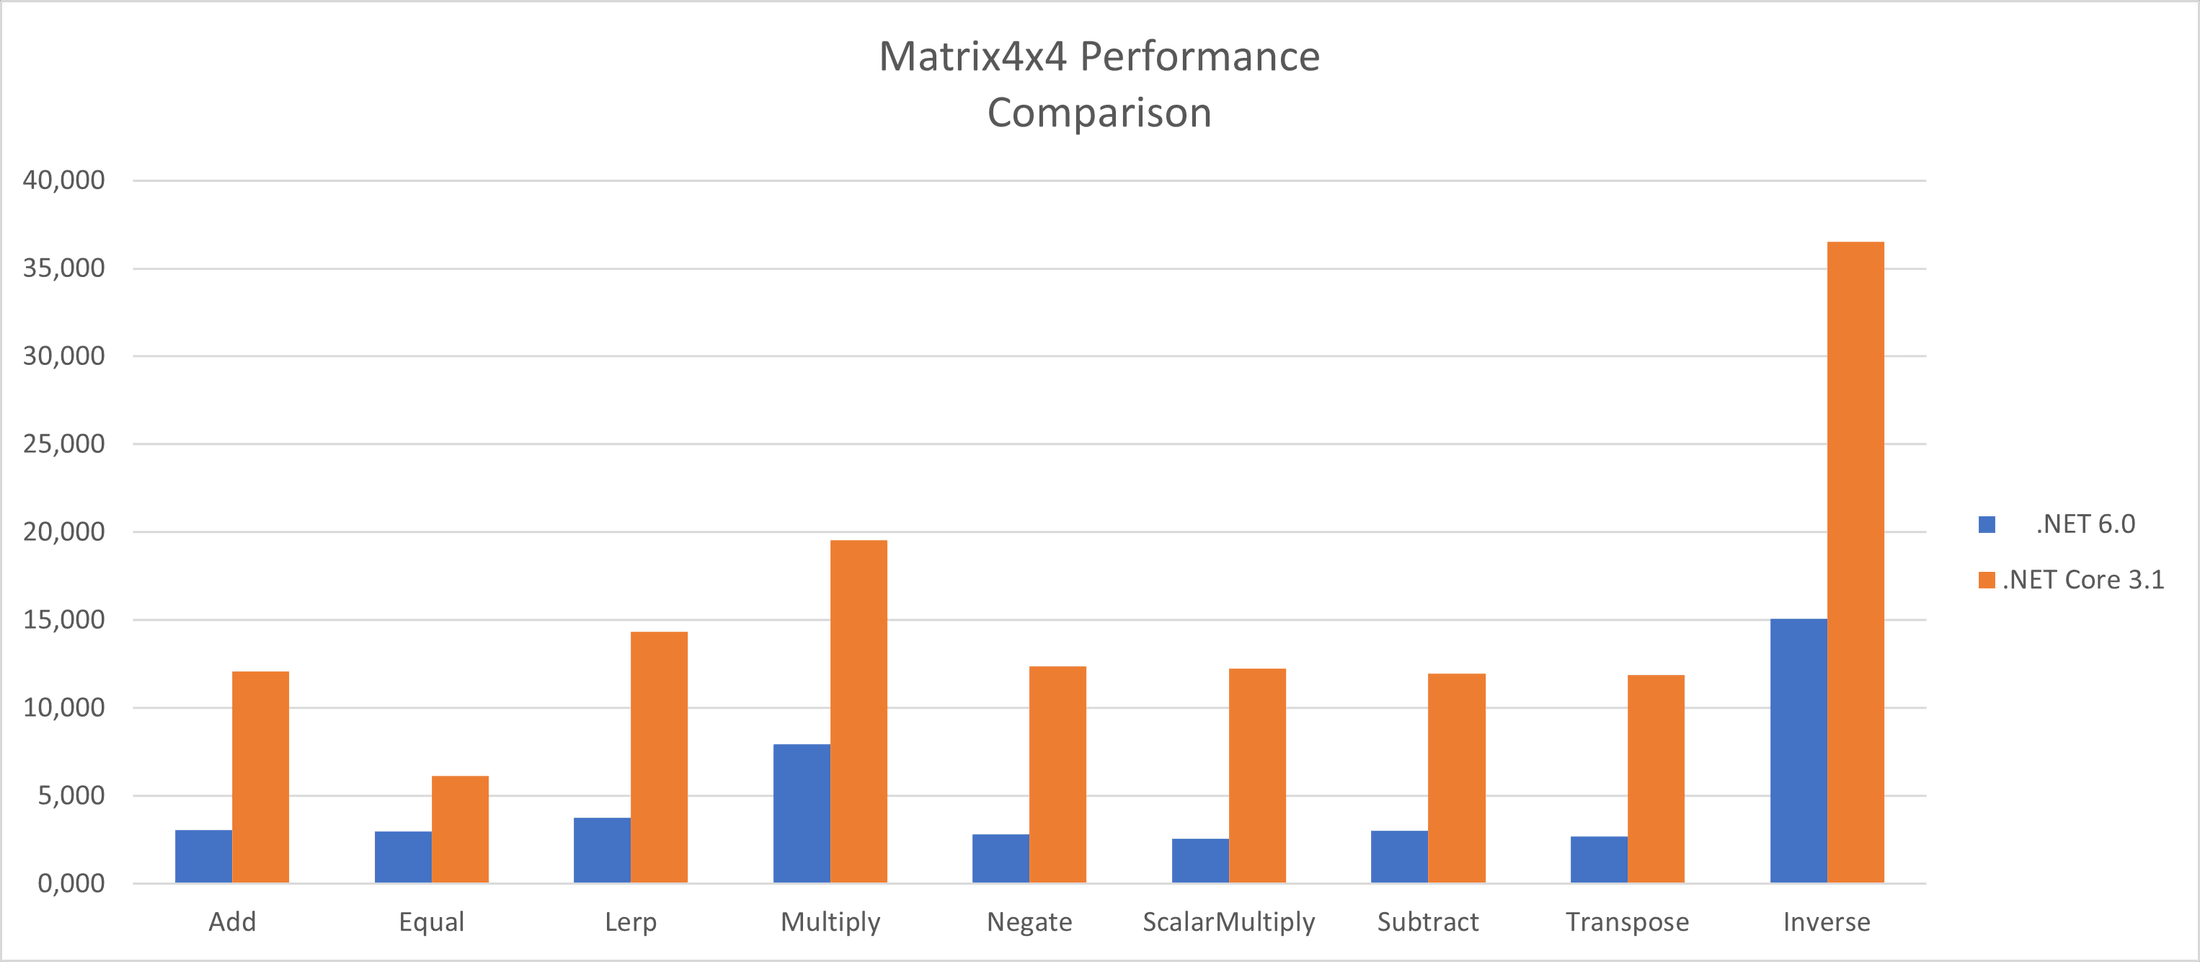
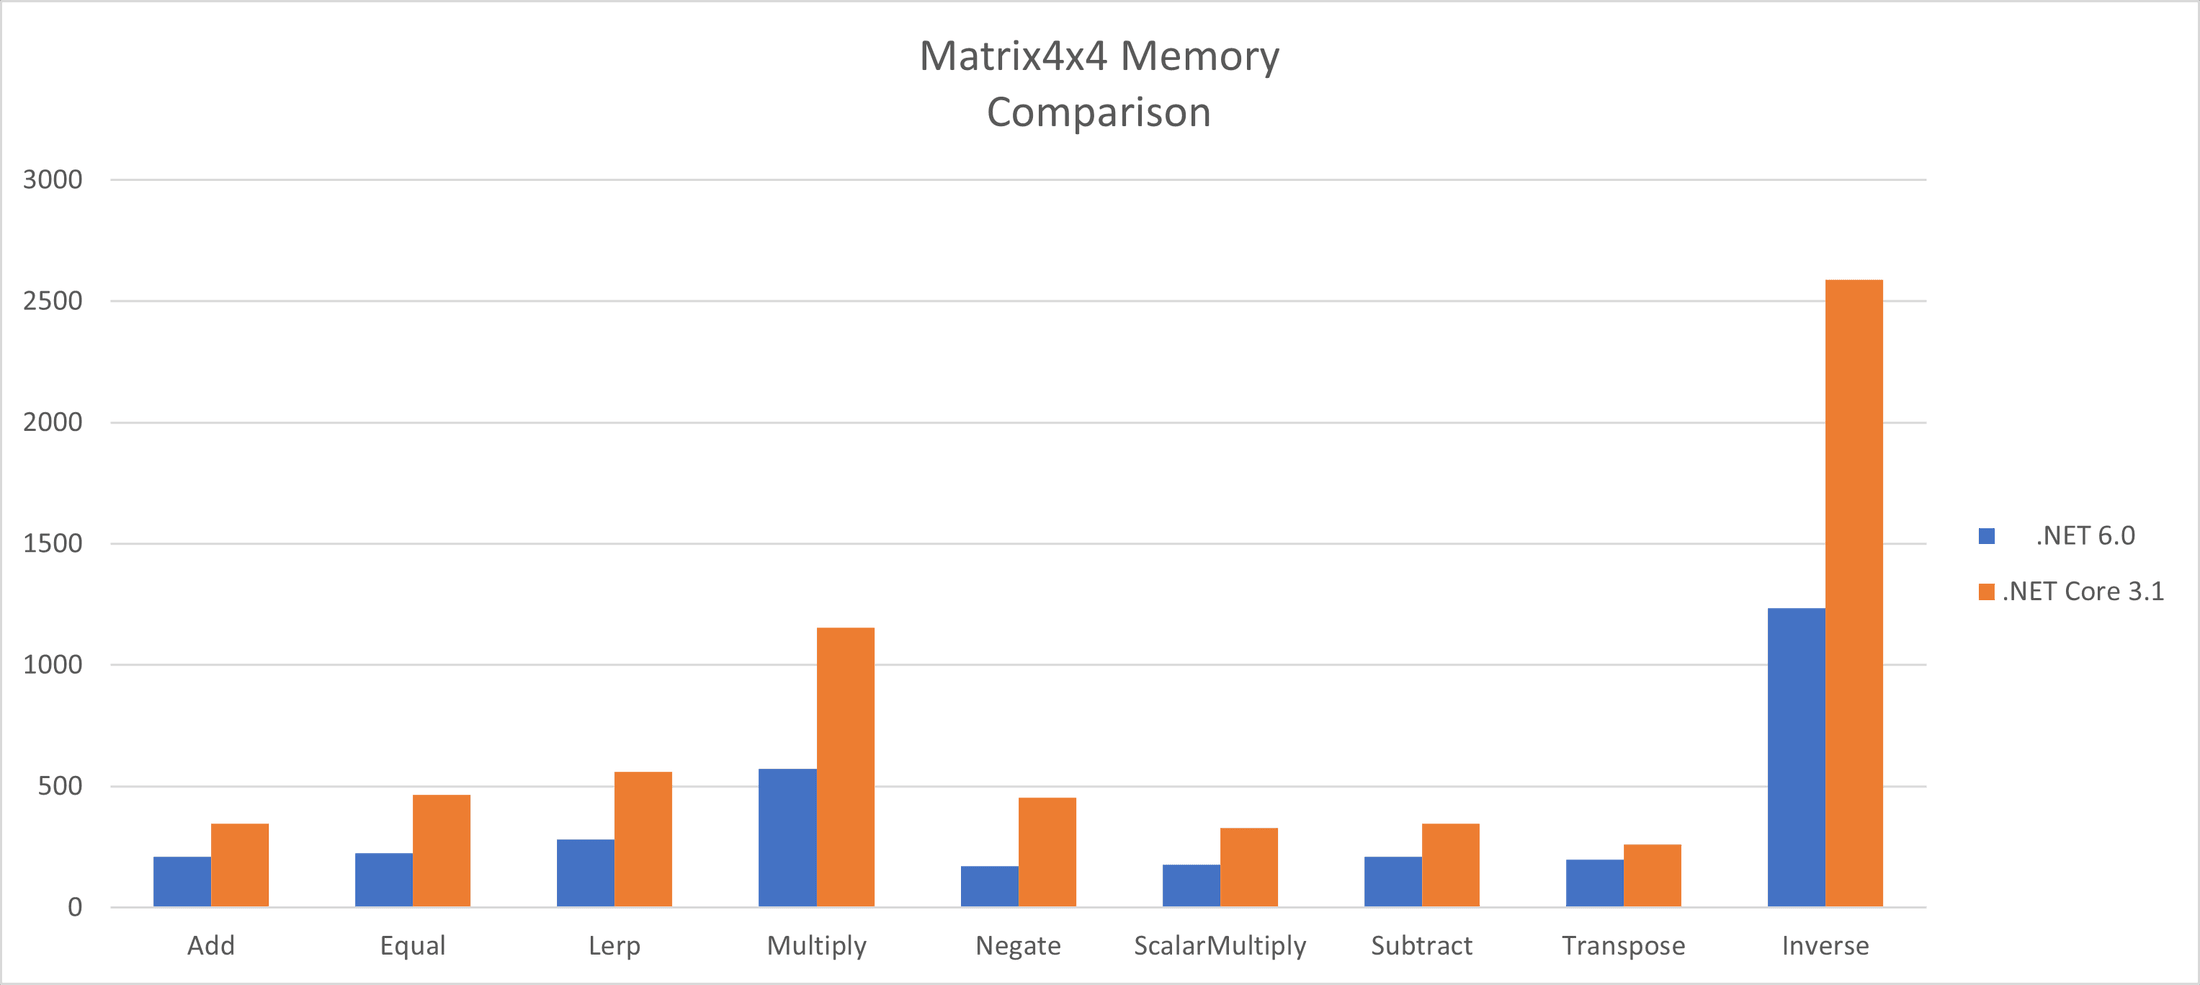
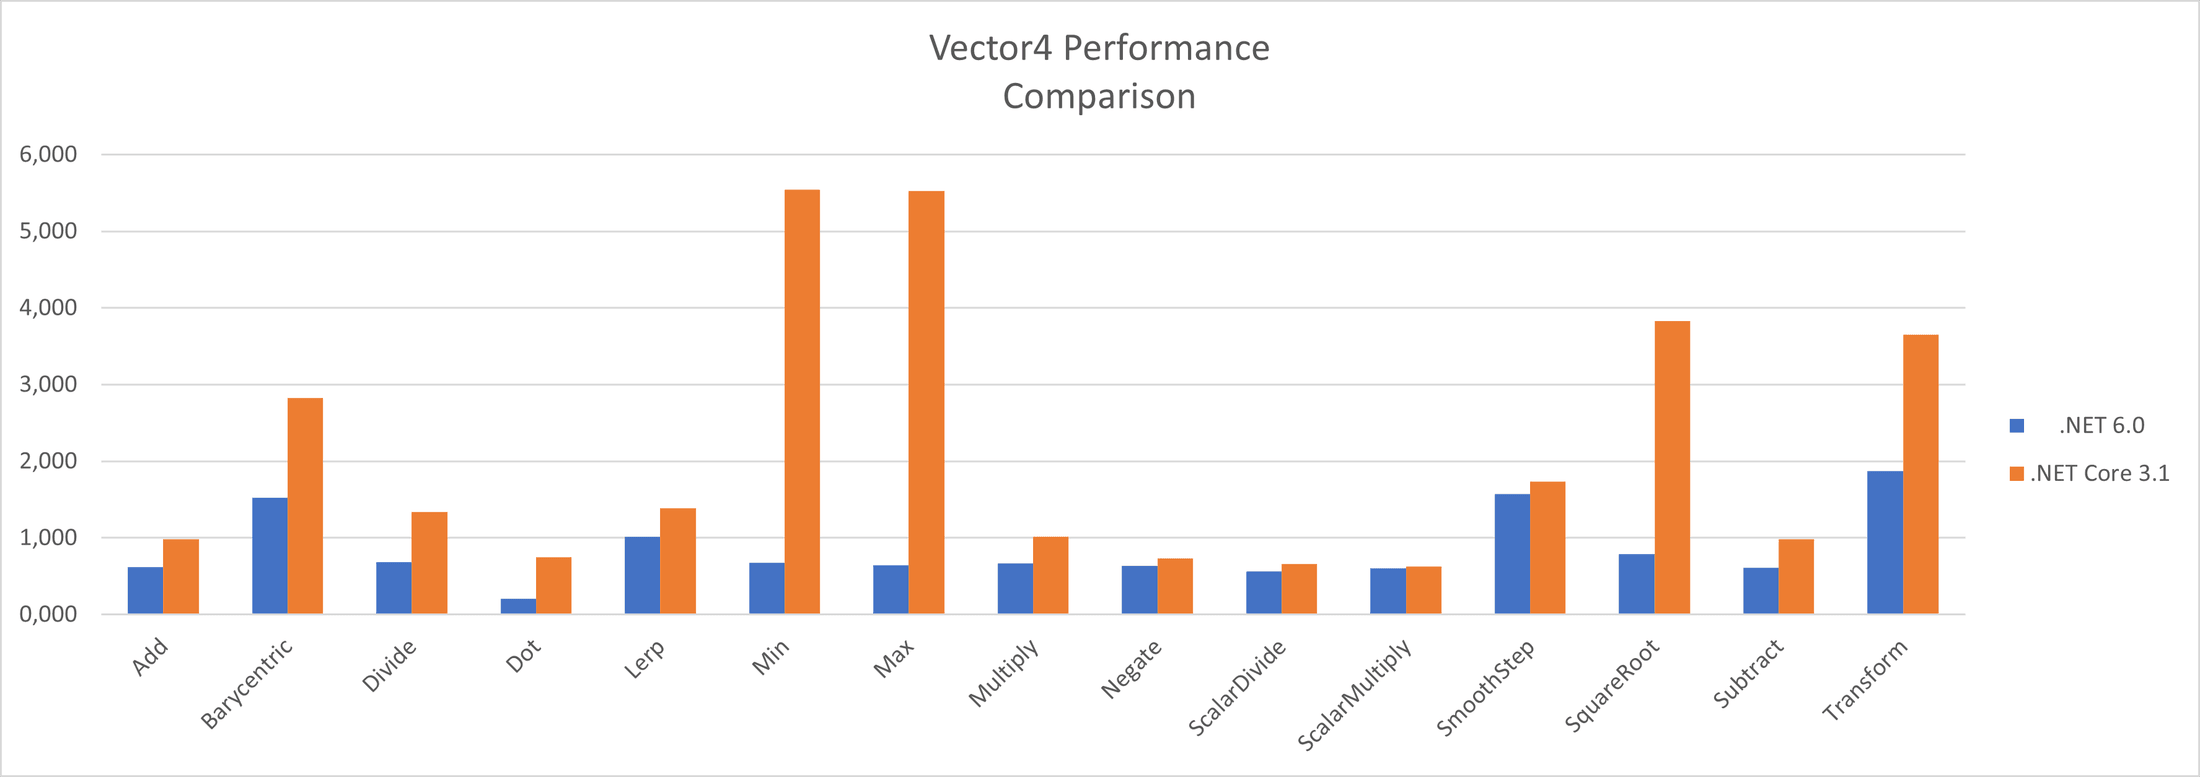
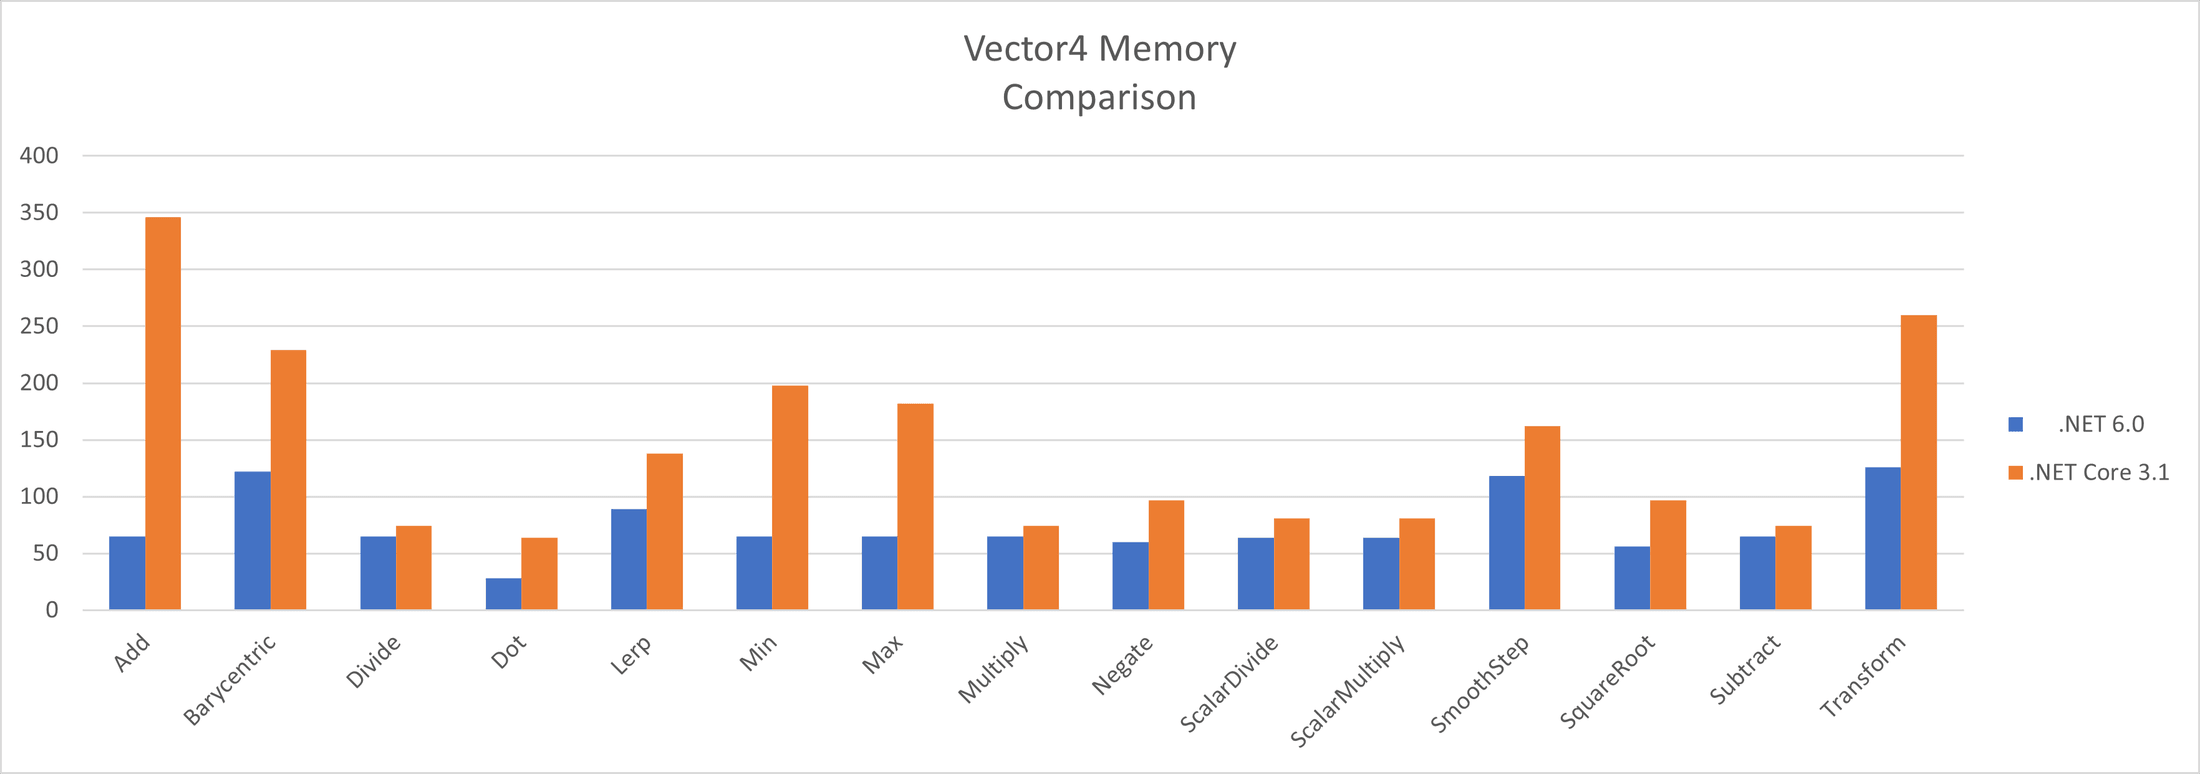
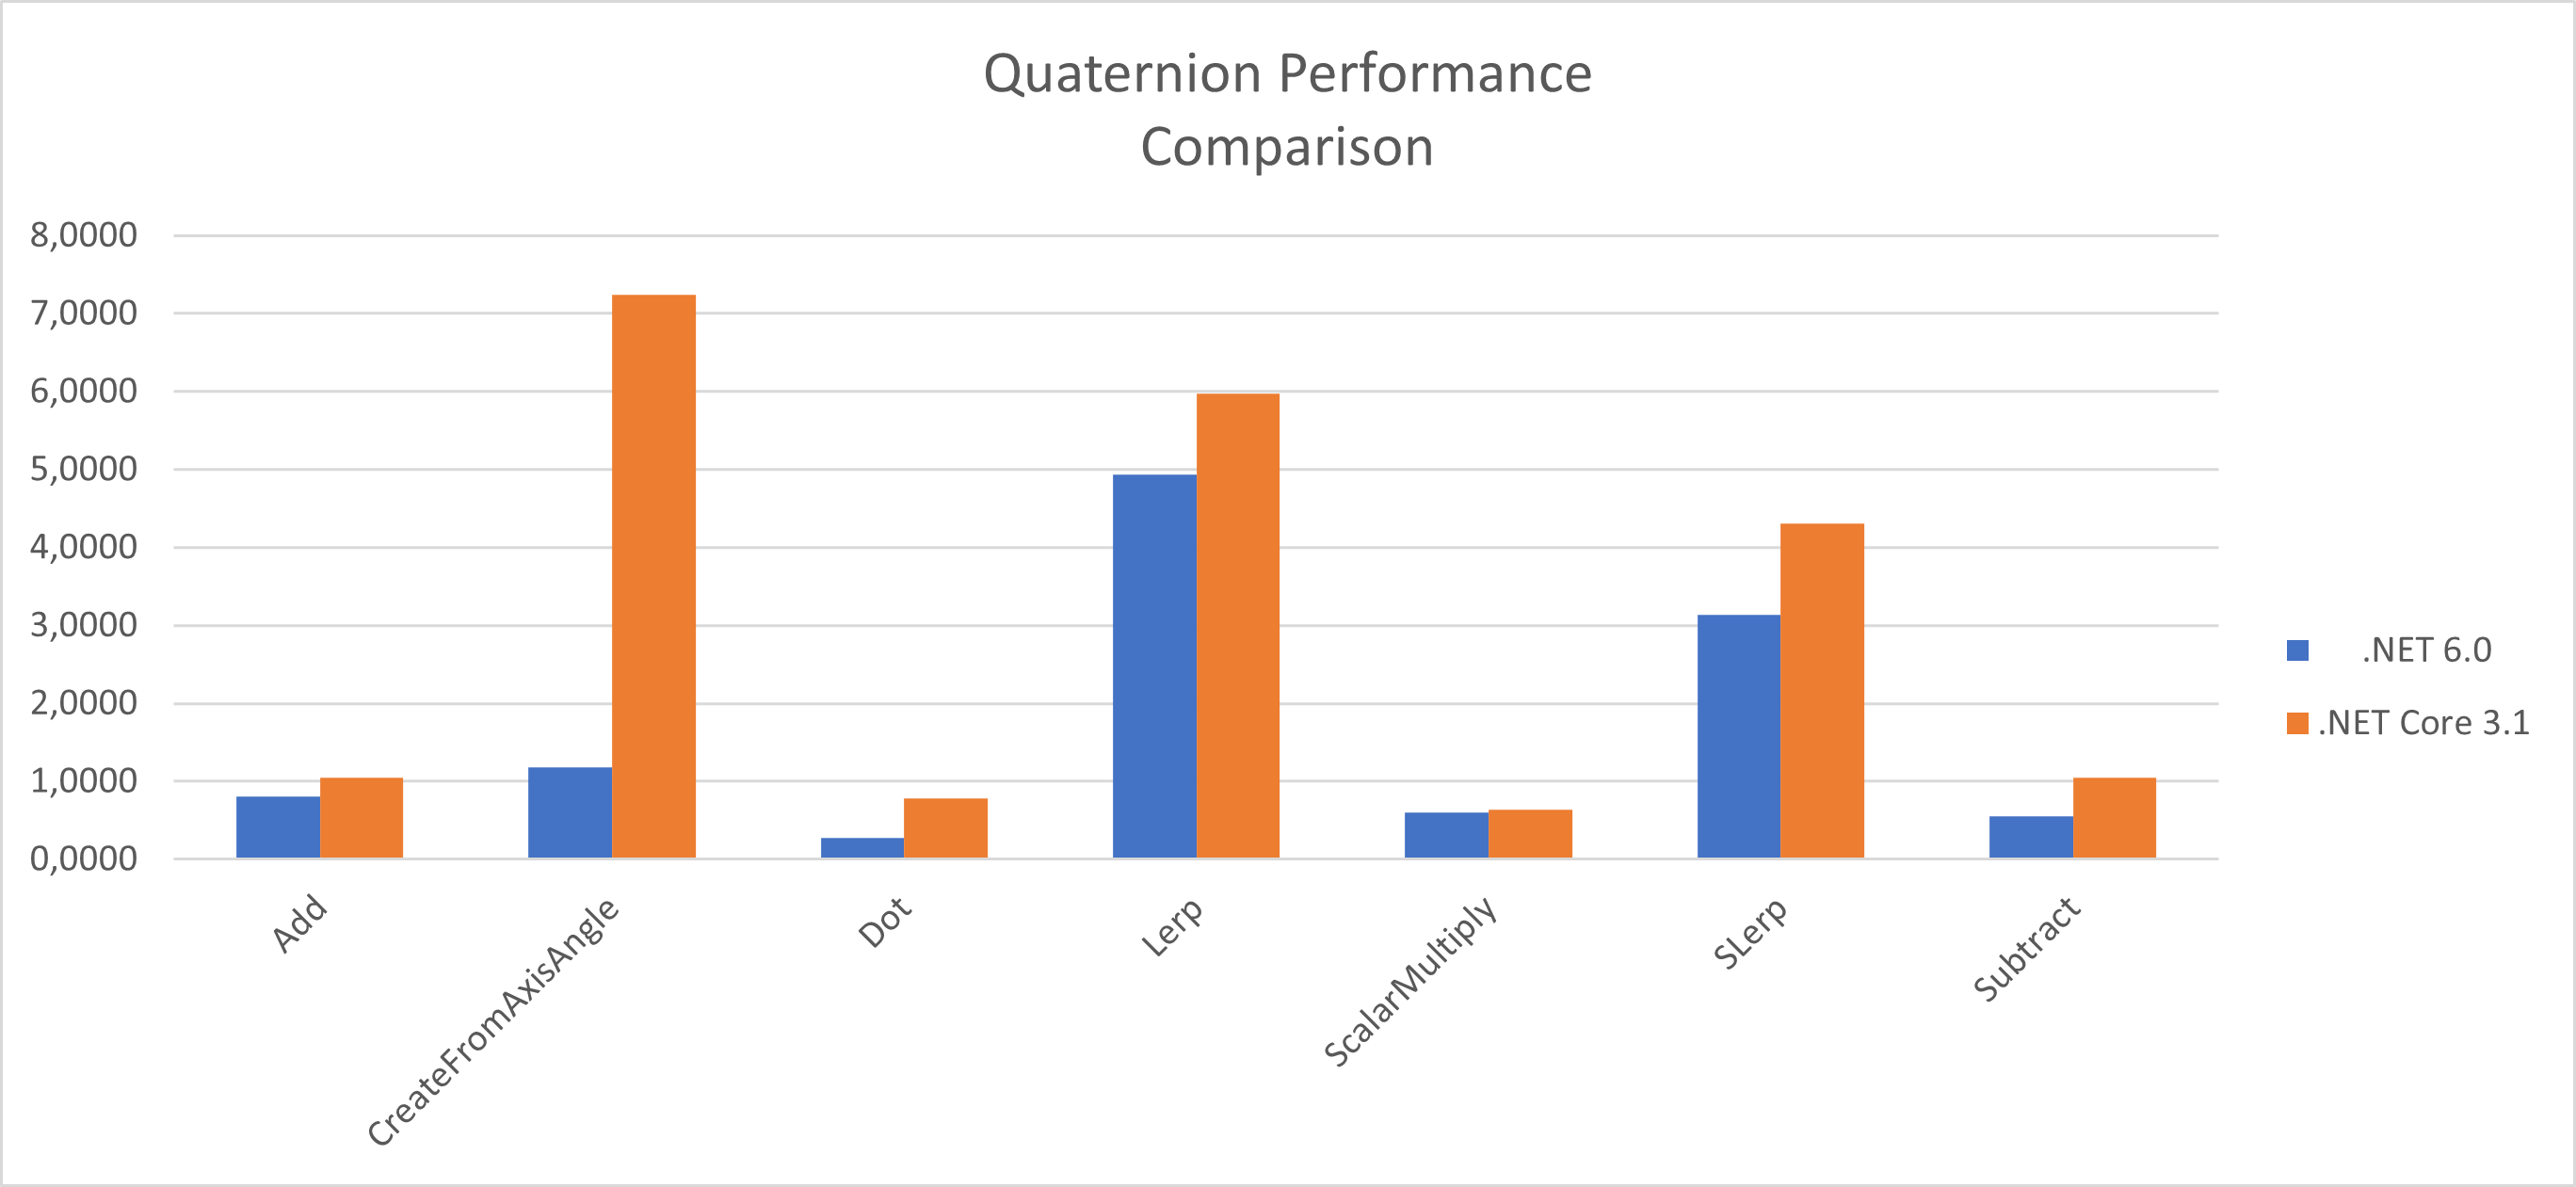
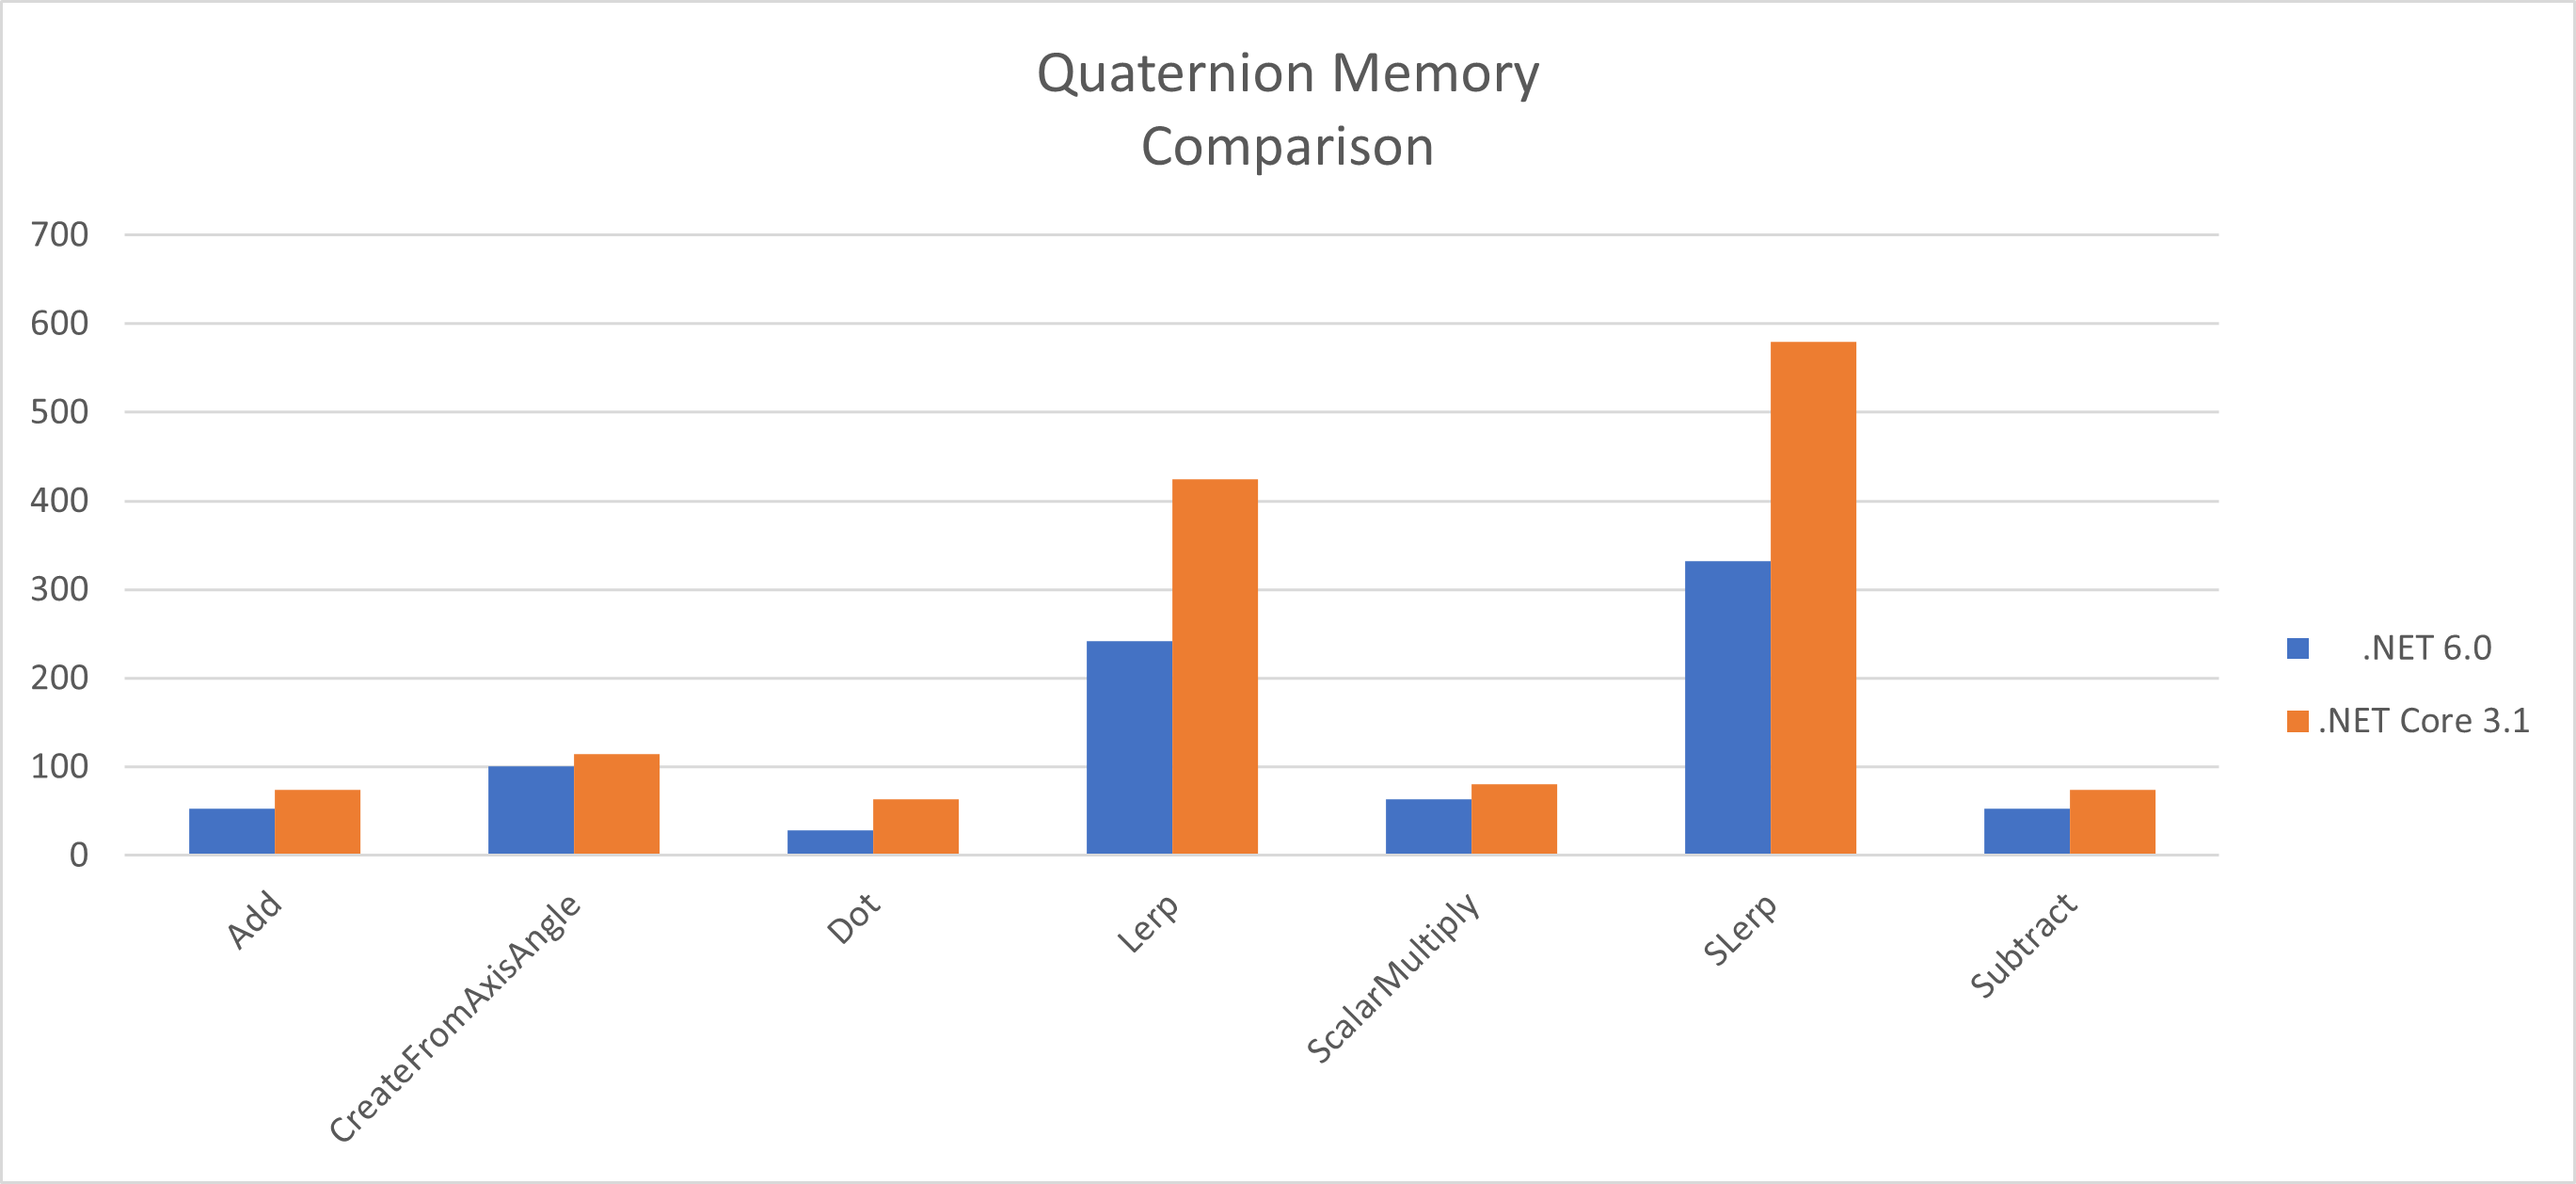
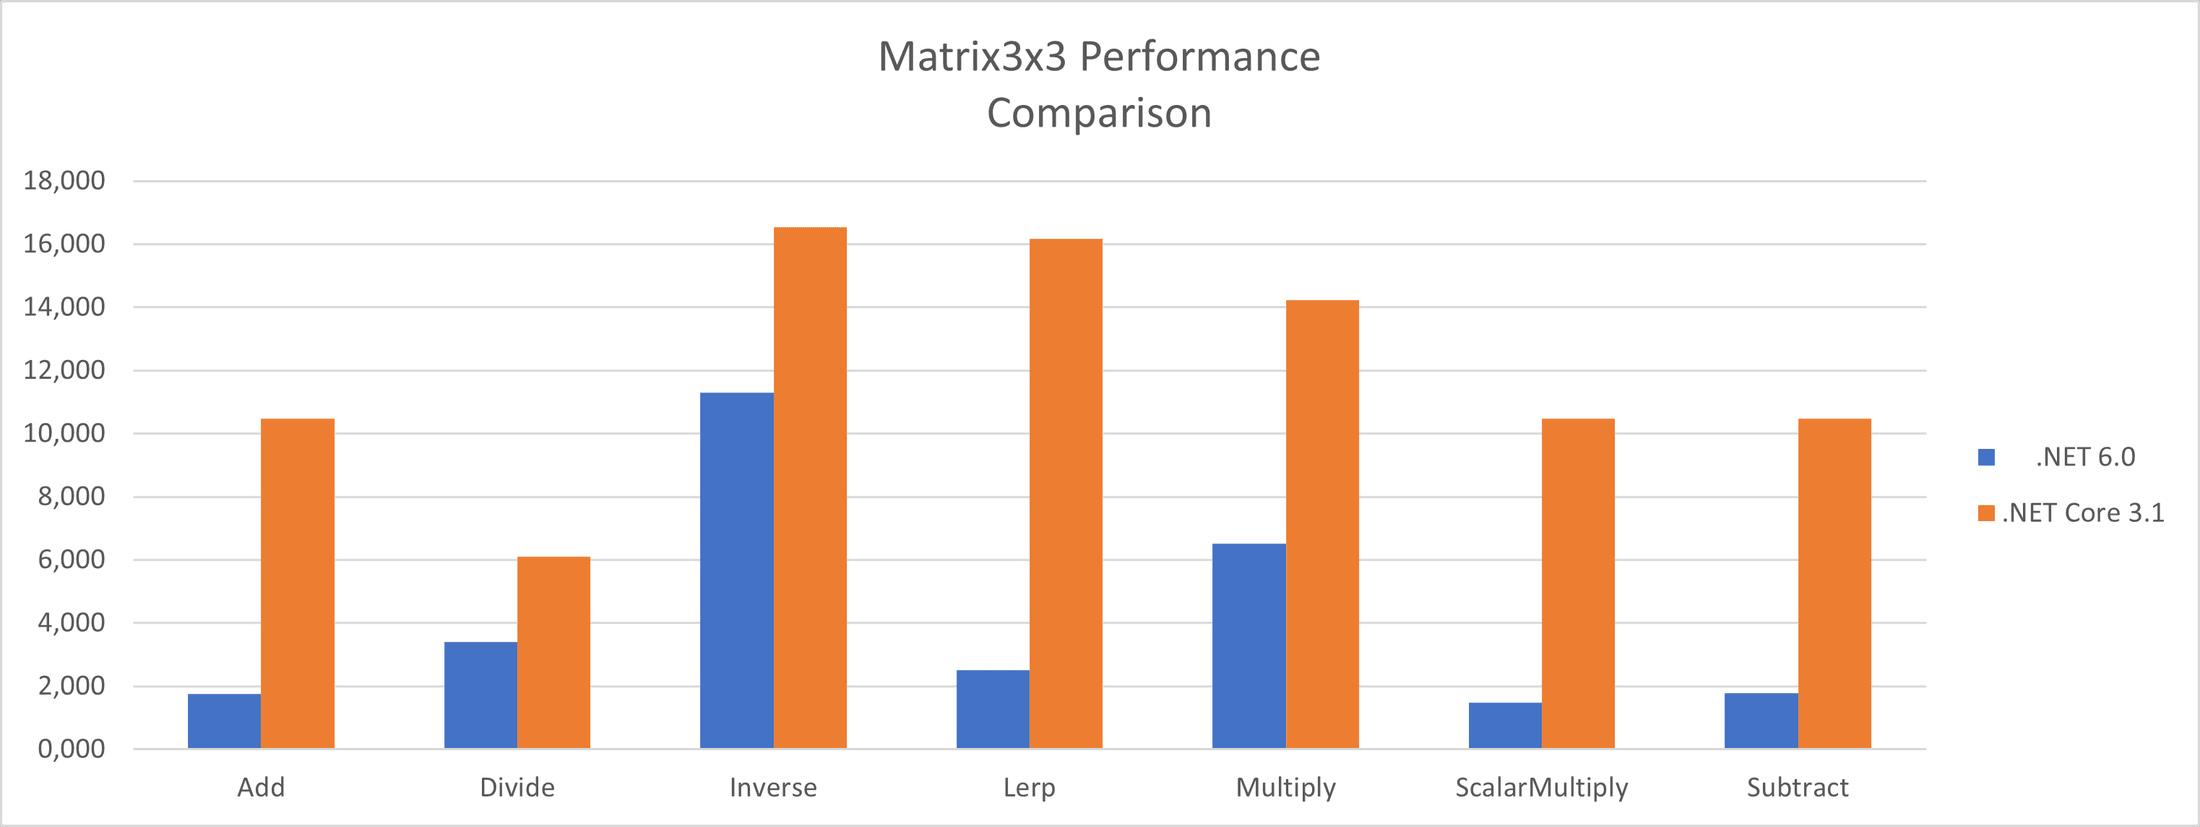
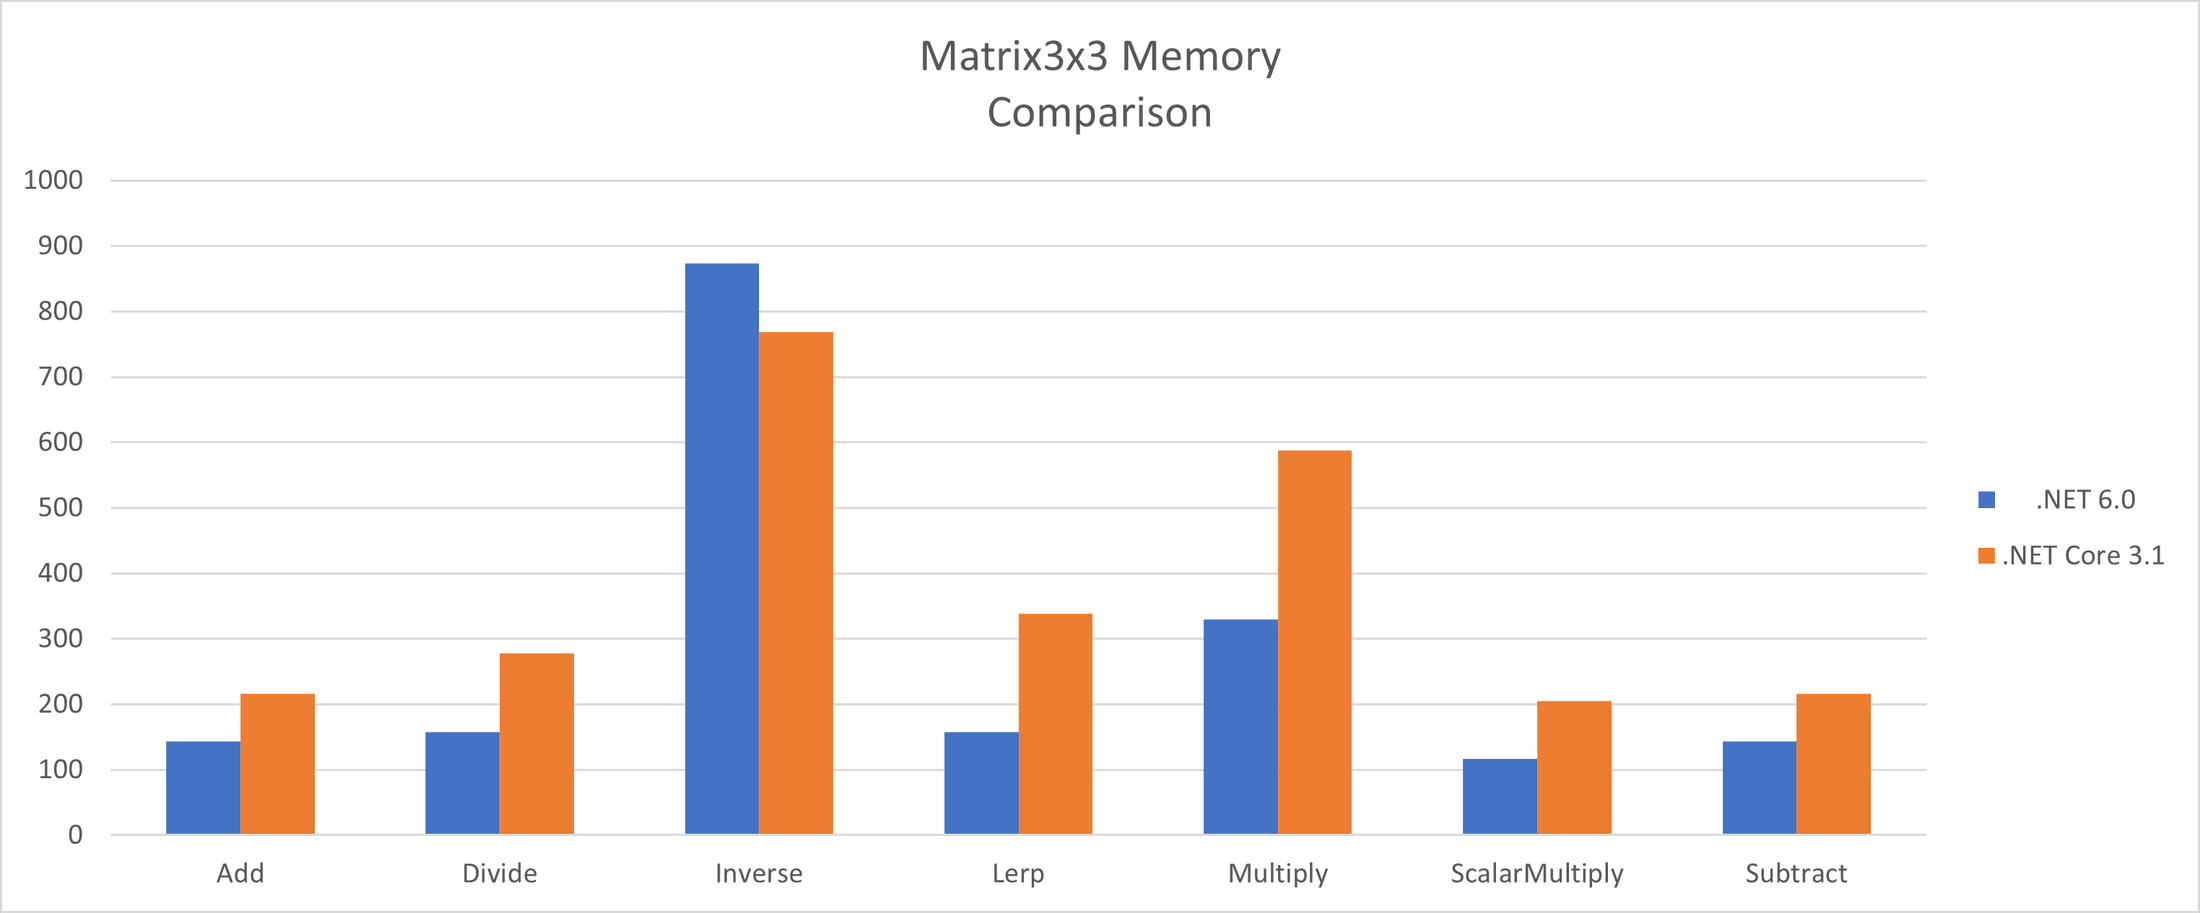
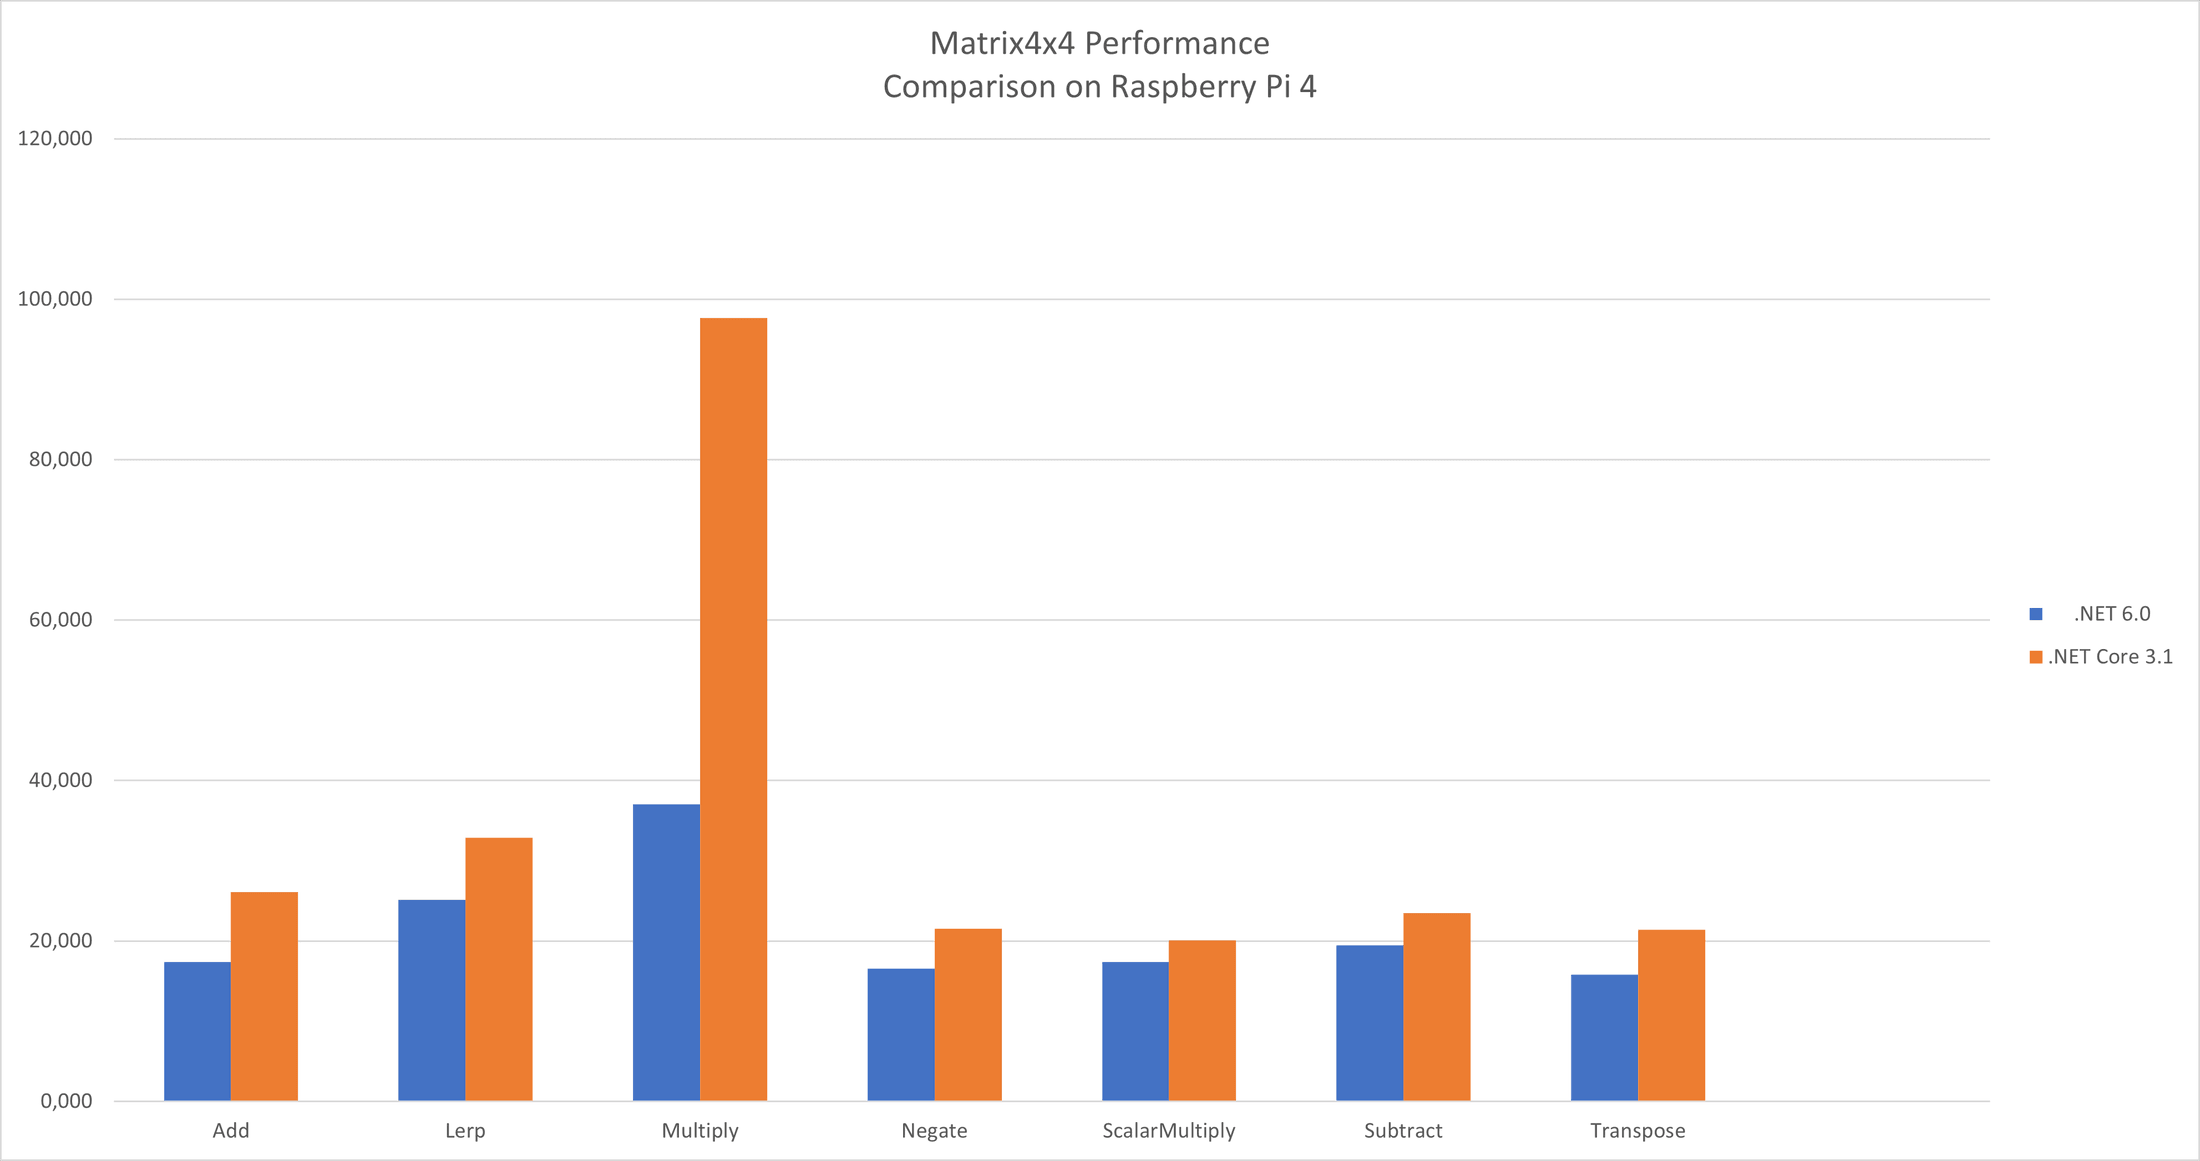
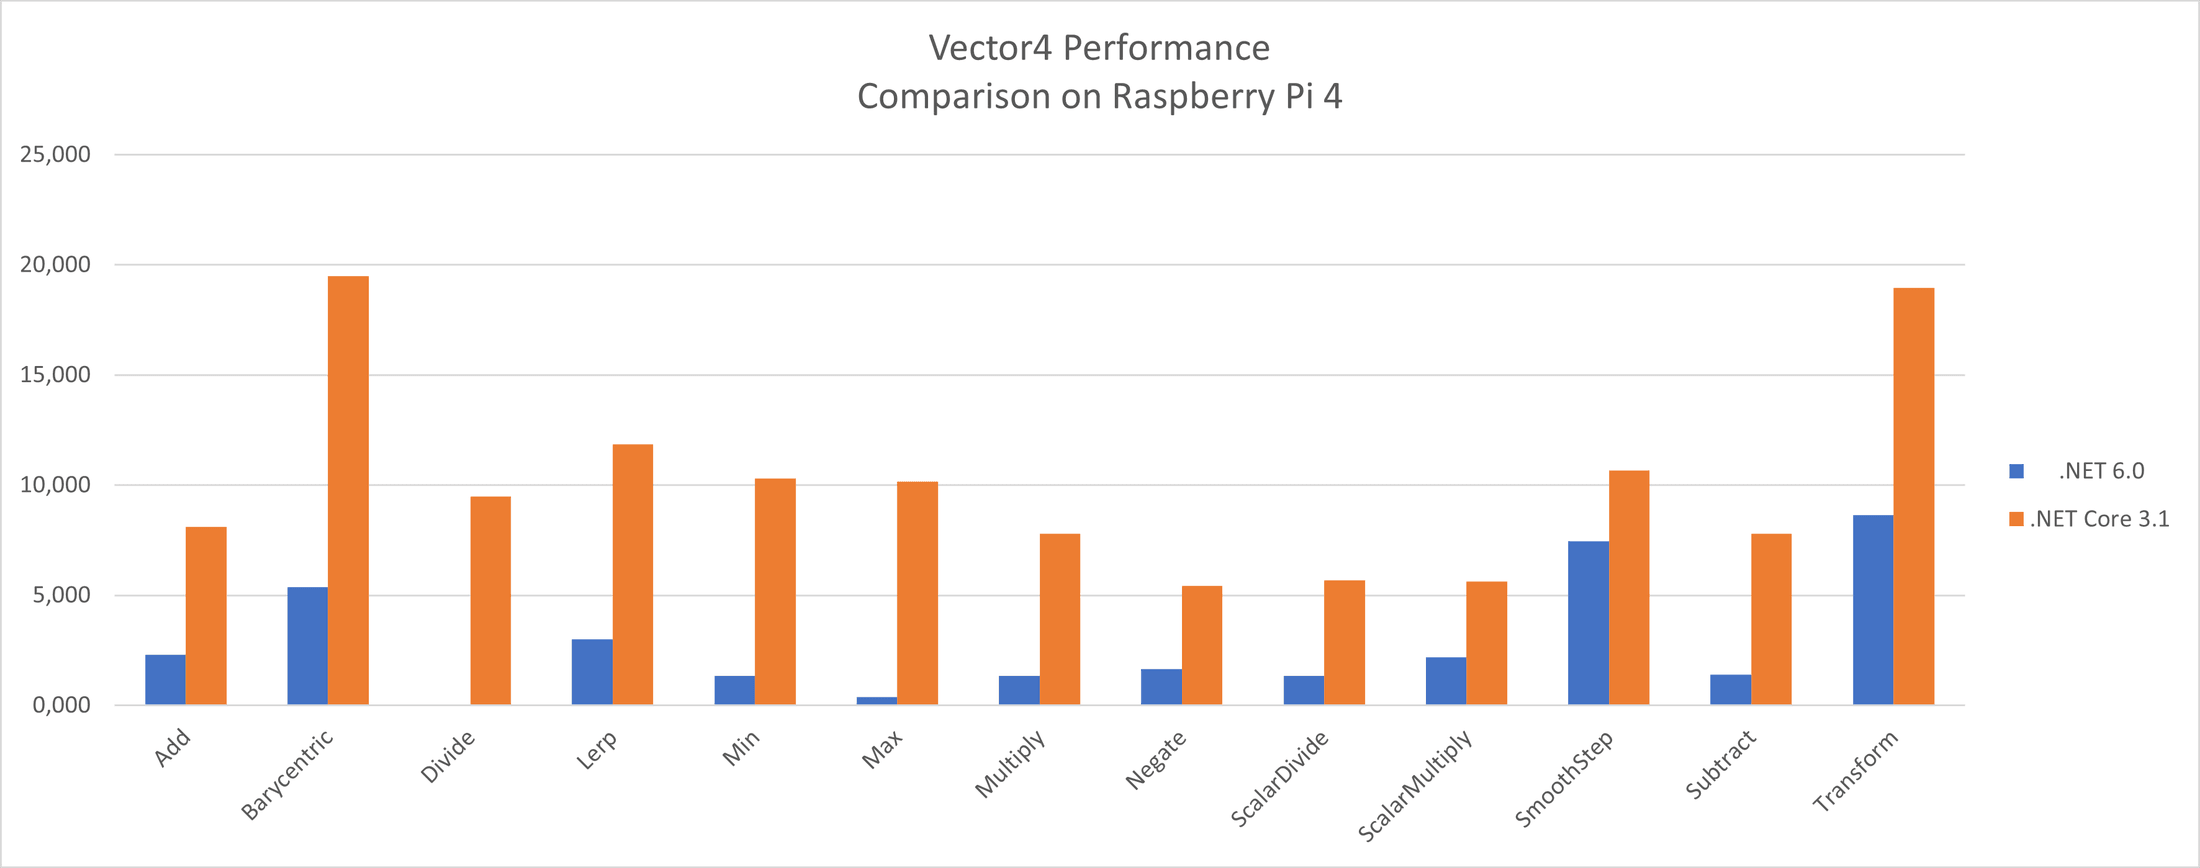
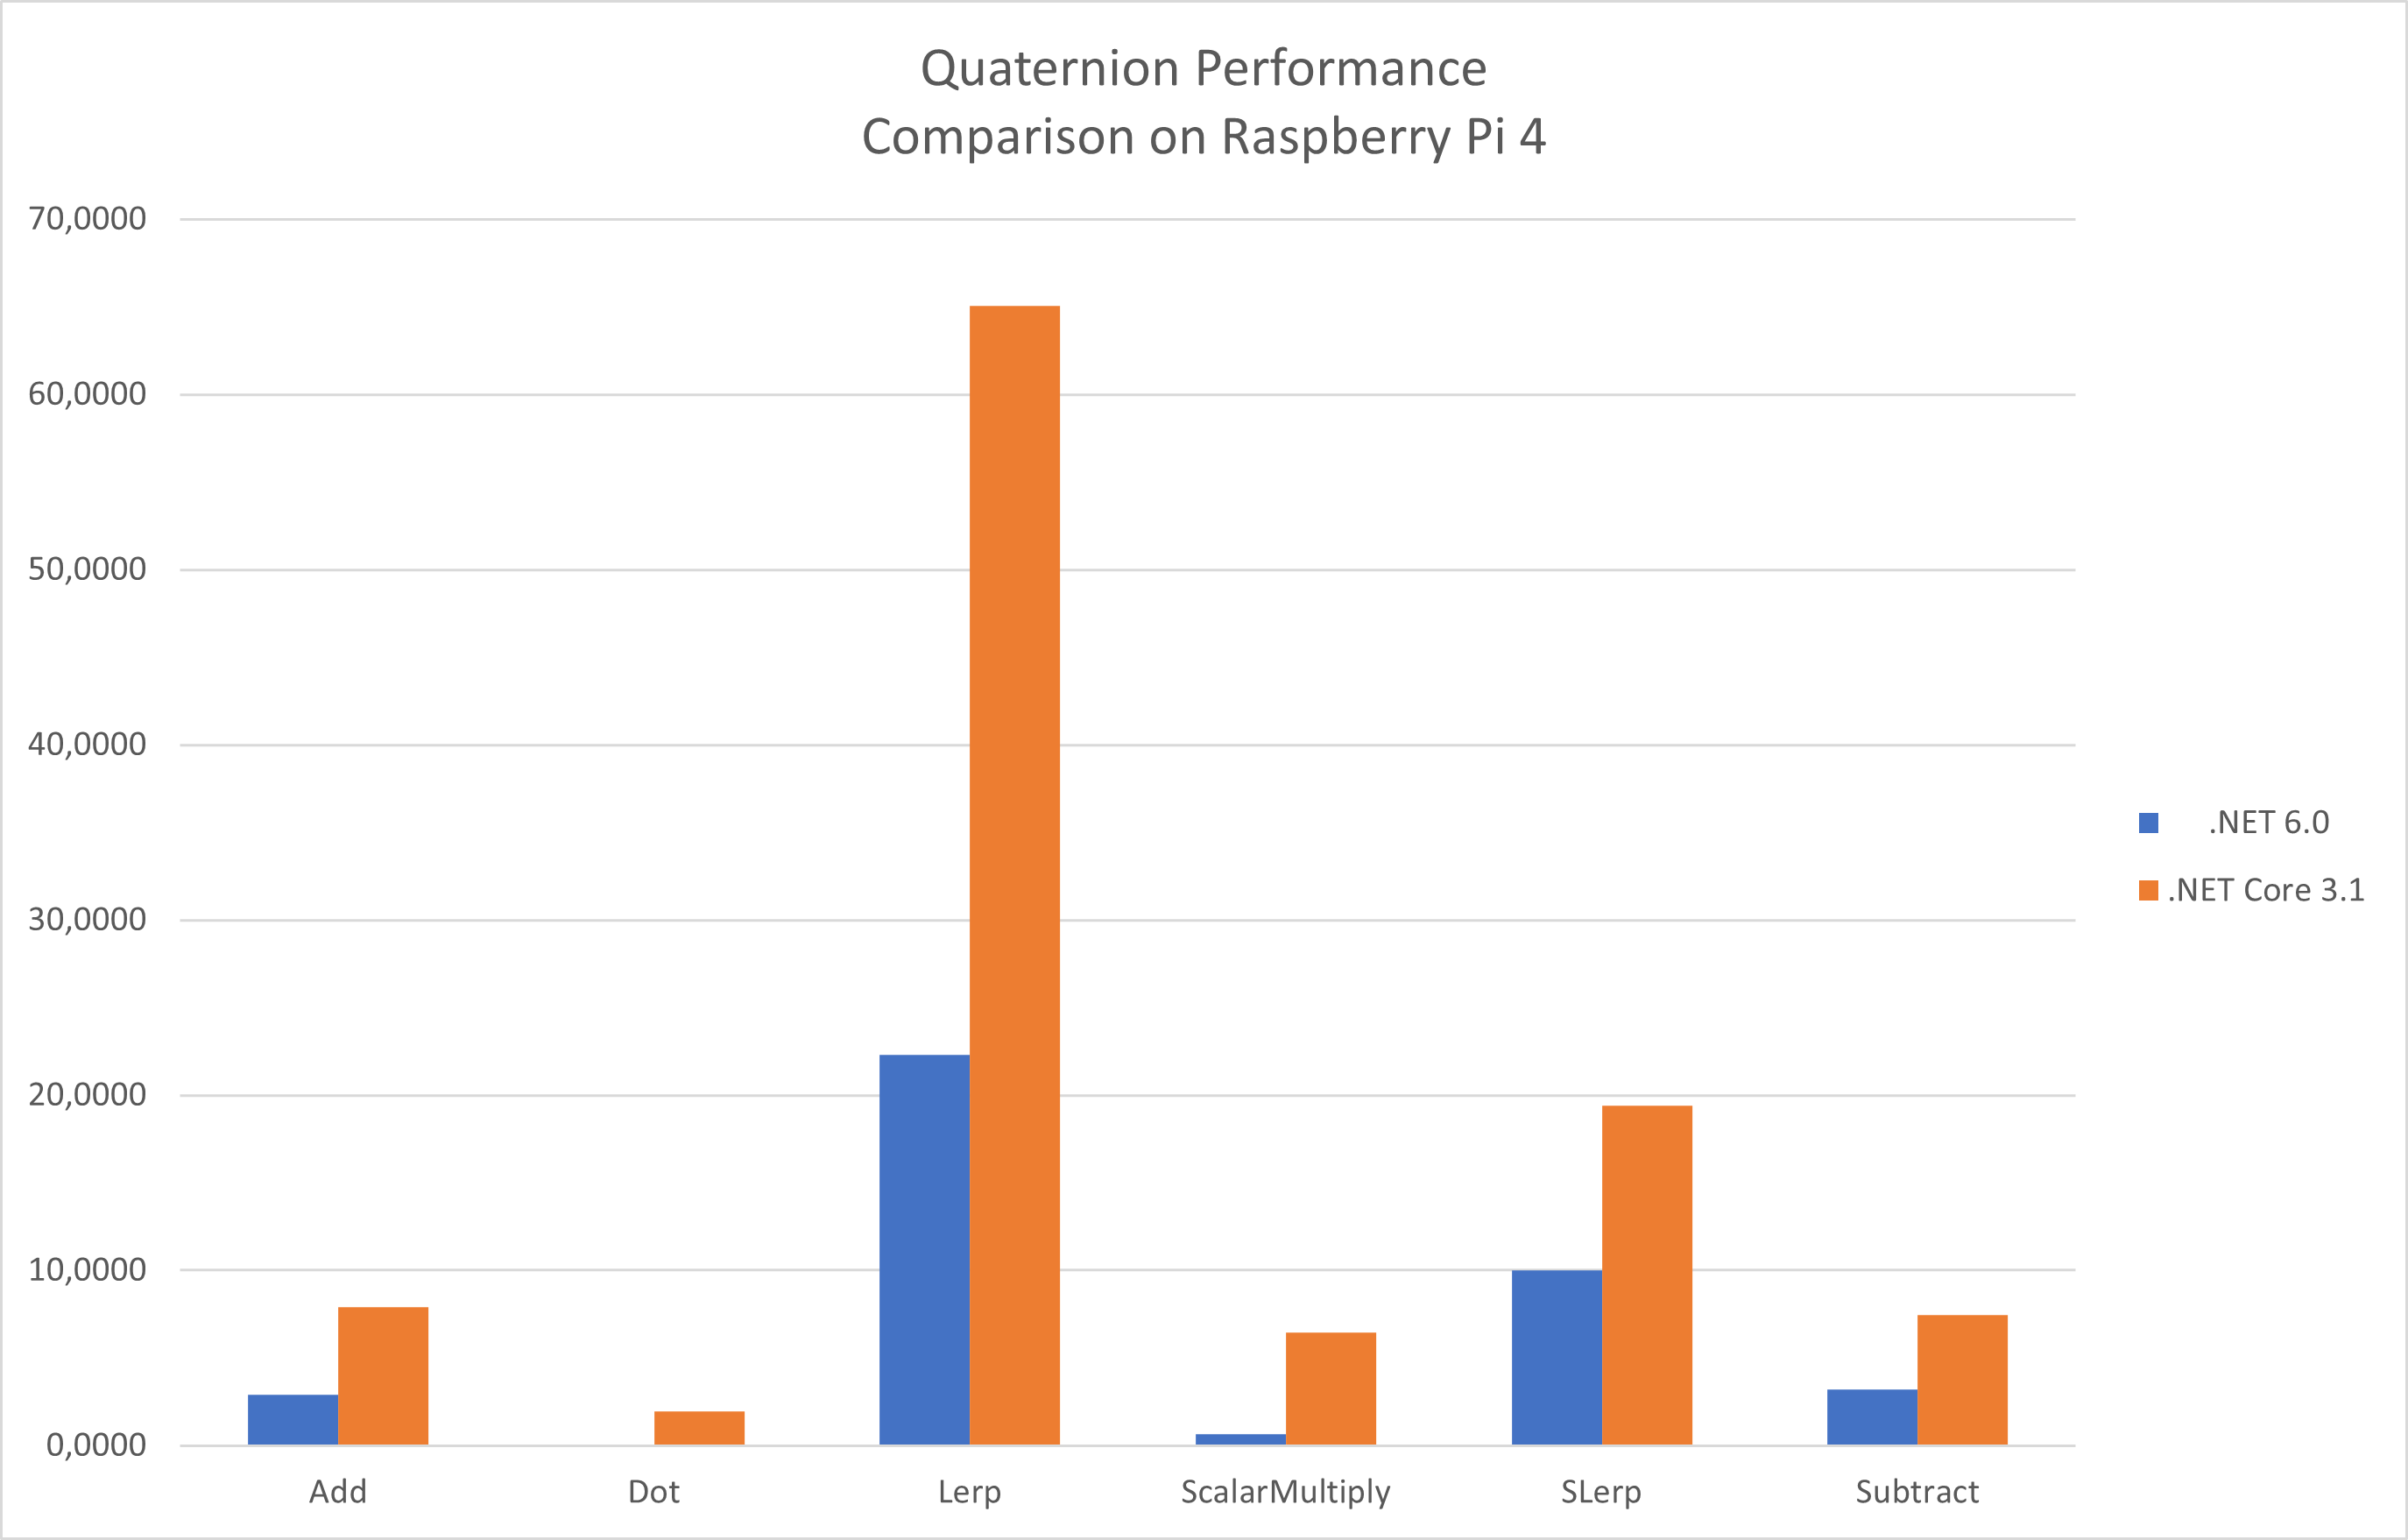
我们还开发了一条面向 ARM64 架构的新路径。为了对这条新路径进行基准测试,我们使用了 Raspberry Pi4。在该架构中,我们在可能的情况下使用 ARM AdvSimd 指令集。以下是在 Ubuntu 22.04.1 LTS(Raspberry Pi4)上生成的结果。
摘要
全新的Evergine.Mathematics库速度极快,可让您充分利用所运行机器的平台特定功能。得益于在x86和x64架构上使用SSE和AVX指令,以及在ARM64设备上使用AdvSimd,其速度比之前提升了3-4倍。
下一步就看您的了,下载新版本,借助全新的Evergine.Mathematics库,在您的所有项目中开始使用这些性能改进。