Mathematik schneller denn je
Mit dem neuen Evergine 2022.9.28 haben wir eine neue Version unserer Bibliothek Evergine.Mathematics veröffentlicht, die einen von den CPU-Herstellern entwickelten hardwarebeschleunigten Befehlssatz nutzt.
Möglich wird dies durch die neue Hardware-Intrinsics-API für Net6, mit der sich SIMD-Befehle (Single Instruction, Multiple Data) auf den Zielarchitekturen x86, x64 und ARM64 nutzen lassen, sofern die Hardware sie unterstützt. Mit dieser neuen API können wir prüfen, ob diese Erweiterungen in der Hardware vorhanden sind, und gegebenenfalls 128- und 256-Bit-Registervektoren verwenden, um den Code zu vektorisieren und mehrere primitive Operationen in einem einzigen Zyklus auszuführen (ein Zyklus ist die grundlegende Zeiteinheit einer CPU).
Wir haben diese Befehle genutzt, um Operationen in den wichtigsten Structs unserer Bibliothek Evergine.Mathematics wie Matrix4x4, Vector4, Matrix3x3 und Quaternion zu optimieren – und die Ergebnisse sind beeindruckend.
Benchmarks
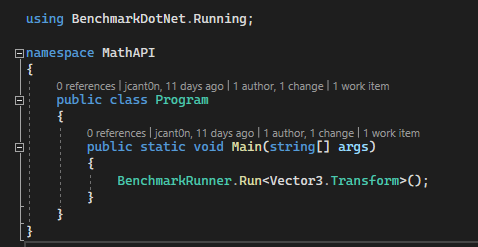
Für einige Microbenchmarks haben wir benchmarkdotnet verwendet. Dies ist das Setup für den Matrix4x4-Vergleich.
Der Inhalt der Datei program.cs:
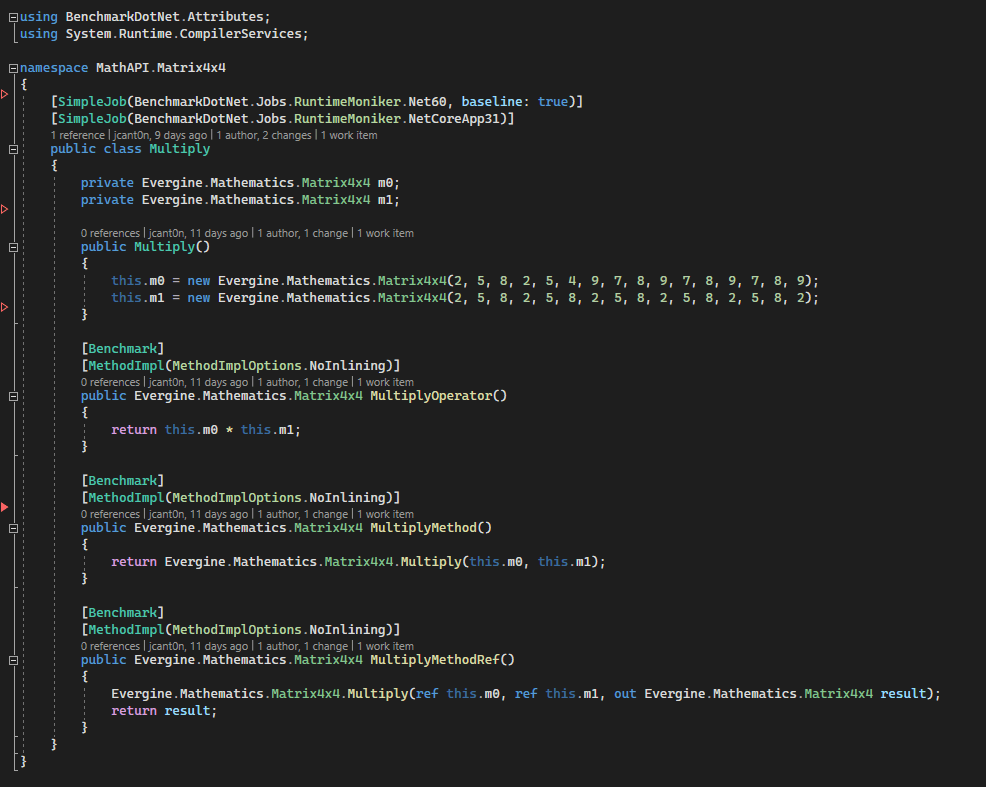
Der Inhalt des Matrix4x4-Multiplikationstests:
Die für alle in diesem Artikel vorgestellten x86- und x64-Benchmarks verwendete CPU ist:
Intel Core i9-10980HK CPU 2.40GHz, 1 CPU, 16 logische und 8 physische Kerne
Und dies sind die von benchmarkdotnet erzeugten detaillierten Ergebnisse:
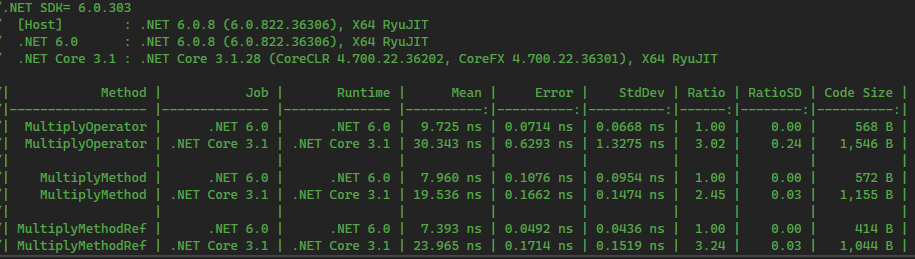
Wie Sie sehen, benötigt der neue Pfad für Net6 – in diesem Fall mit dem SIMD-Befehlssatz SSE – gegenüber dem schnelleren Pfad mit MultiplyMethodRef, bei dem die Matrixparameter als Referenz statt als Kopie übergeben werden, nur 7,393 ns statt 23,965 ns. Auch die Codegröße verringert sich von 1.044 Bytes auf 414 Bytes. Das sind wirklich hervorragende Ergebnisse für eine der am häufigsten verwendeten mathematischen Operationen in einer 3D-Grafik-Engine.
Um die Leistungsverbesserung auf x86- und x64-Architektur zu veranschaulichen, haben wir für jedes mathematische Struct ein Diagramm erstellt.
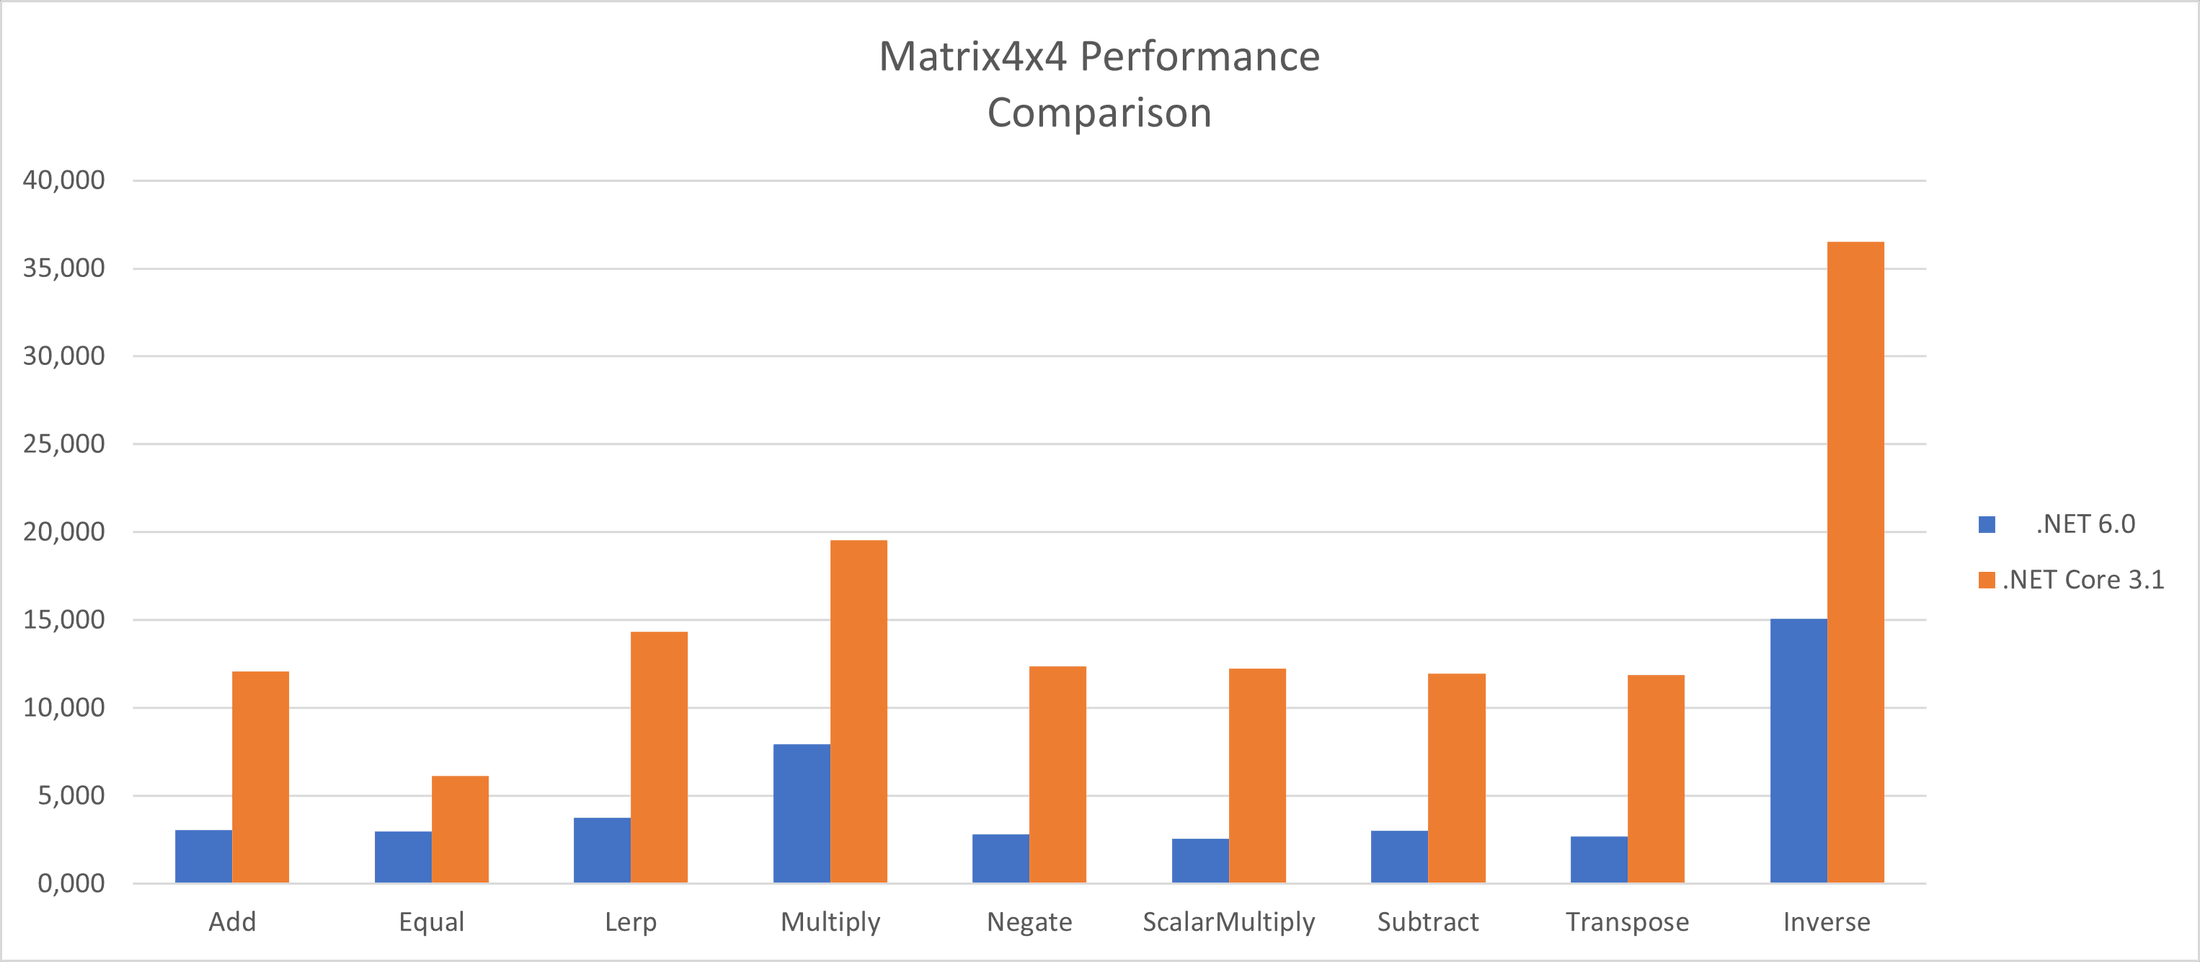
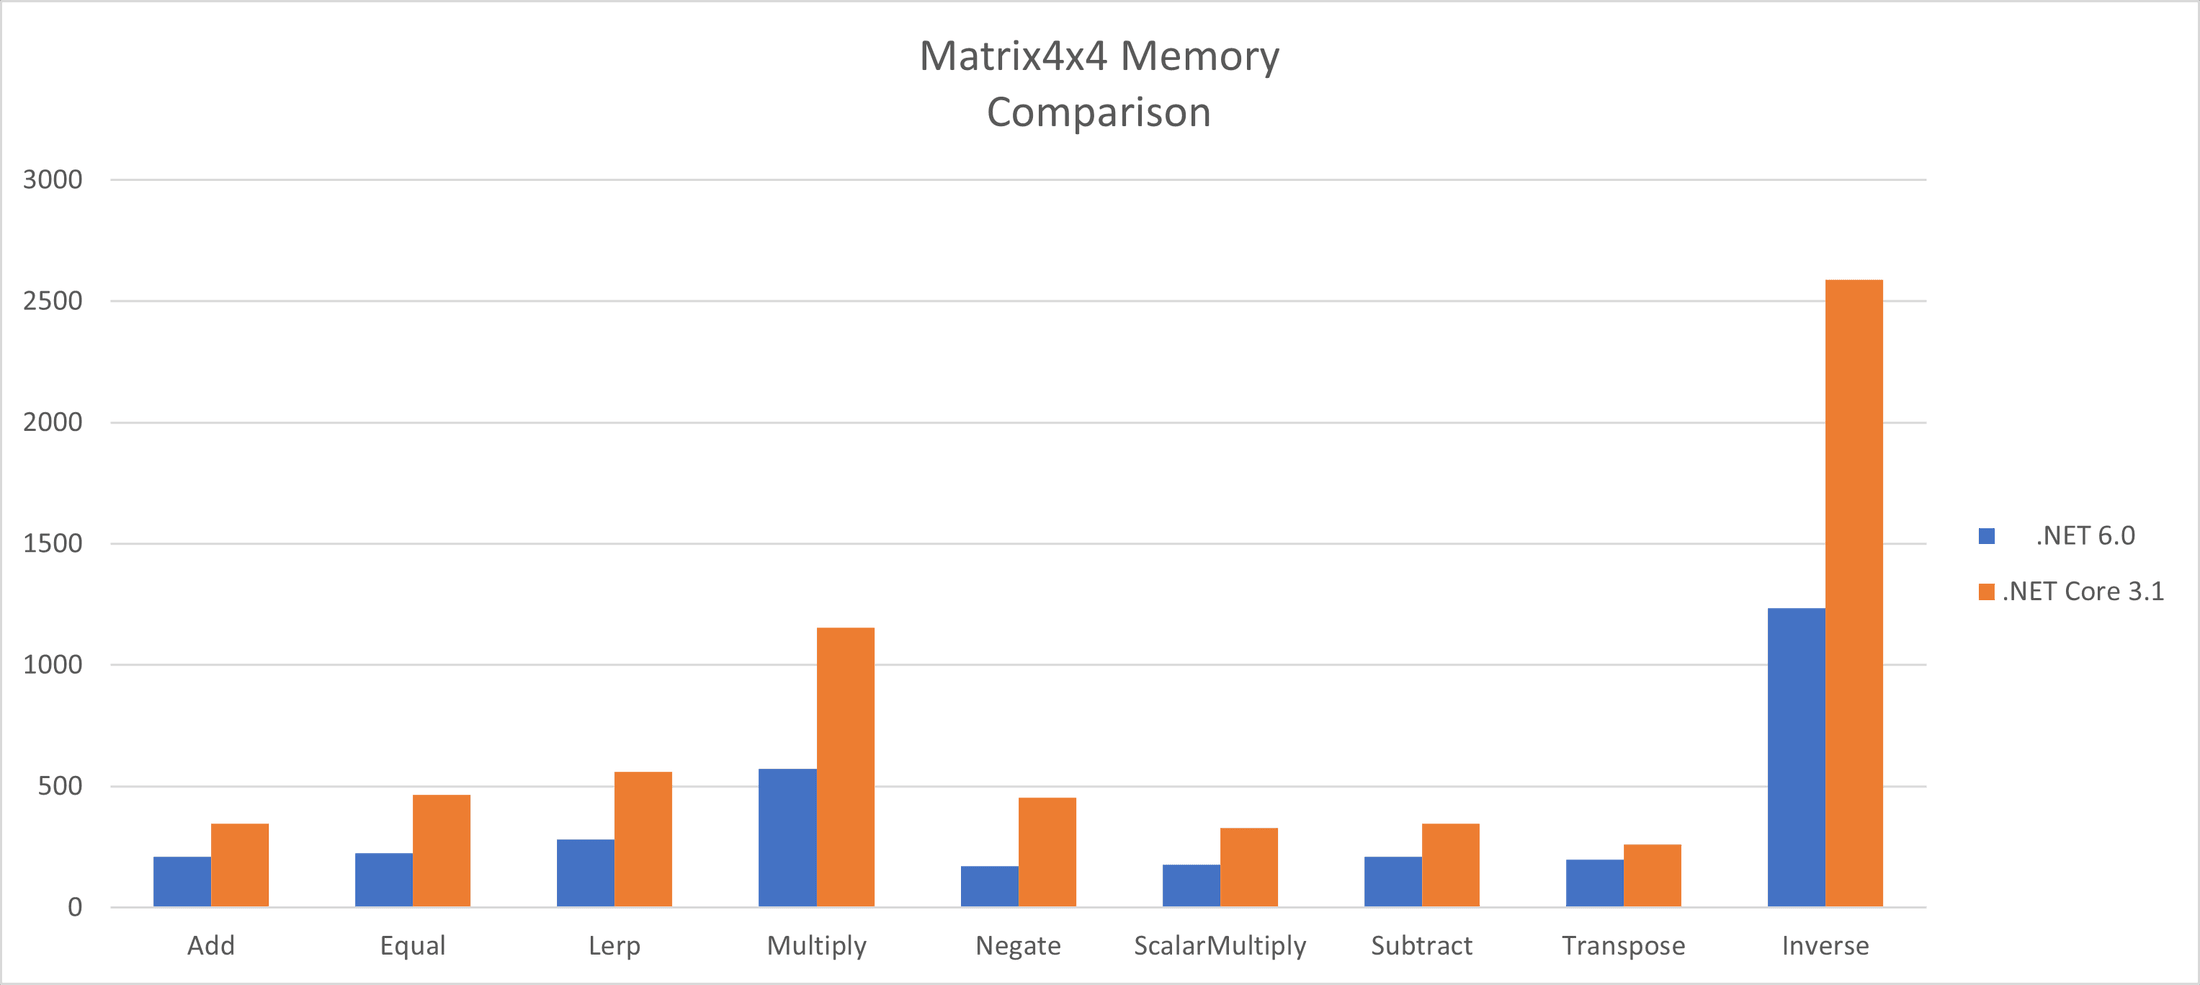
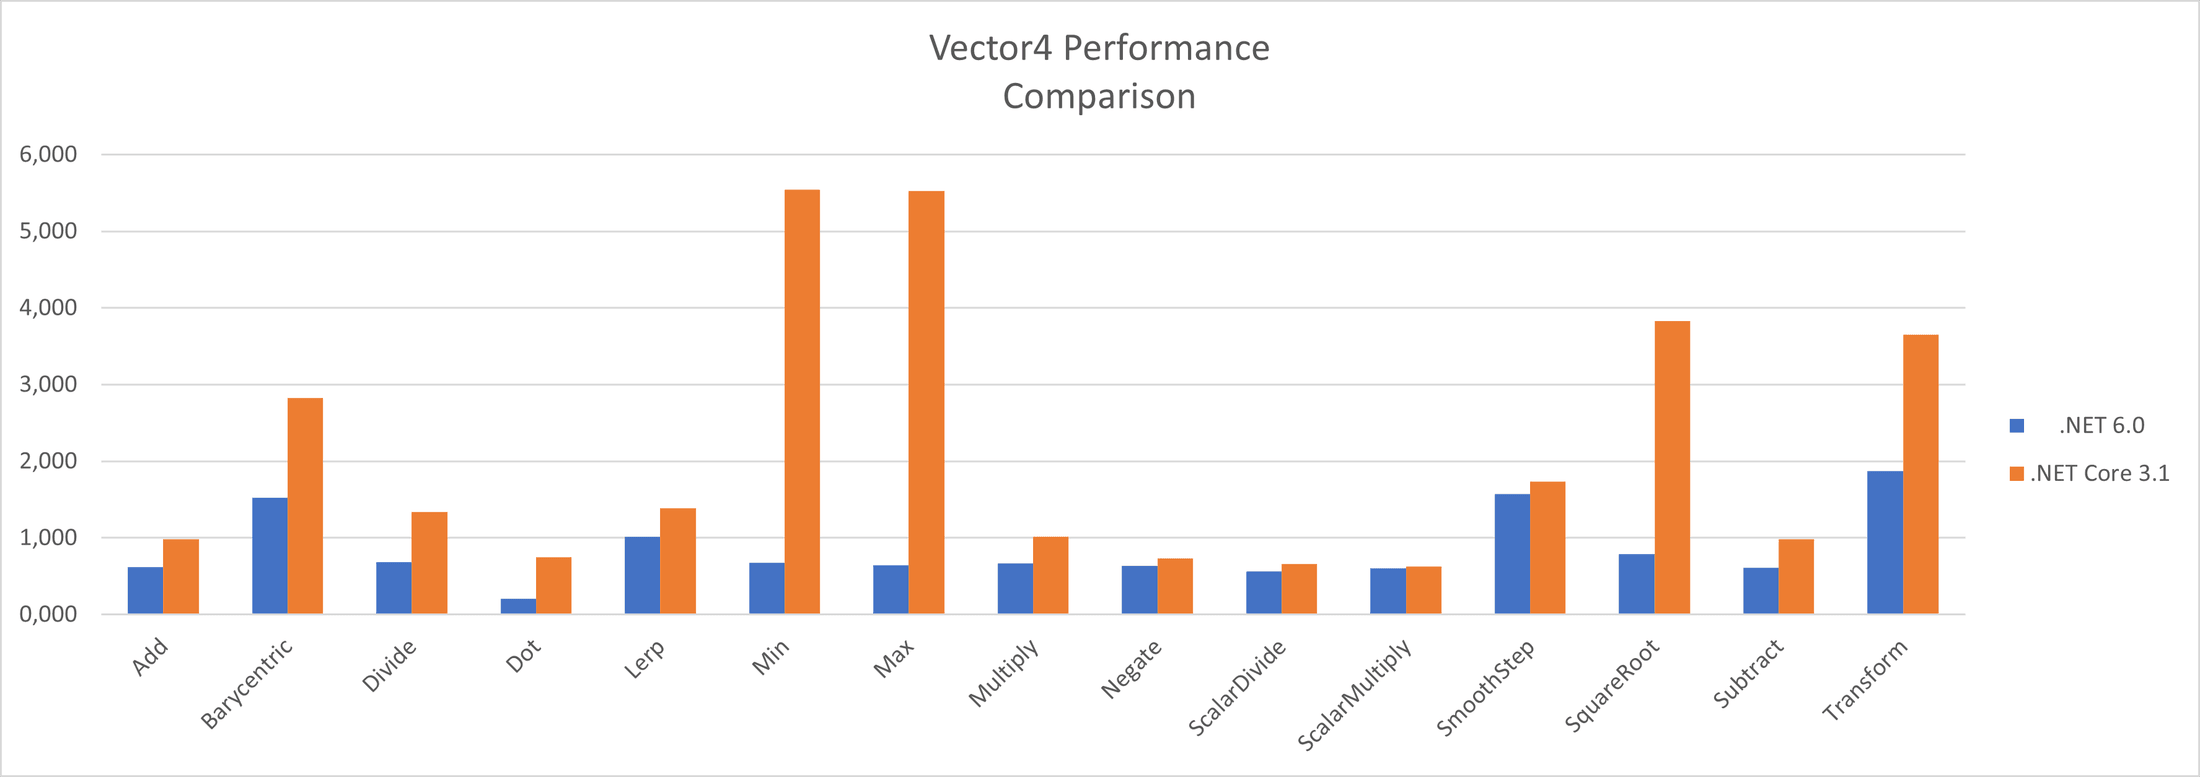
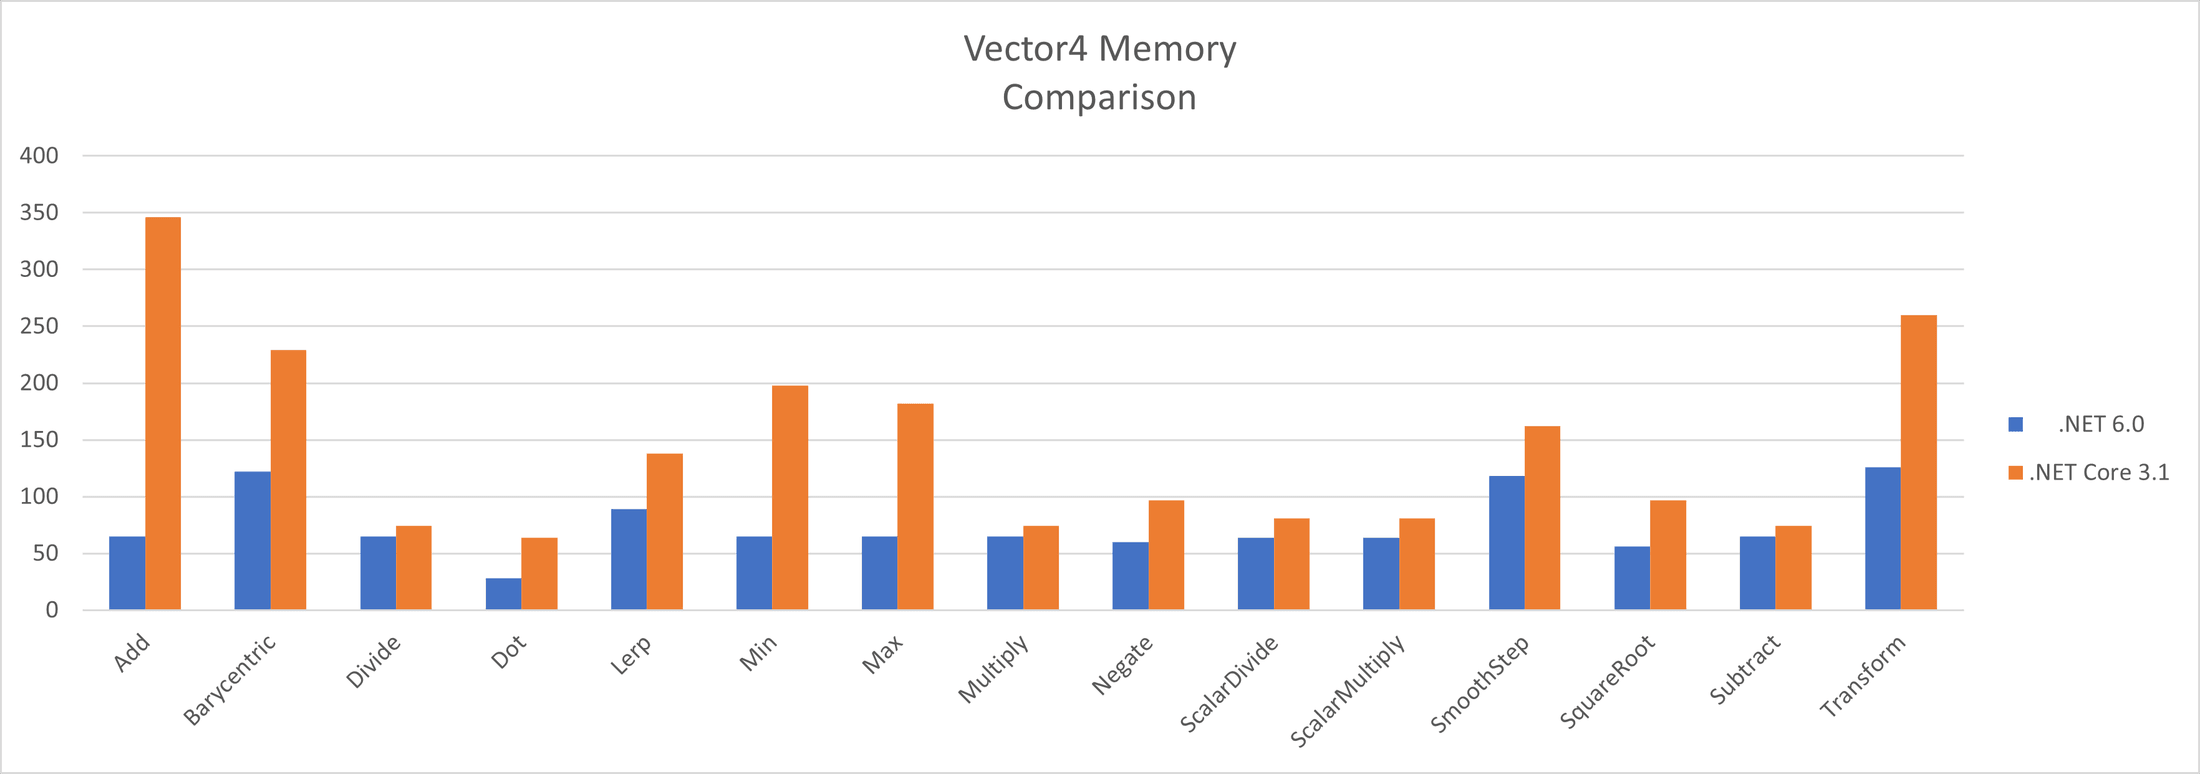
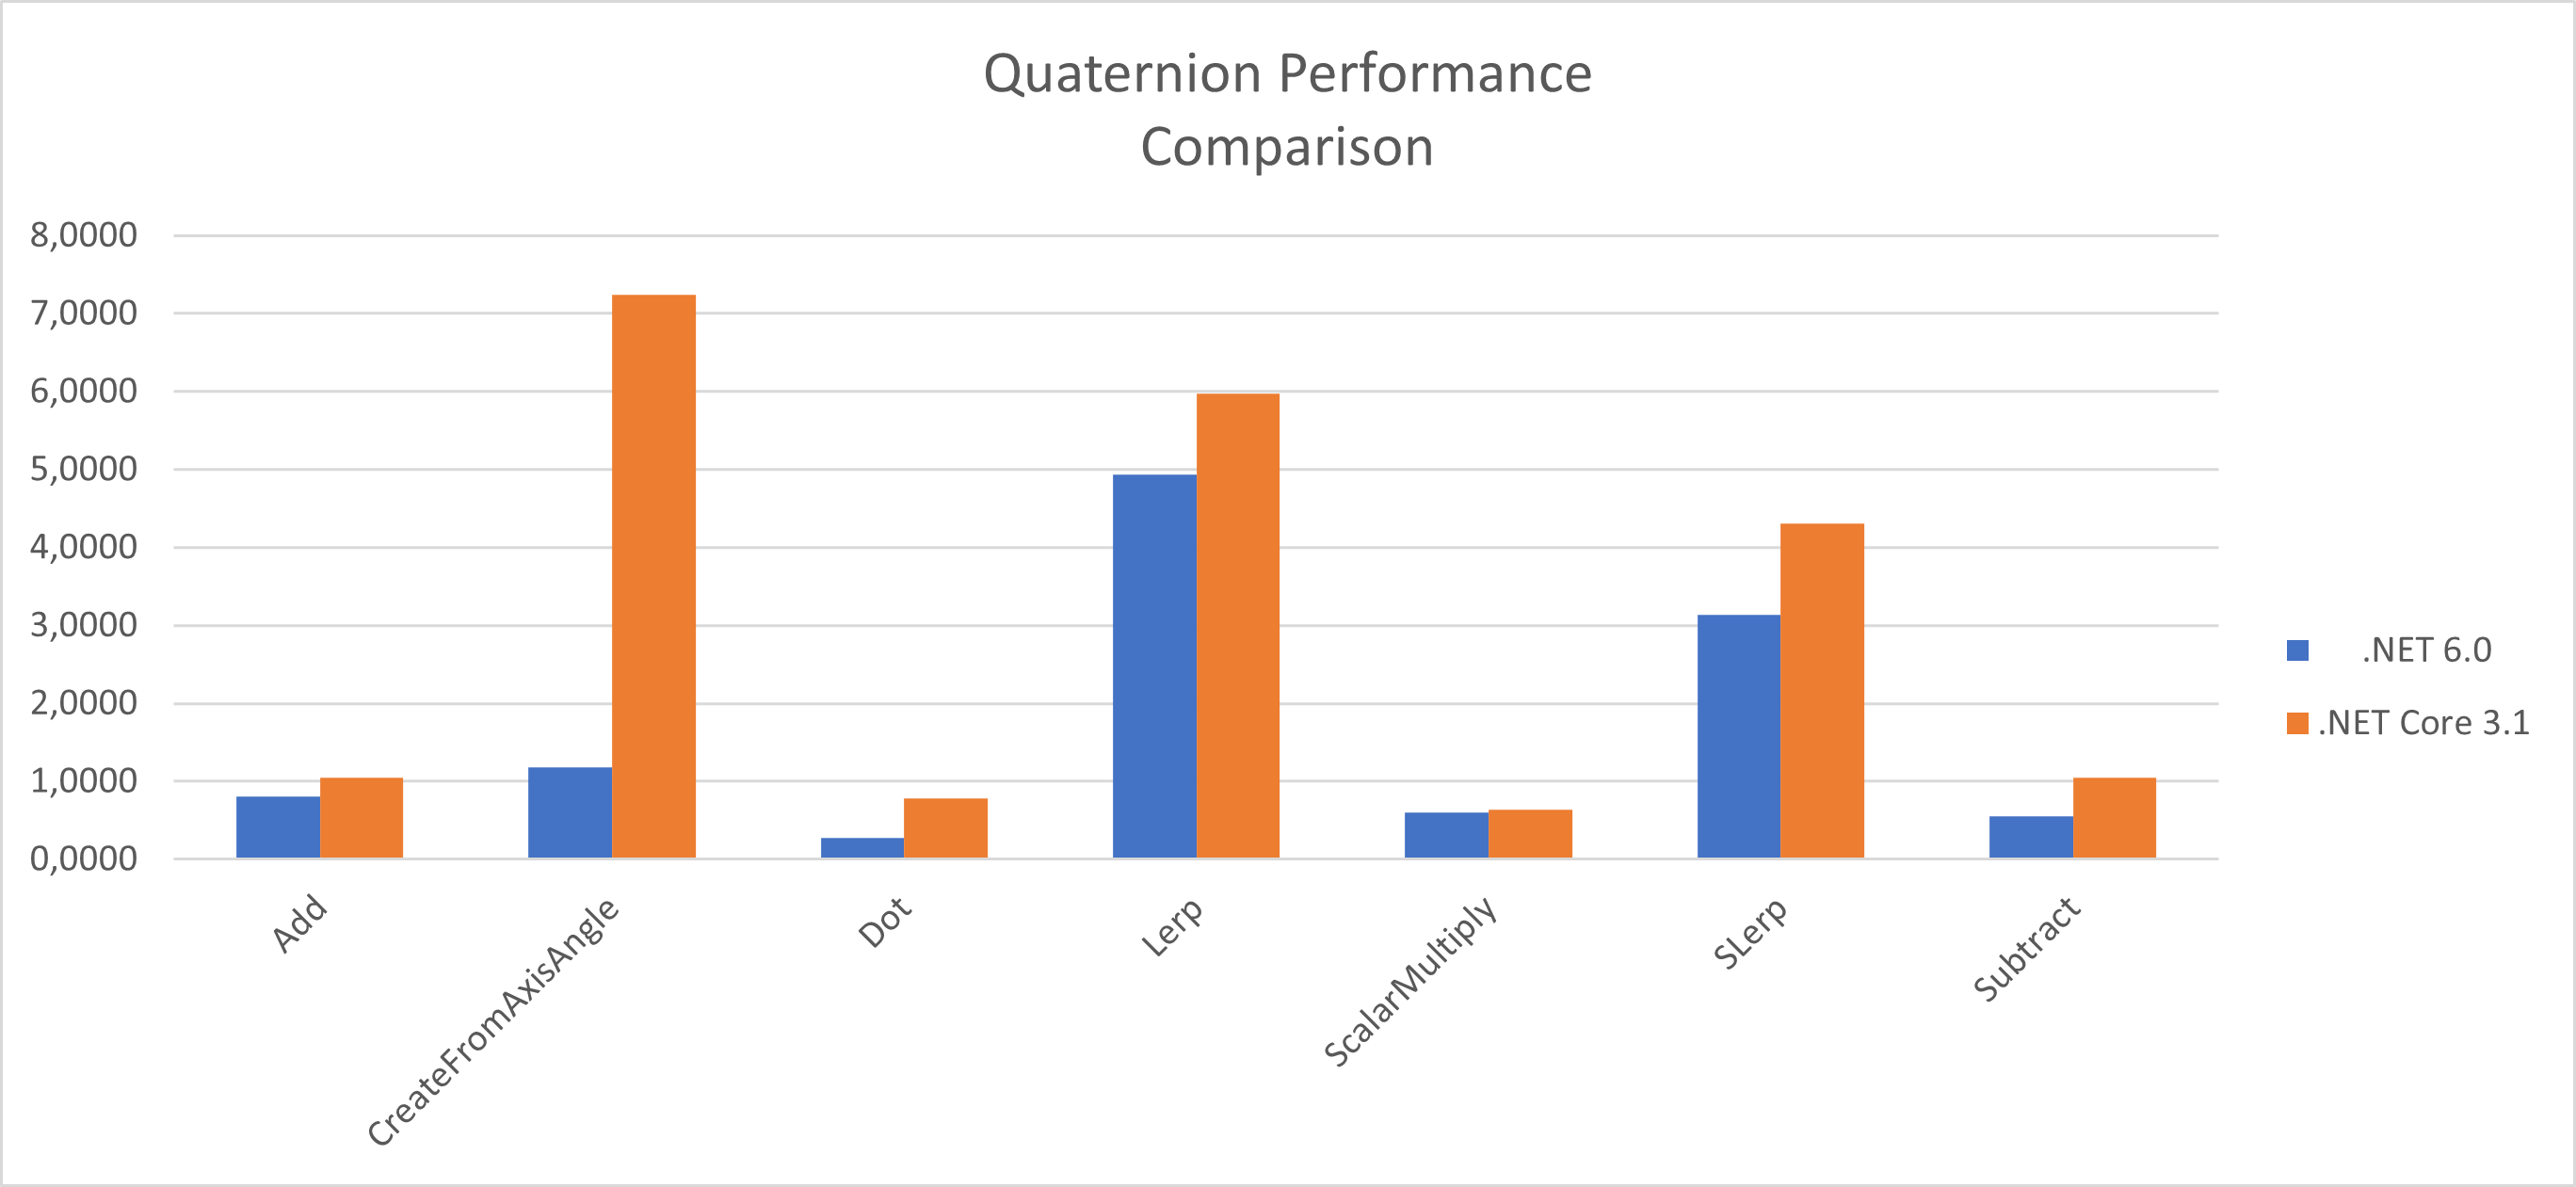
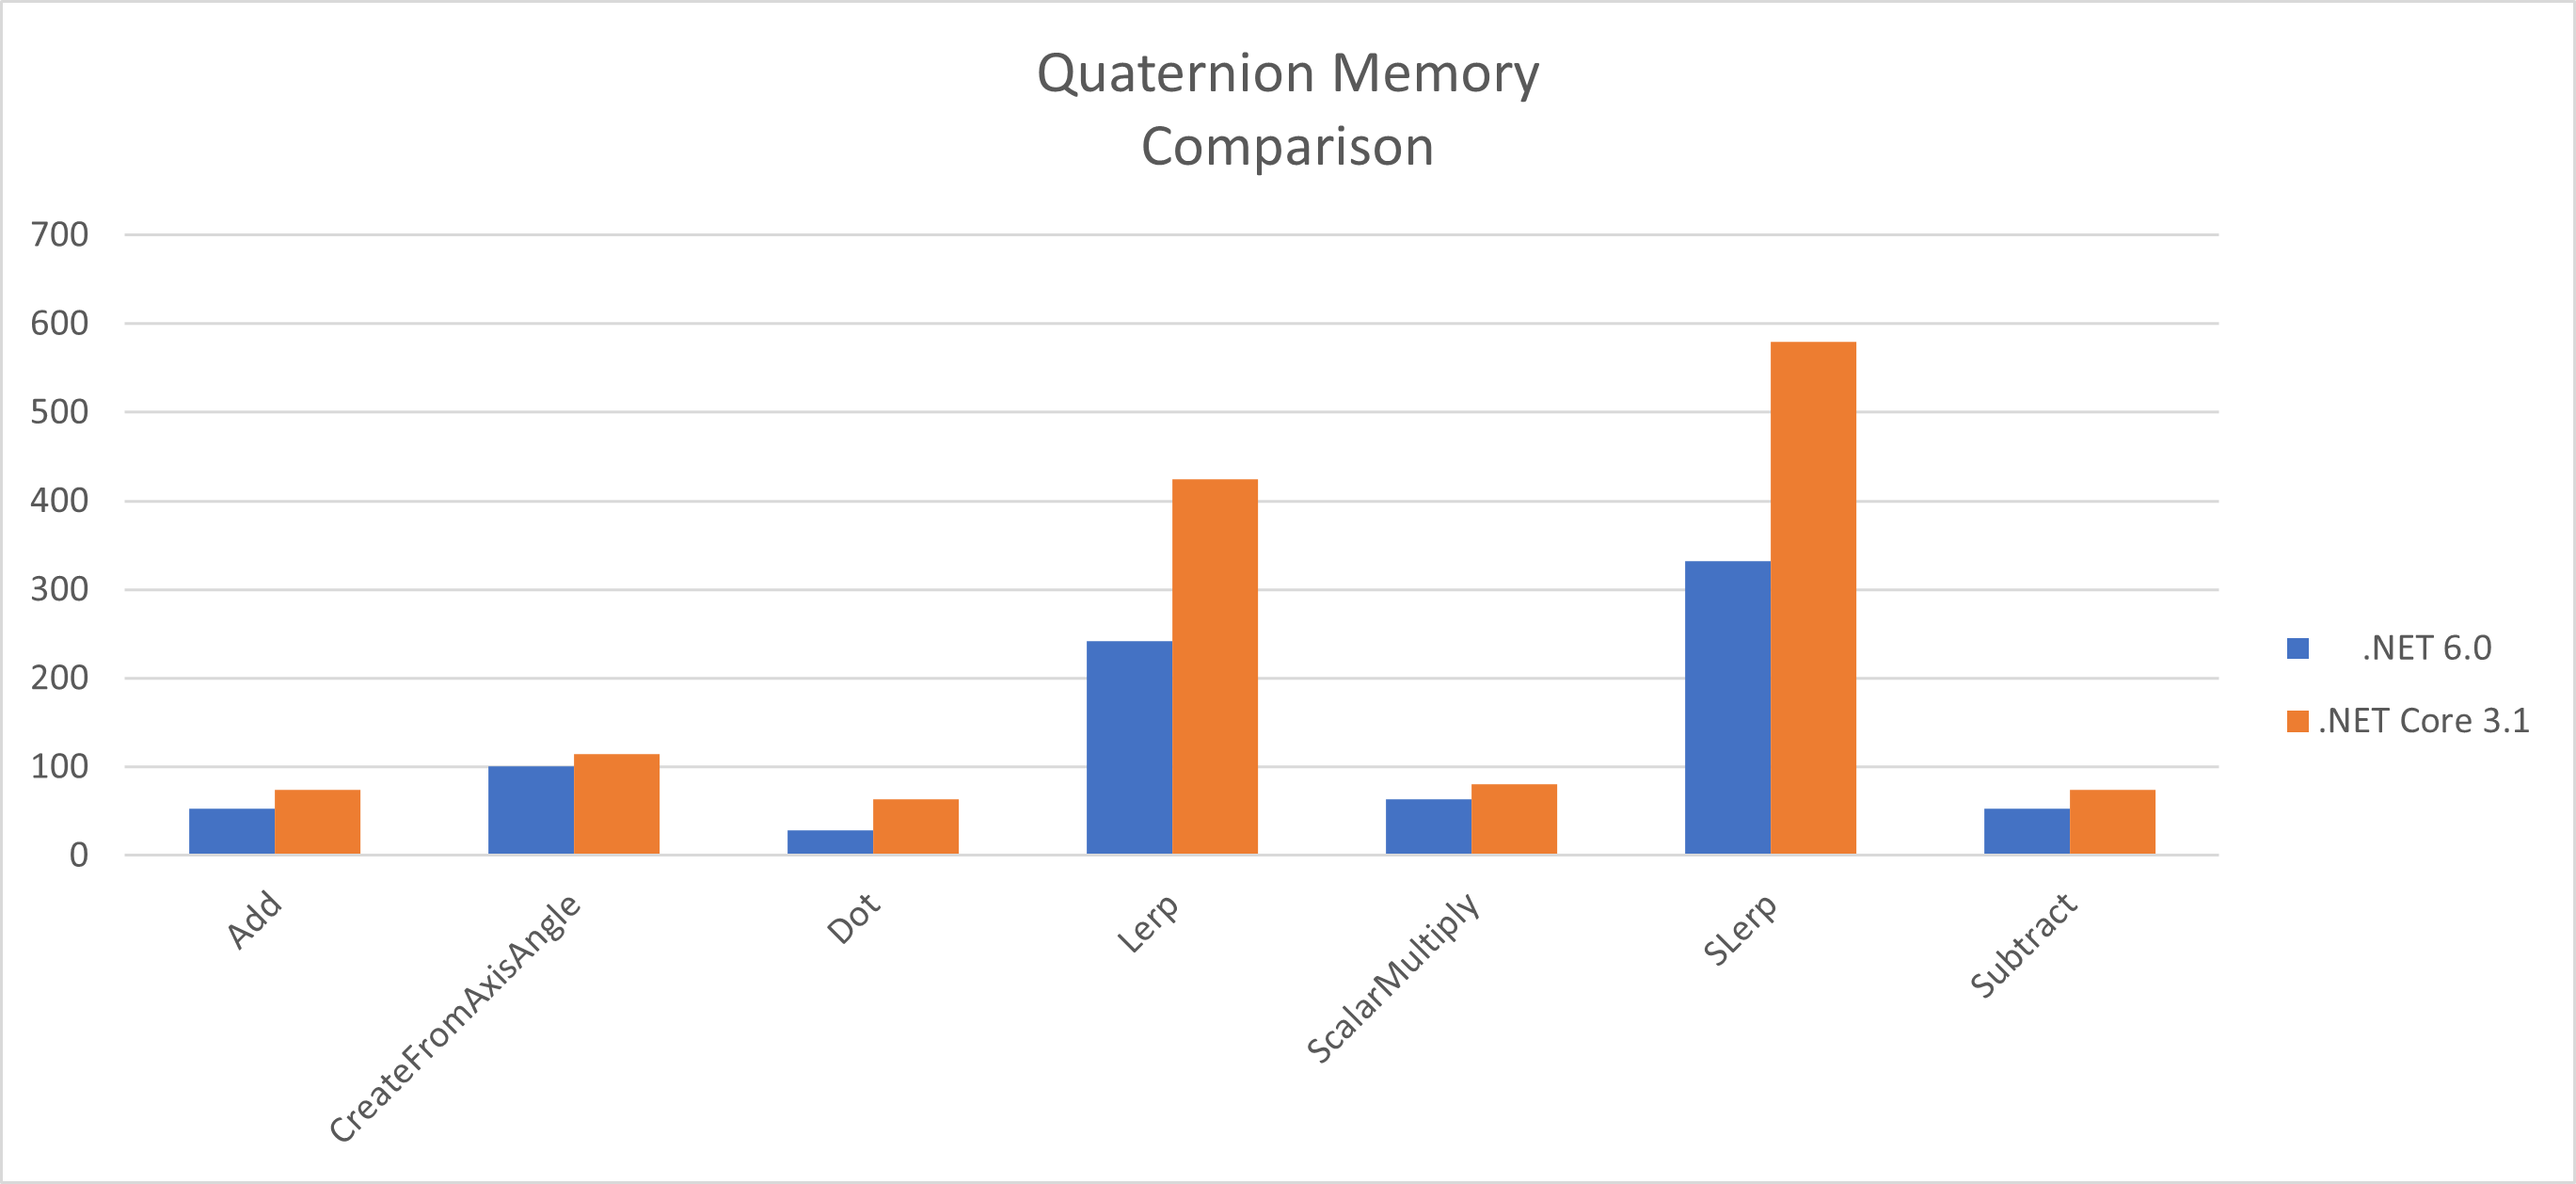
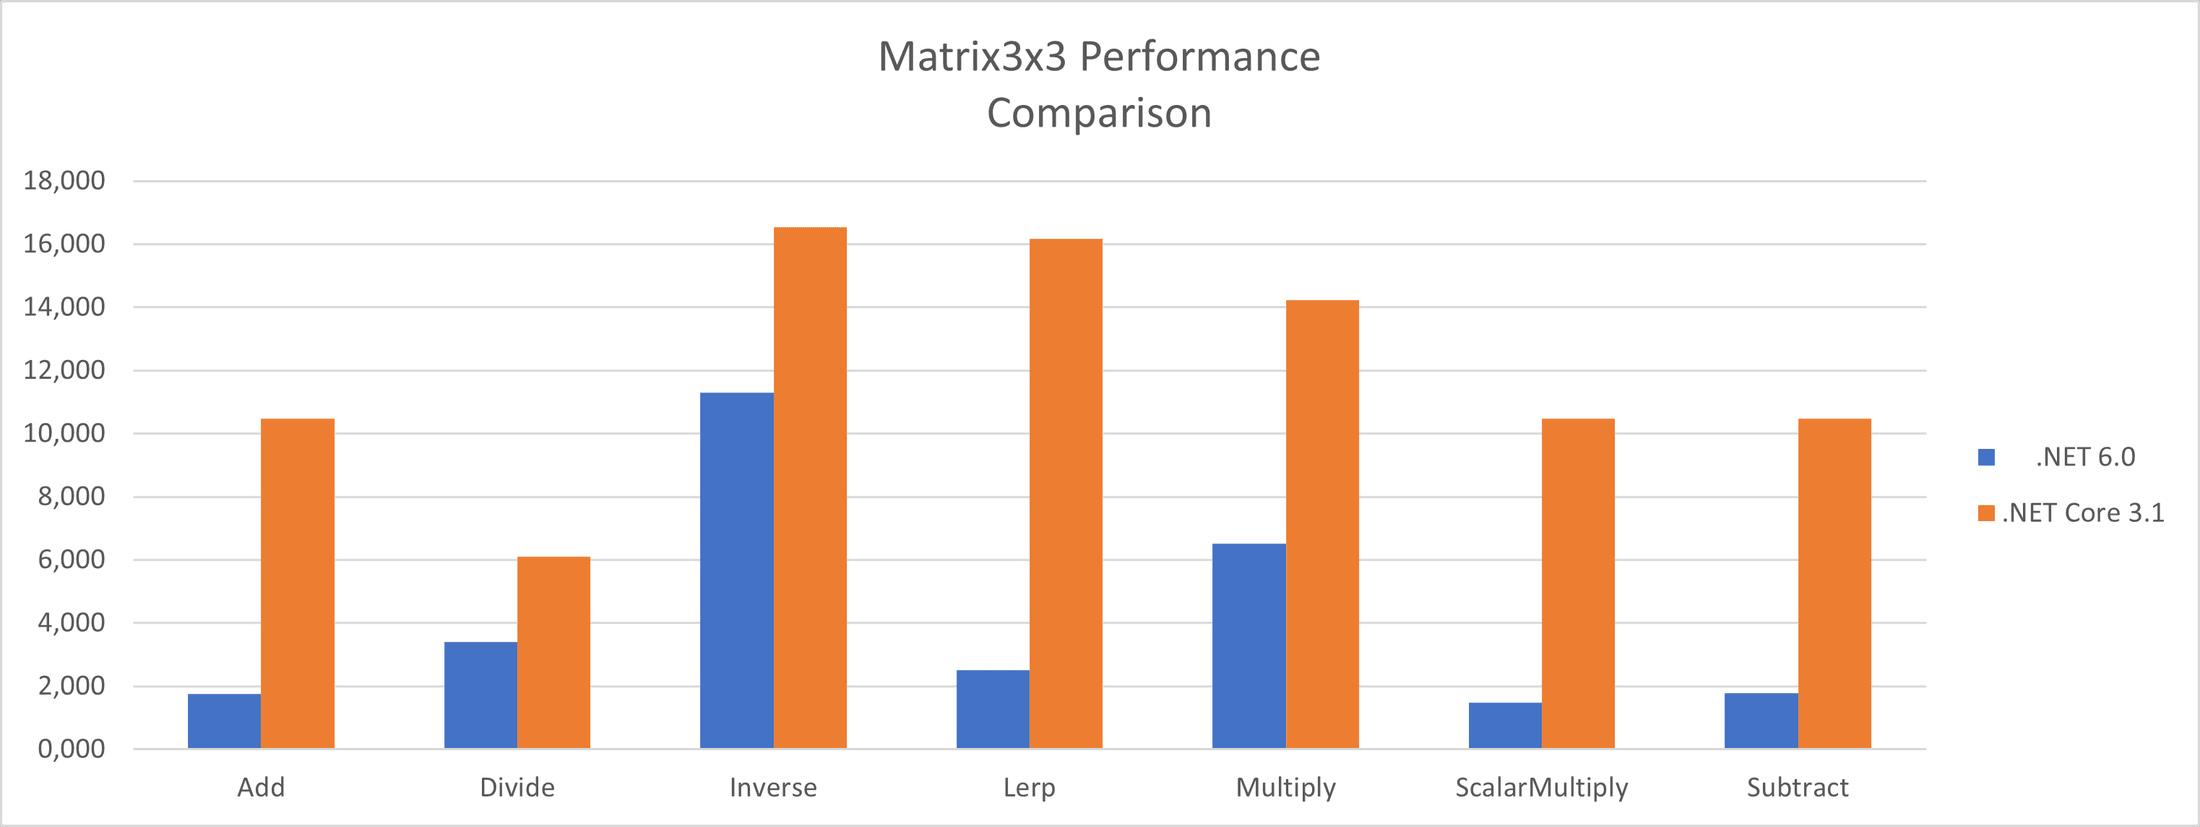
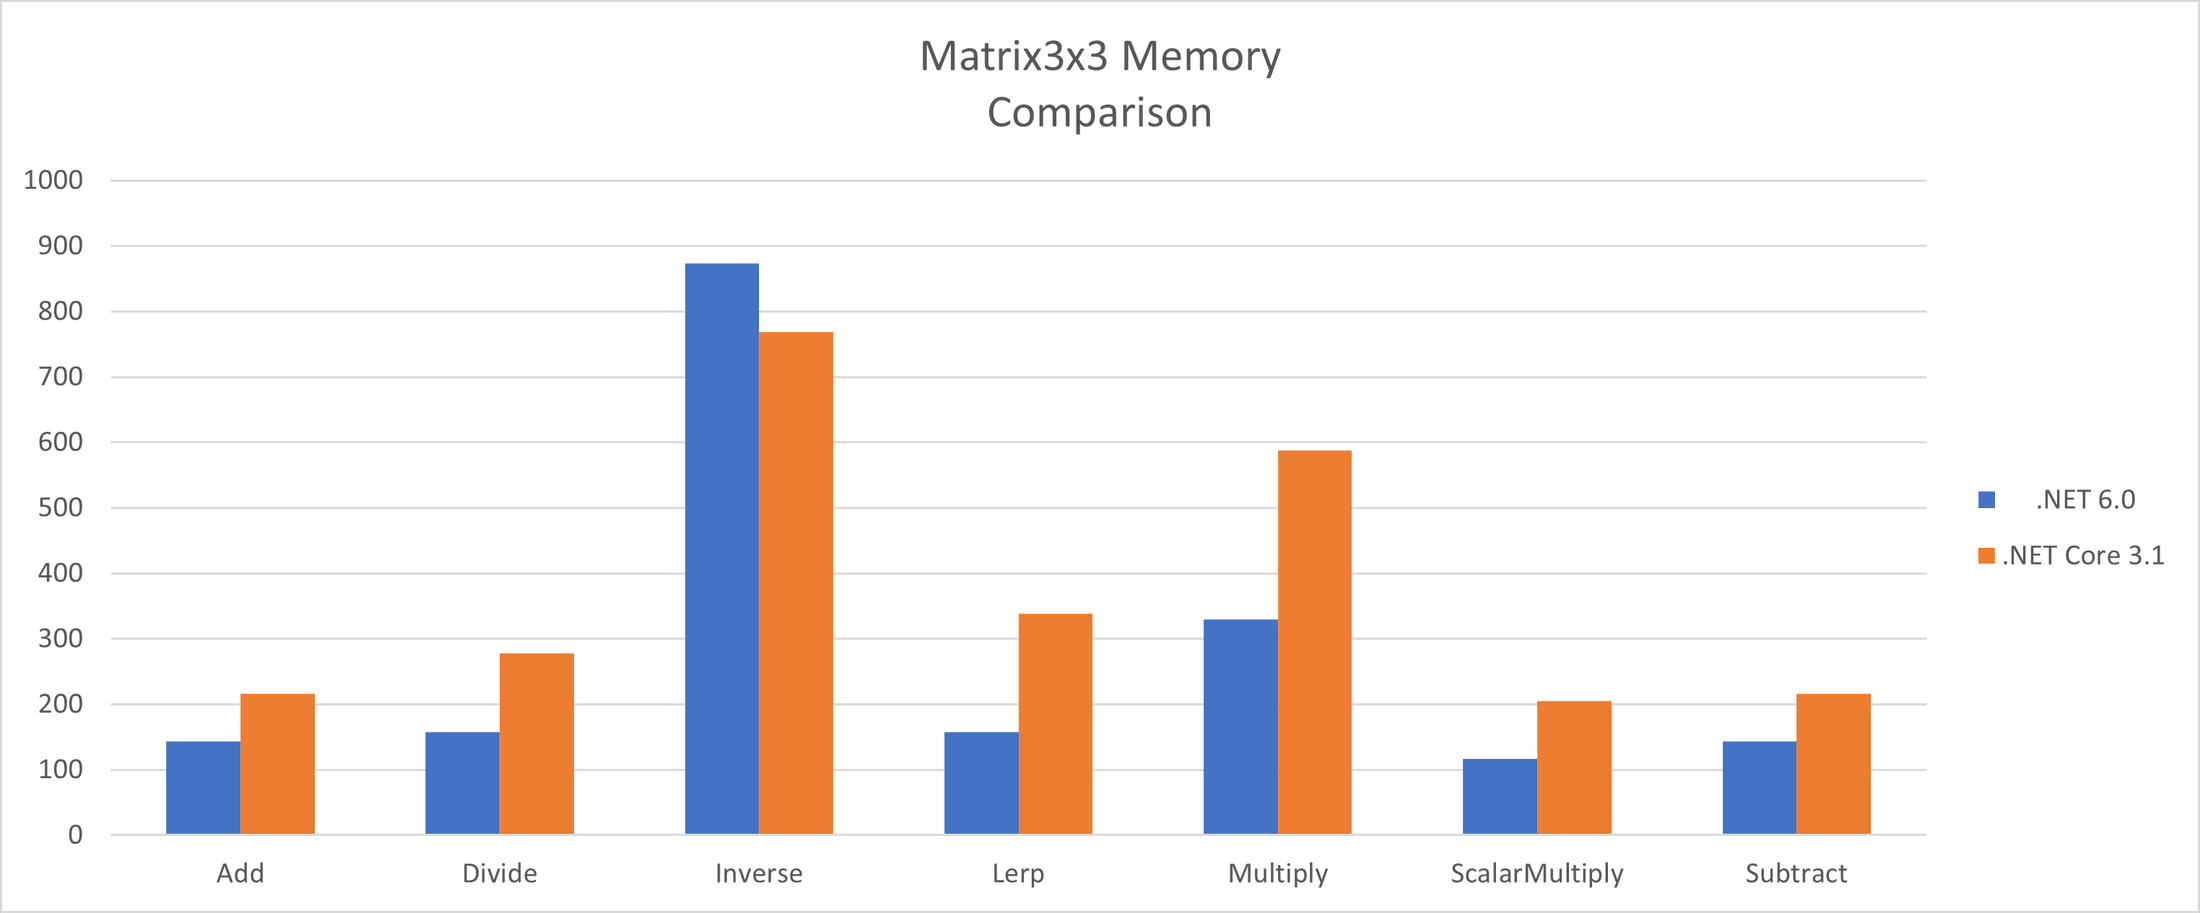
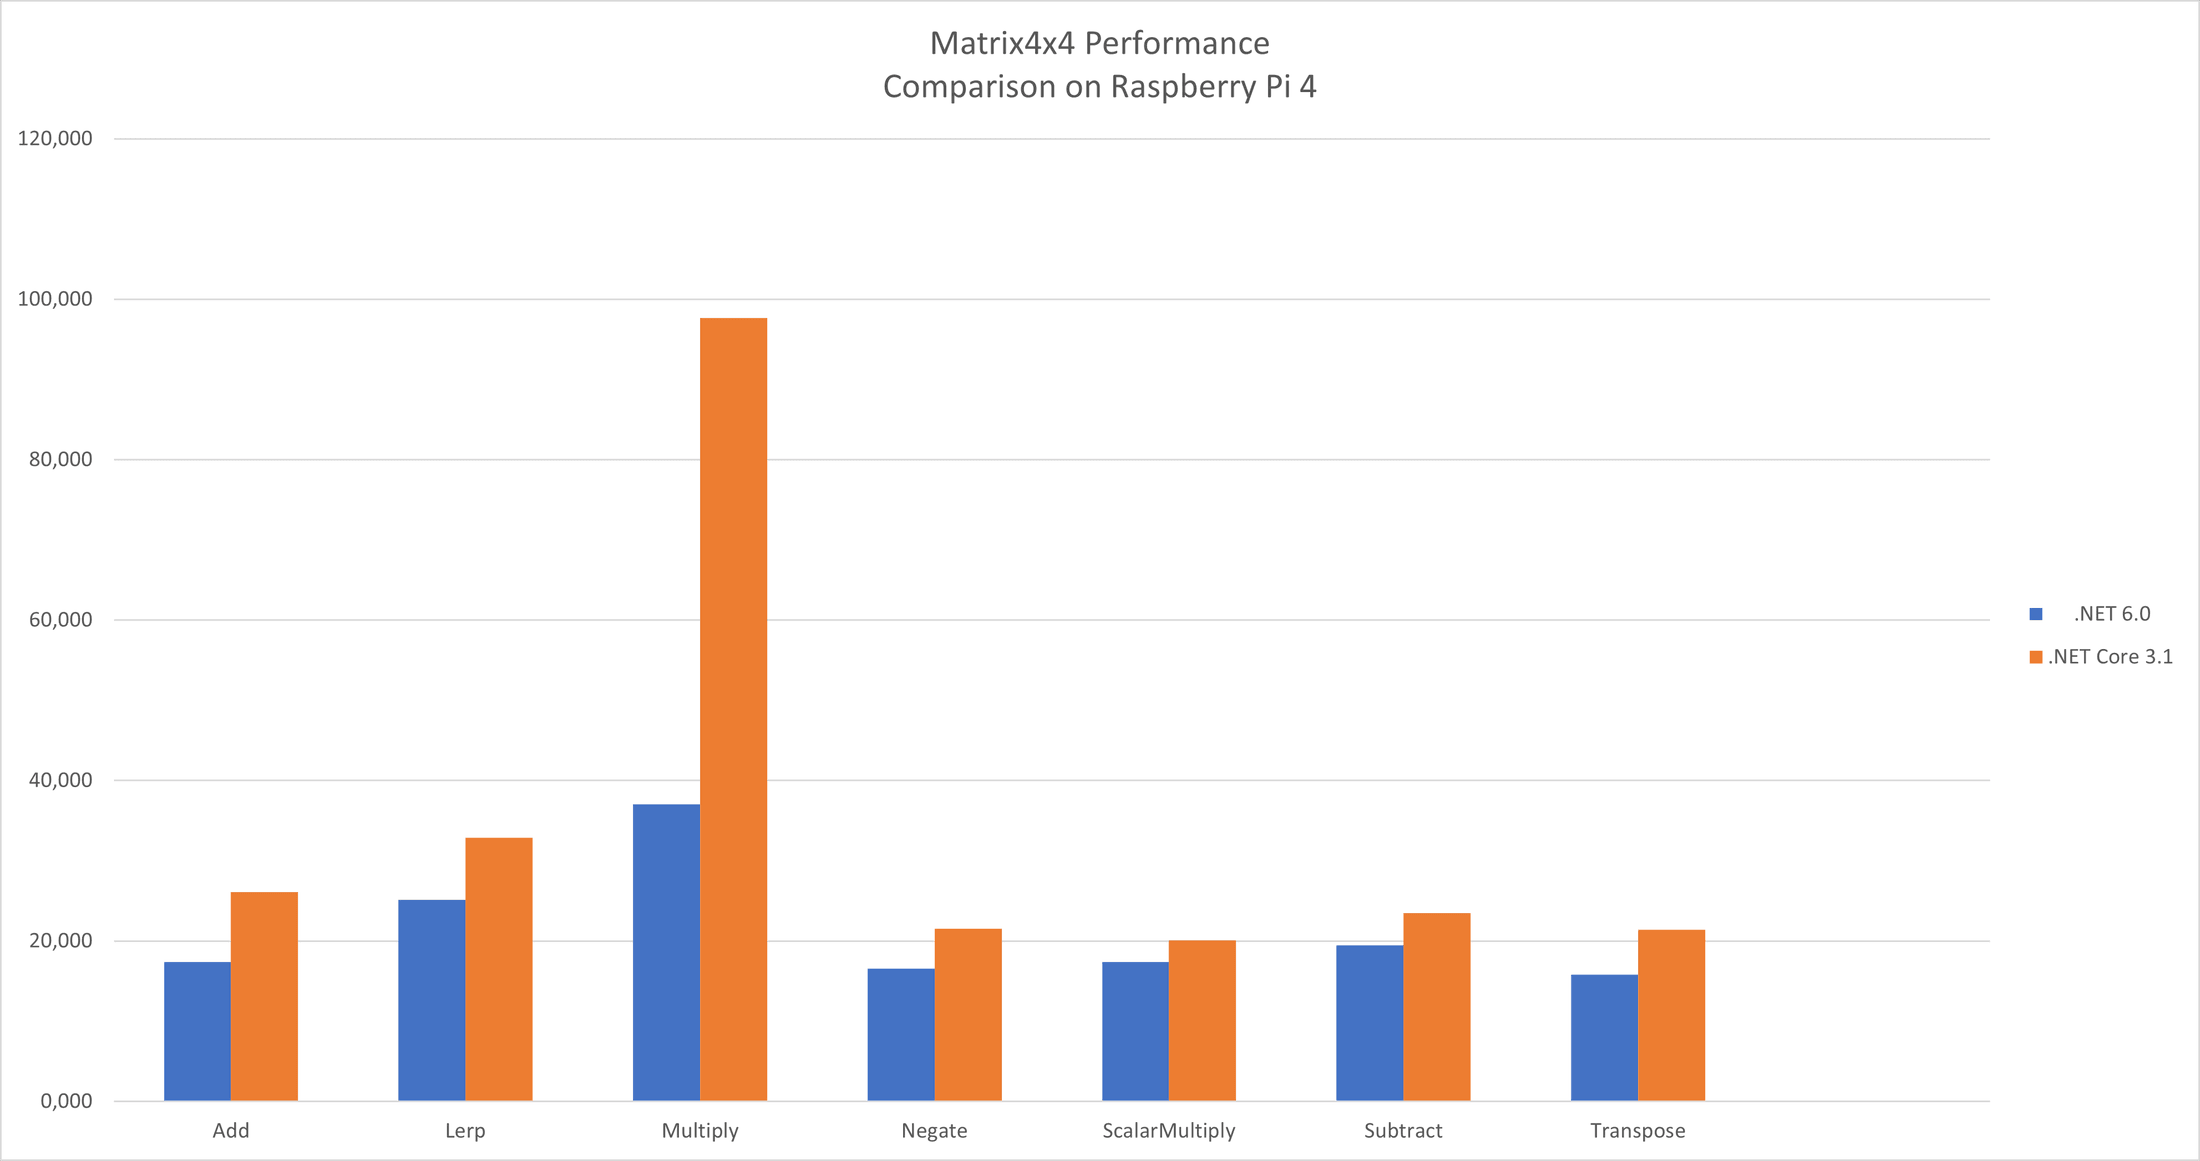
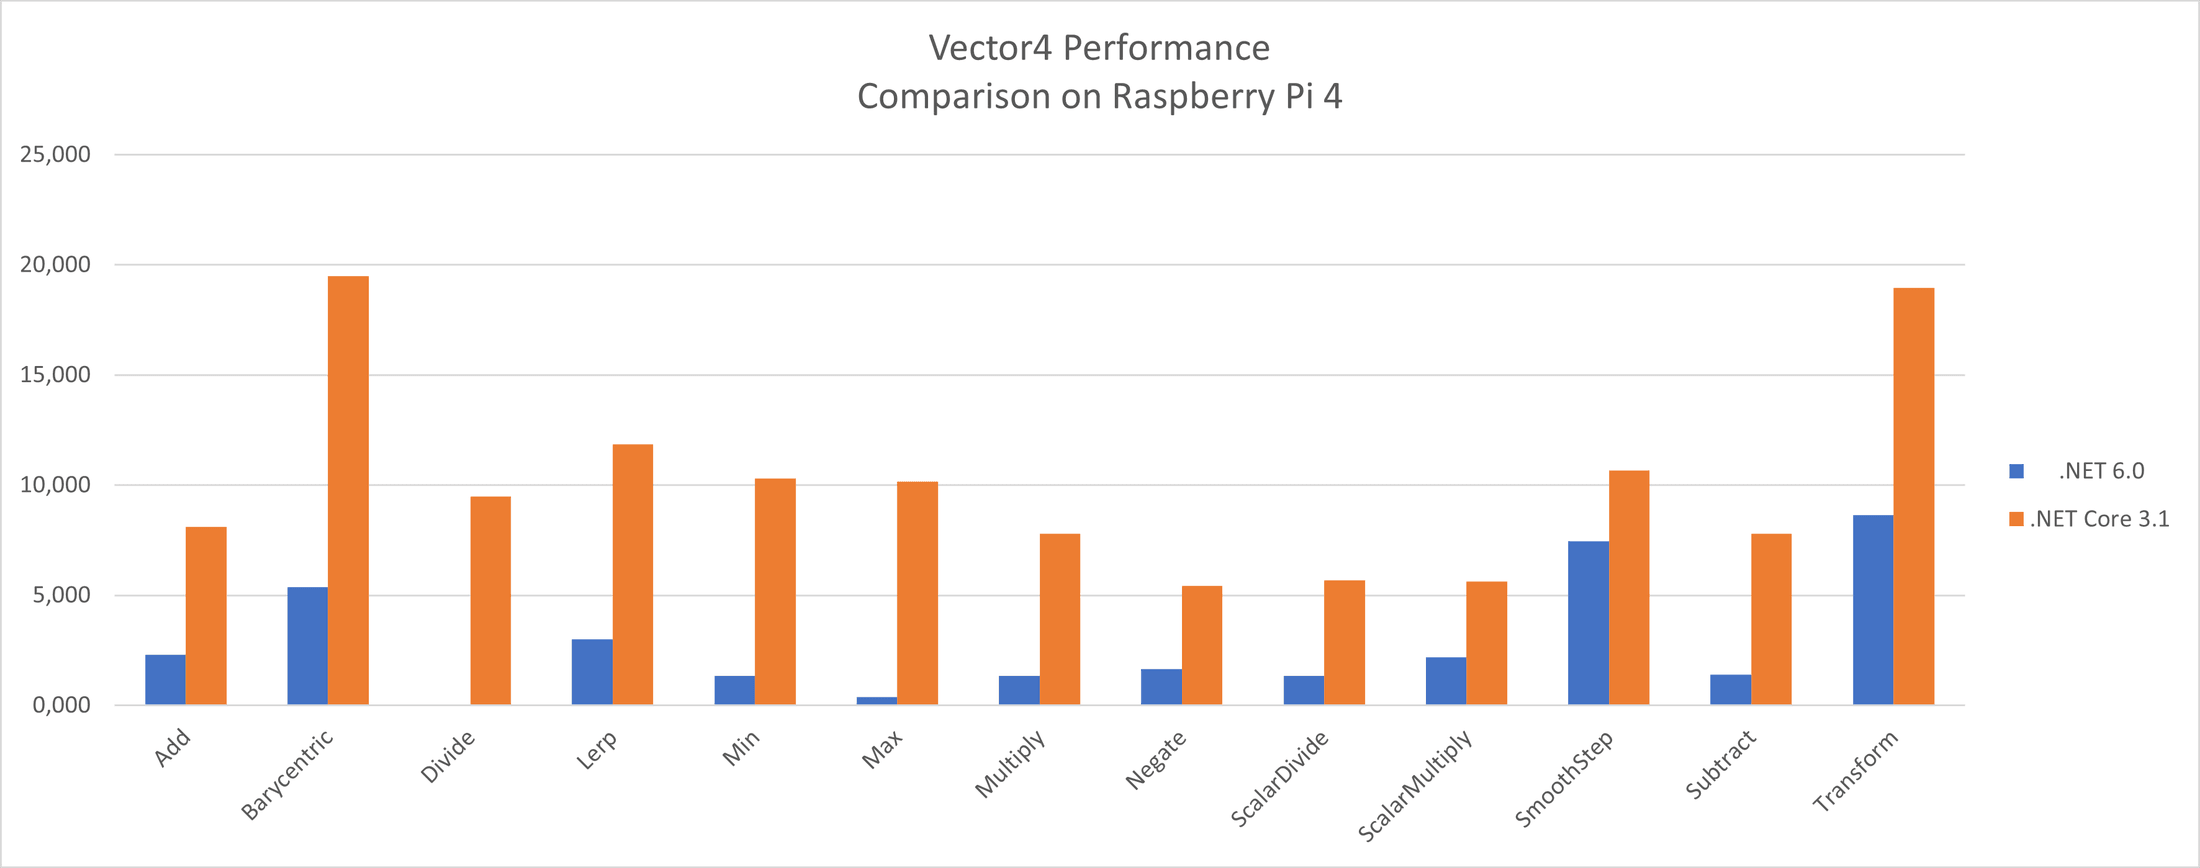
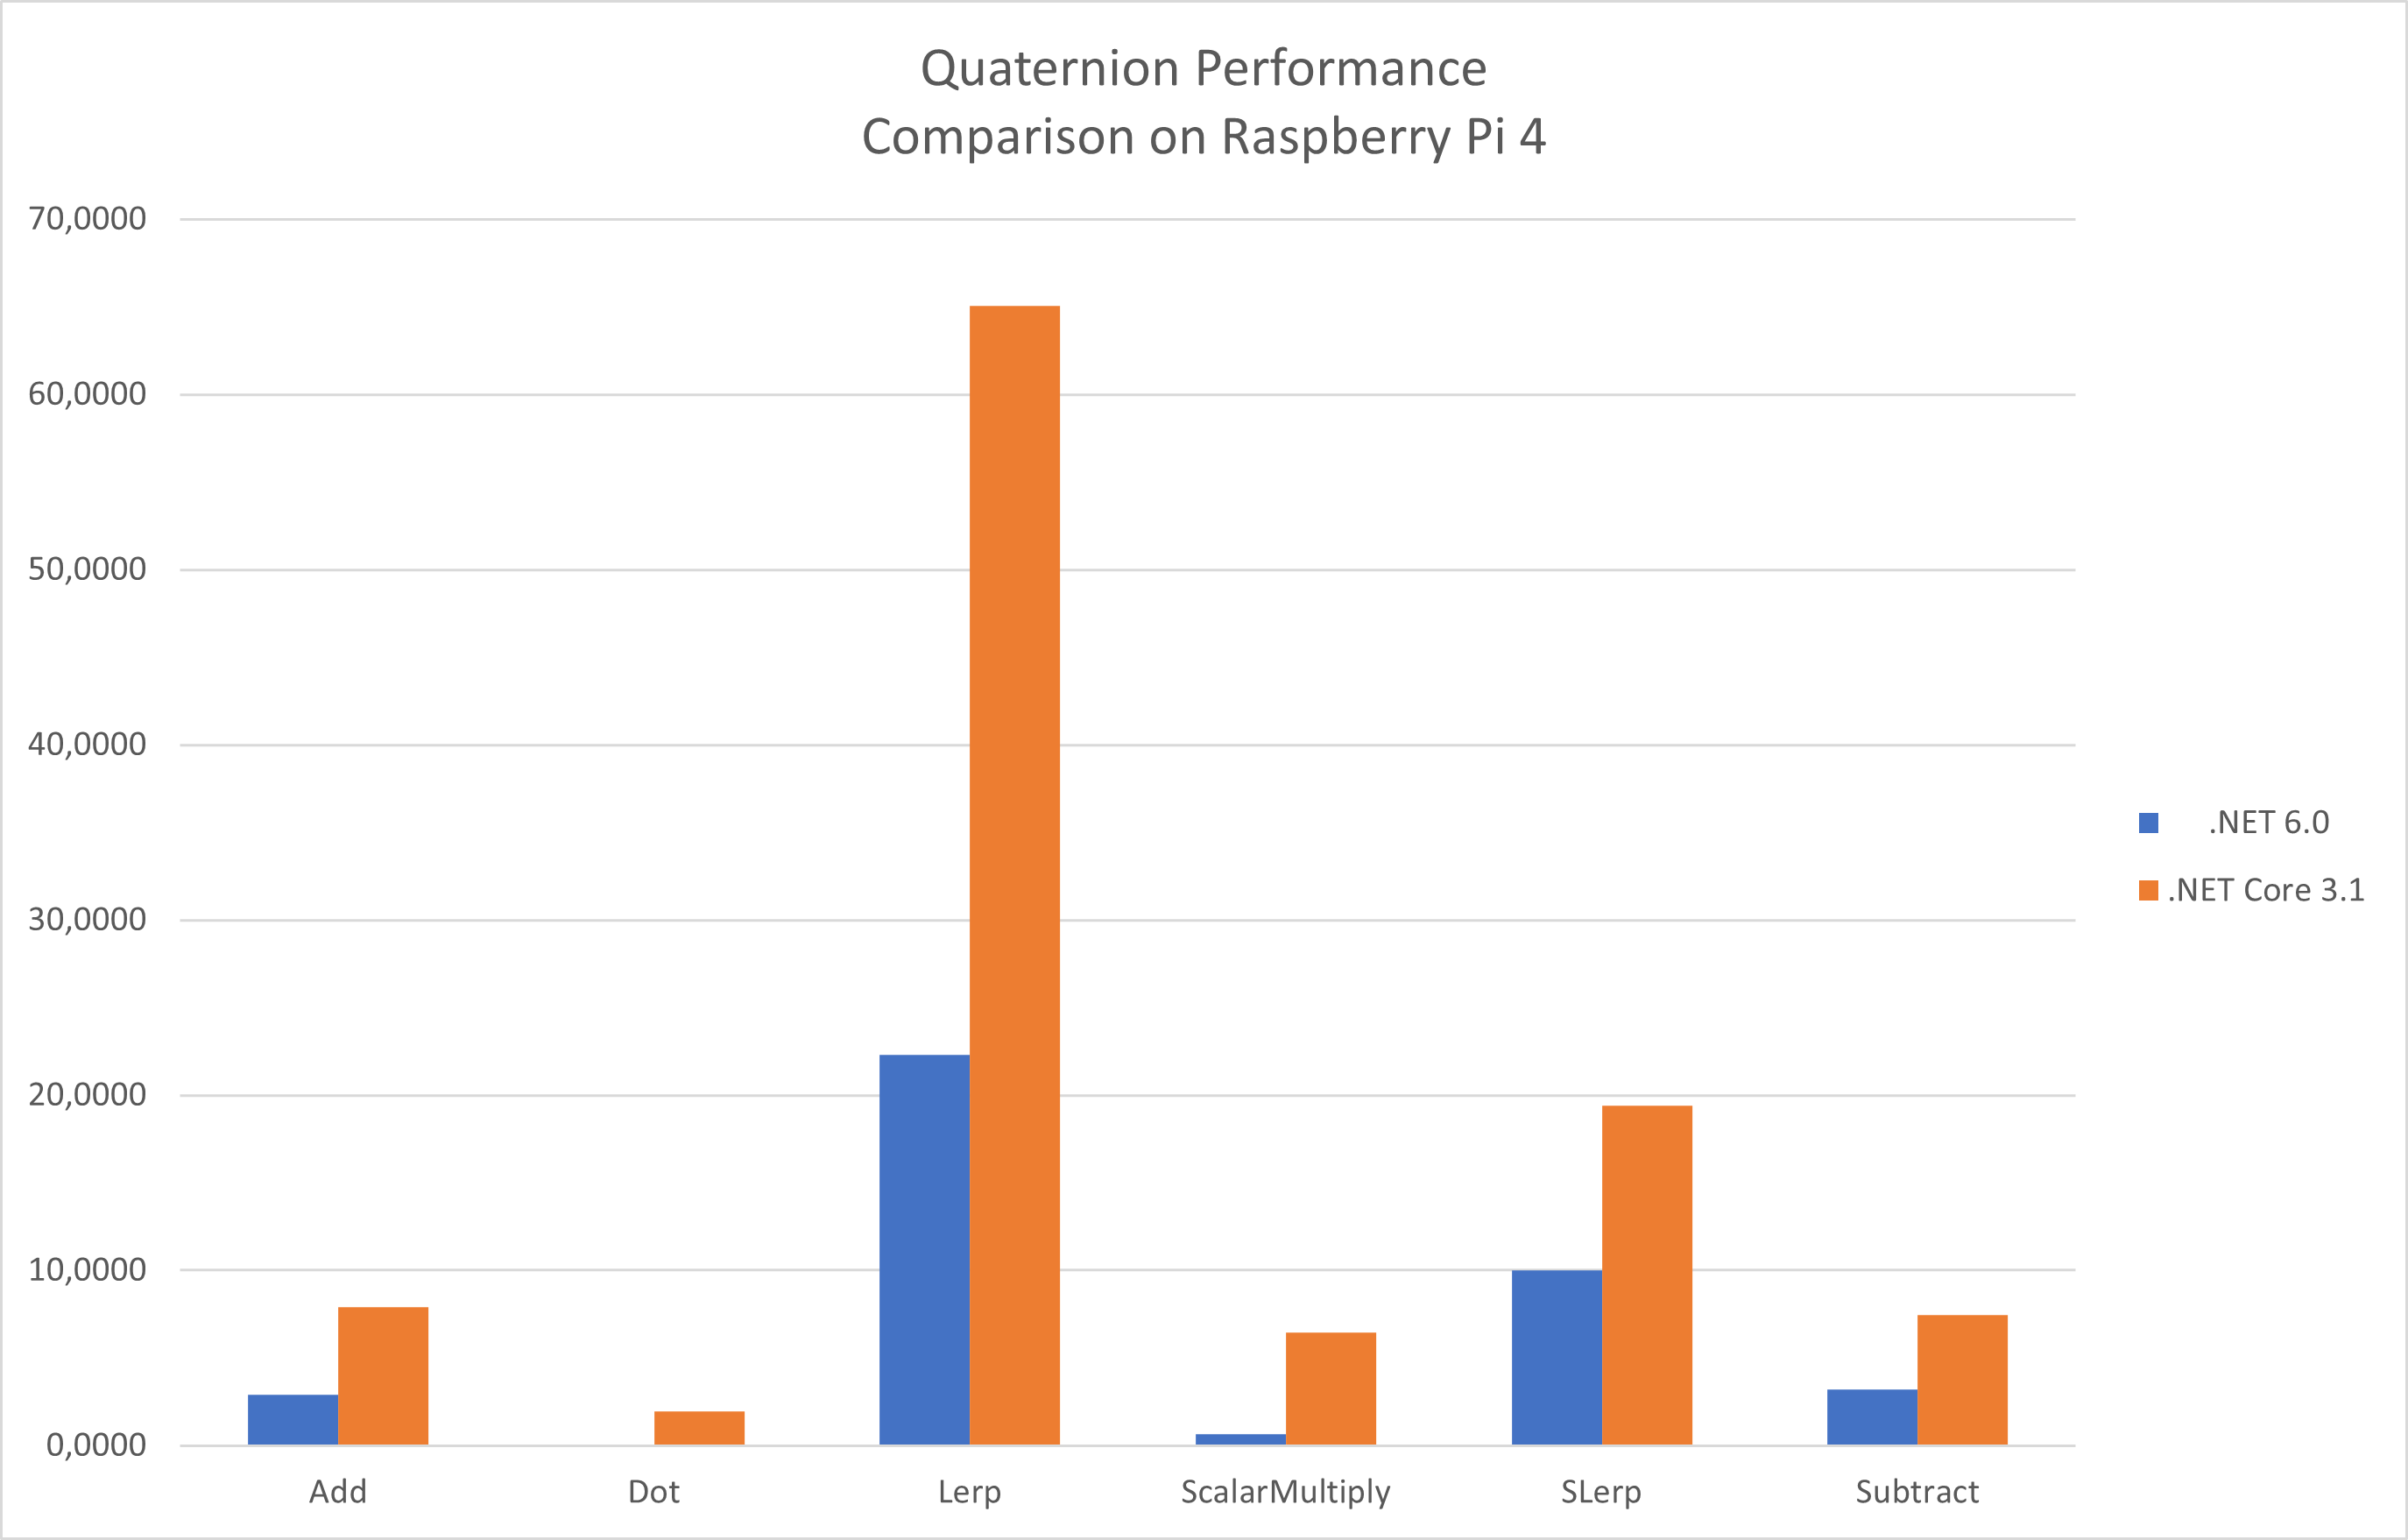
Außerdem haben wir einen neuen Pfad für die ARM64-Architektur entwickelt. Um diesen neuen Pfad zu testen, haben wir einen Raspberry Pi4 verwendet. Auf dieser Architektur nutzen wir den ARM AdvSimd-Befehlssatz, sofern dies möglich ist. Dies sind die Ergebnisse unter Ubuntu 22.04.1 LTS auf einem Rasberry Pi4.
Zusammenfassung
Die neue Bibliothek Evergine.Mathematics ist sehr schnell und ermöglicht es Ihnen, plattformspezifische Funktionen des Rechners zu nutzen, auf dem Sie arbeiten. Sie ist dank der Verwendung von SSE- und AVX-Befehlen auf x86- und x64-Architekturen sowie AdvSimd auf ARM64-Geräten 3- bis 4-mal schneller als zuvor.
Jetzt sind Sie dran: Laden Sie das neue Release herunter und nutzen Sie diese Leistungsverbesserungen dank der neuen Bibliothek Evergine.Mathematics in all Ihren Projekten.