かつてない速さの数学演算
新しいEvergine 2022.9.28では、CPUメーカーが設計したハードウェアアクセラレーション対応の命令セットを使用する、Evergine.Mathematicsライブラリの新バージョンをリリースしました。
これは、Net6向けに作成された新しいハードウェア組み込みAPIのおかげで可能になりました。このAPIにより、ハードウェアがサポートしていれば、x86、x64、ARM64のターゲットアーキテクチャでSingle-Instruction Multiple Data (SIMD) 命令を使用できます。この新しいAPIにより、ハードウェアにこれらの拡張機能が存在するかどうかを確認し、可能であれば128および256レジスタベクタを使用してコードをベクトル化し、単一サイクル(サイクルはCPUにおける基本時間単位)で複数のプリミティブ操作を実行できます。
これらの命令を使用して、Evergine.Mathematicsライブラリの最も重要な構造体(Matrix4x4、Vector4、Matrix3x3、Quaternionなど)内の操作を最適化しました。その結果は目覚ましいものです。
ベンチマーク
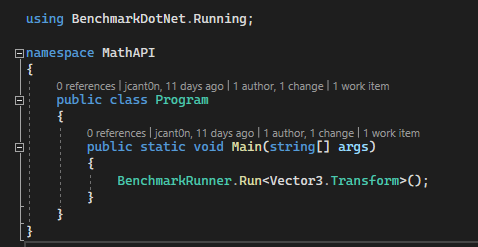
マイクロベンチマークを作成するために、benchmarkdotnetを使用しました。これは、Matrix4x4の比較を起動するためのセットアップです。
program.csファイルの内容:
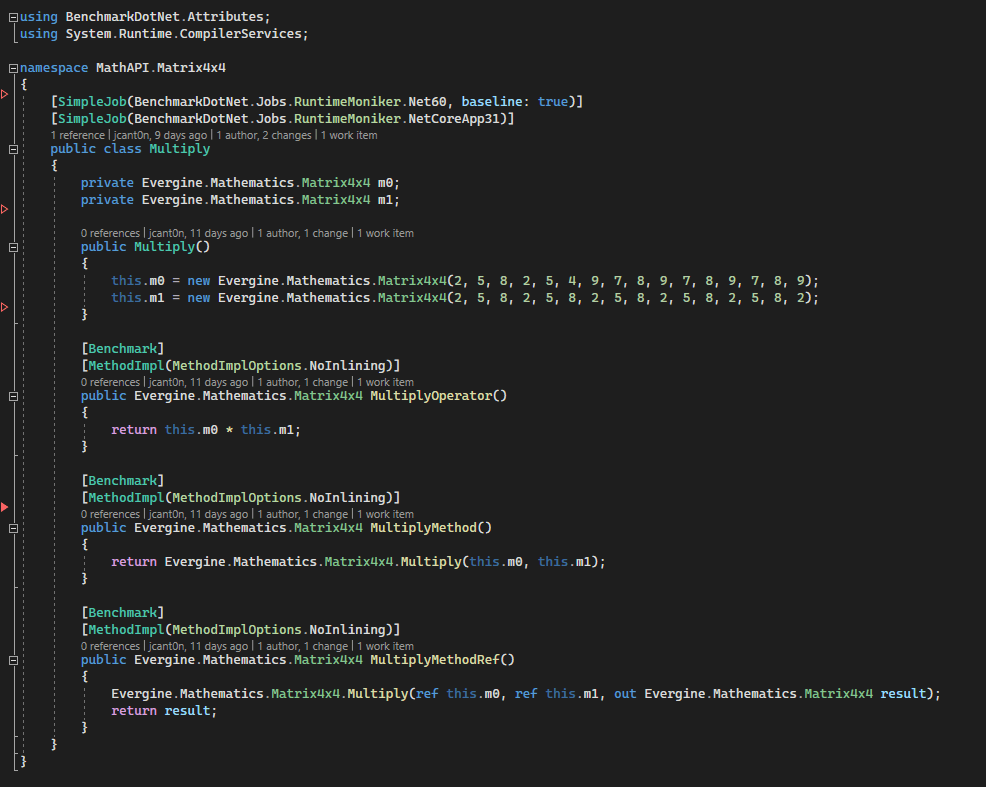
Matrix4x4乗算テストの内容:
この記事で紹介するすべてのx86およびx64ベンチマークに使用されたCPUは次のとおりです:
Intel Core i9-10980HK CPU 2.40GHz、1 CPU、16論理コア、8物理コア
そして、benchmarkdotnetによって生成された詳細な結果は次のとおりです:
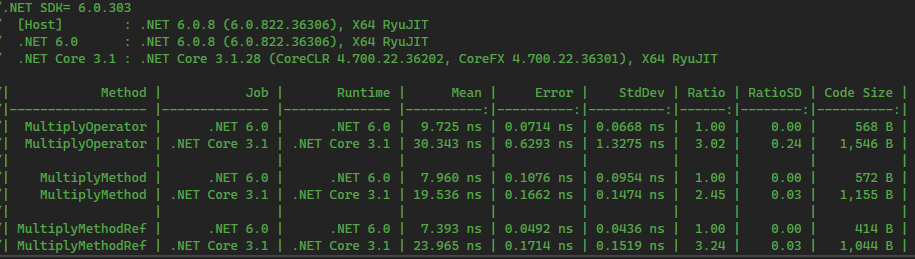
ご覧のとおり、行列パラメータをコピーではなく参照渡しするMultiplyMethodRefを使用した高速パスでは、この場合SIMD命令SSEを使用するNet6向けの新しいパスは、23.965 nsに対してわずか7.393 nsしか必要としません。コードサイズも1,044バイトから414バイトに削減されています。これらは、3Dグラフィックスエンジンで最も使用される数学演算の一つにとって、非常に素晴らしい結果です。
x86およびx64アーキテクチャにおけるパフォーマンス向上を視覚的に確認するために、各数学構造体のチャートを作成しました。
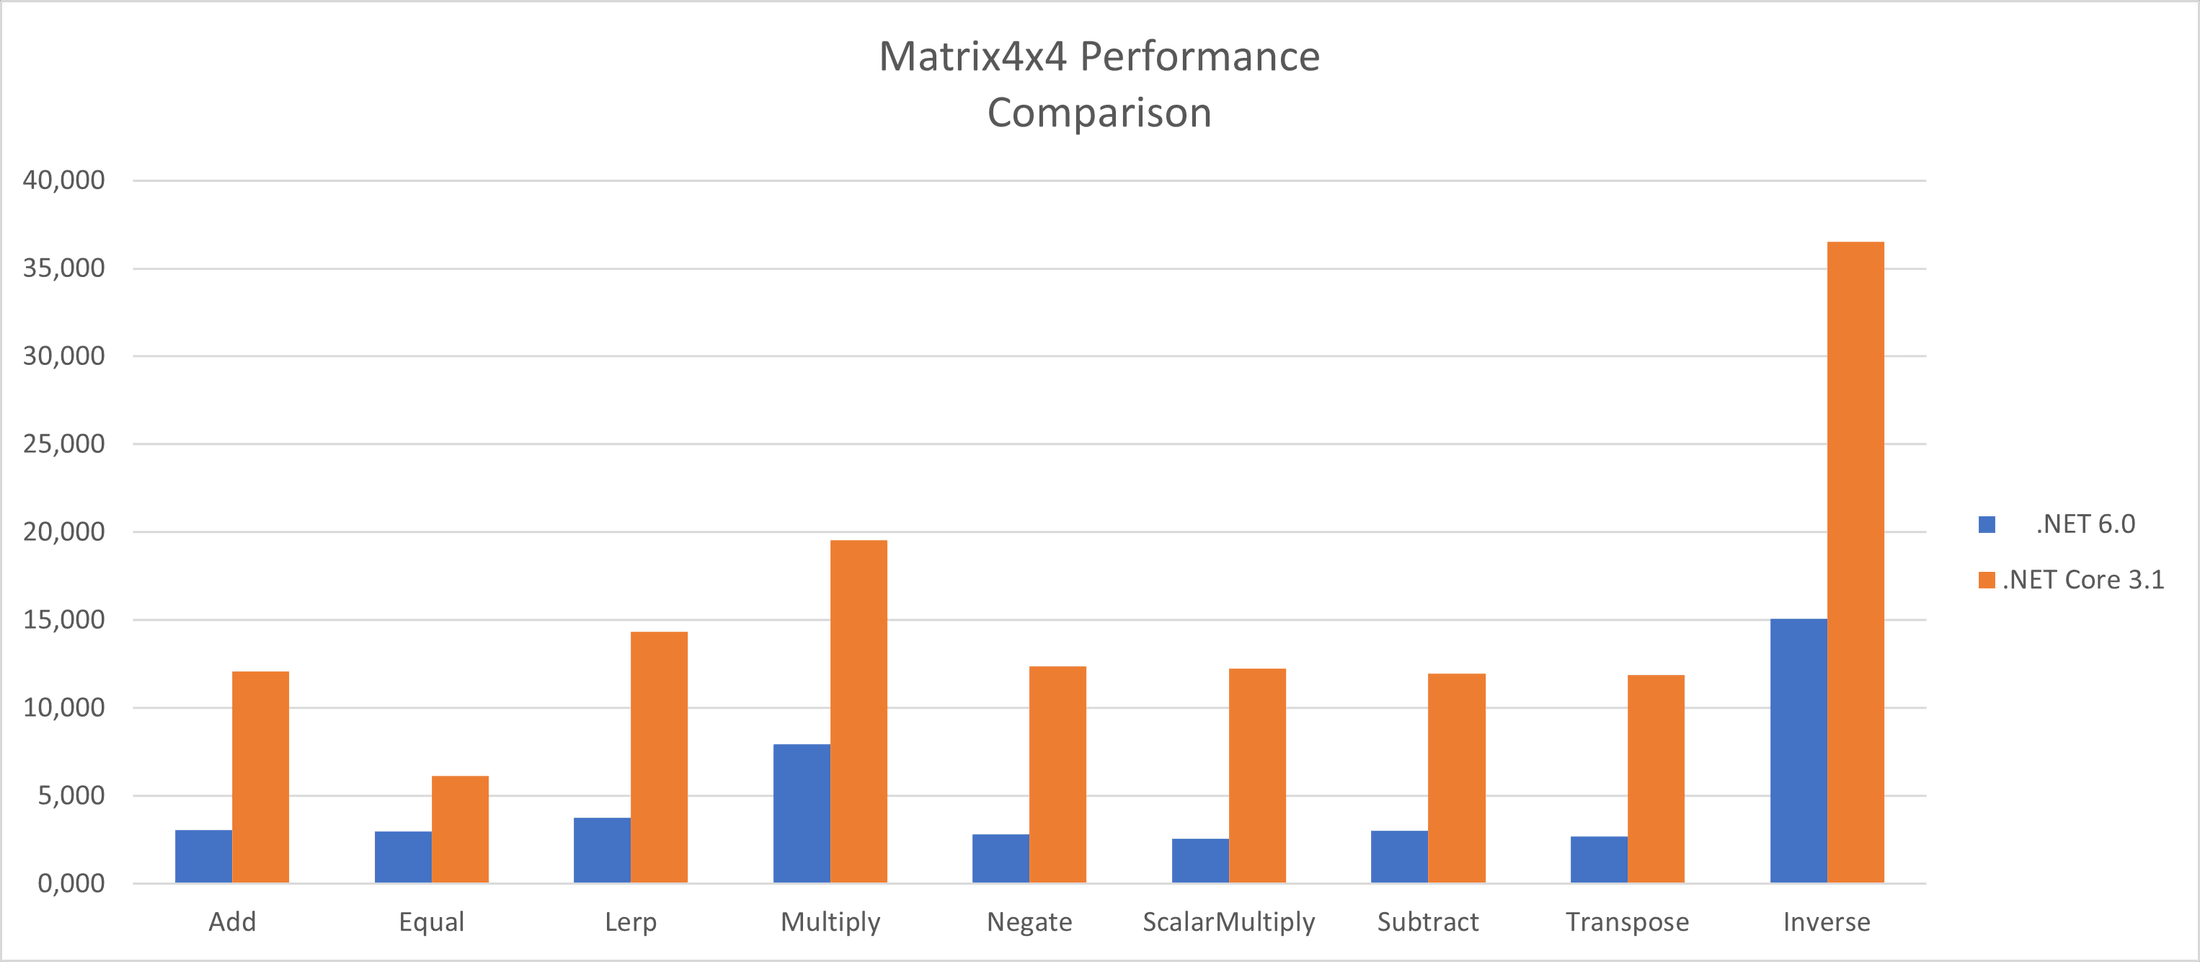
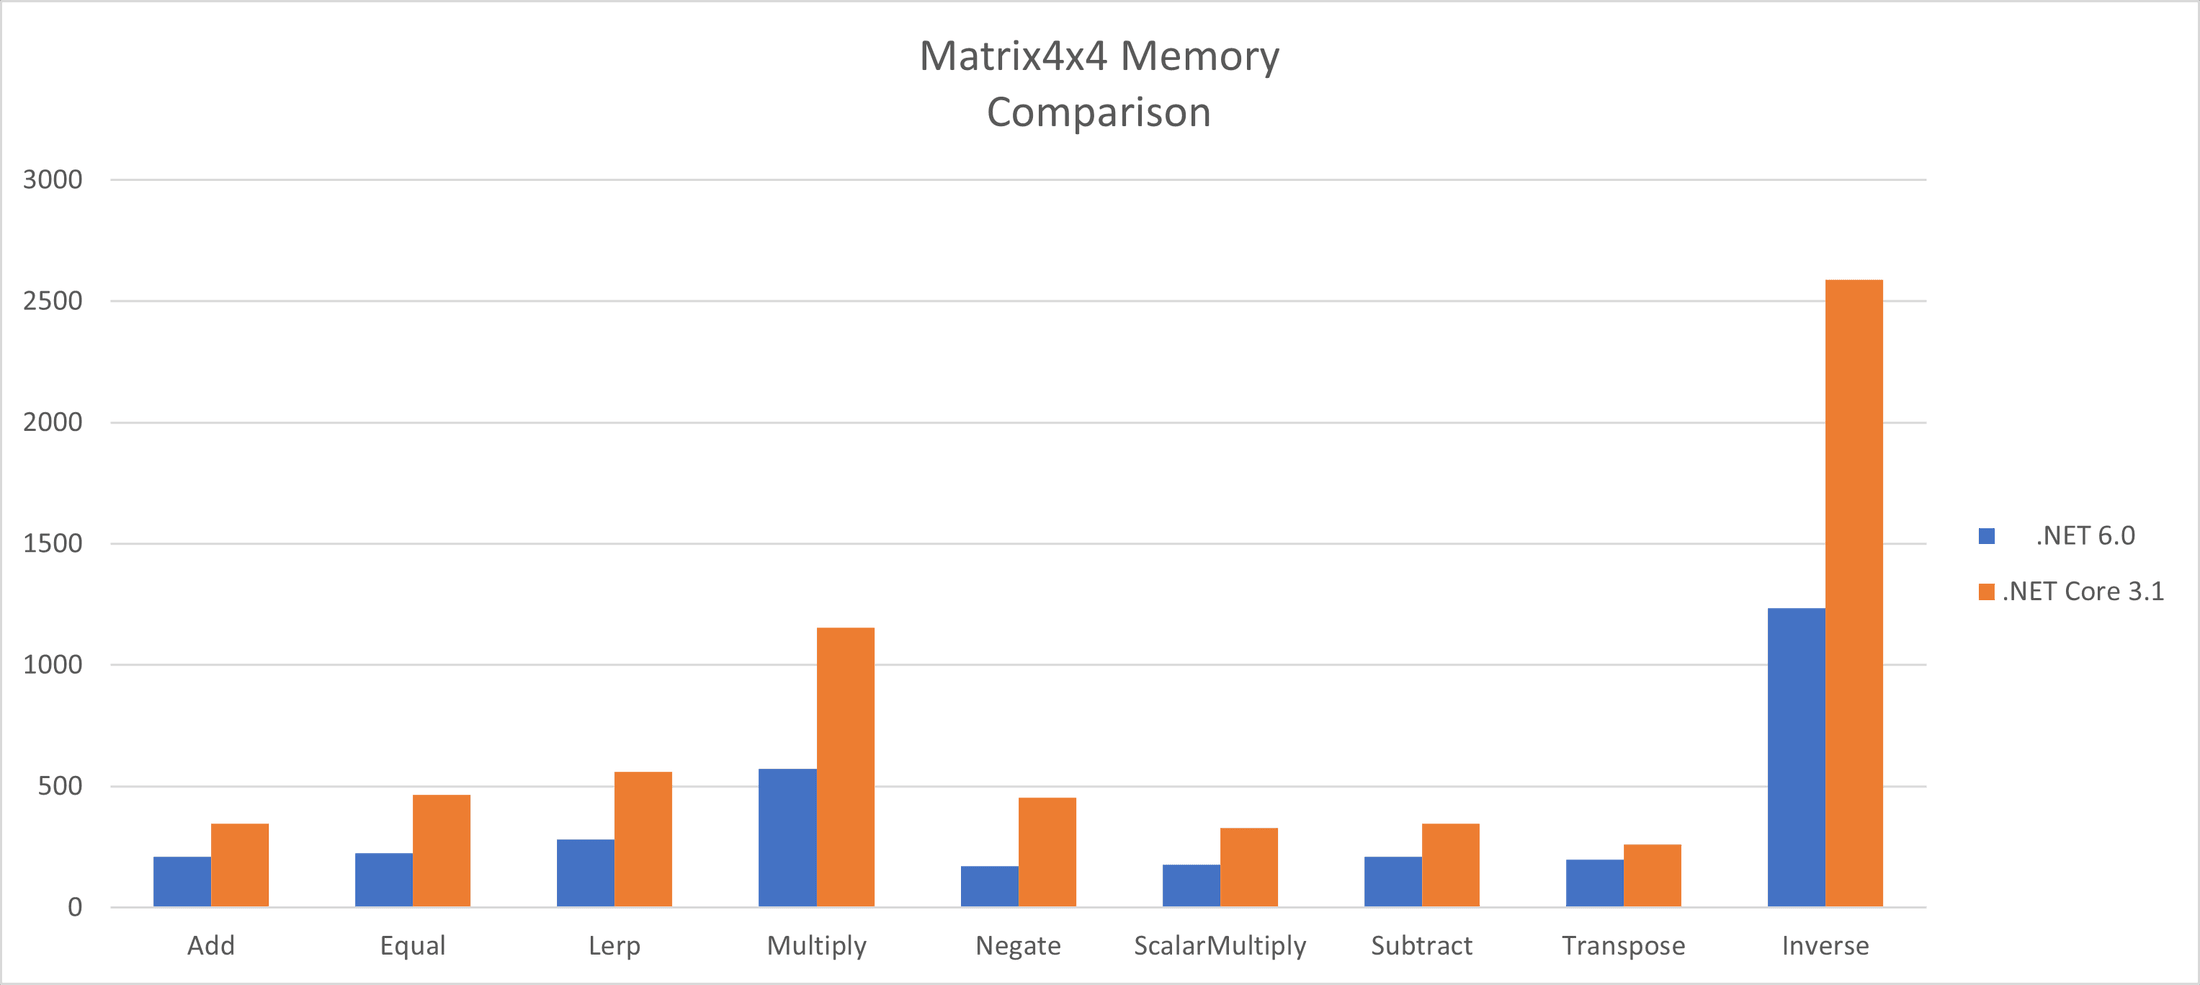
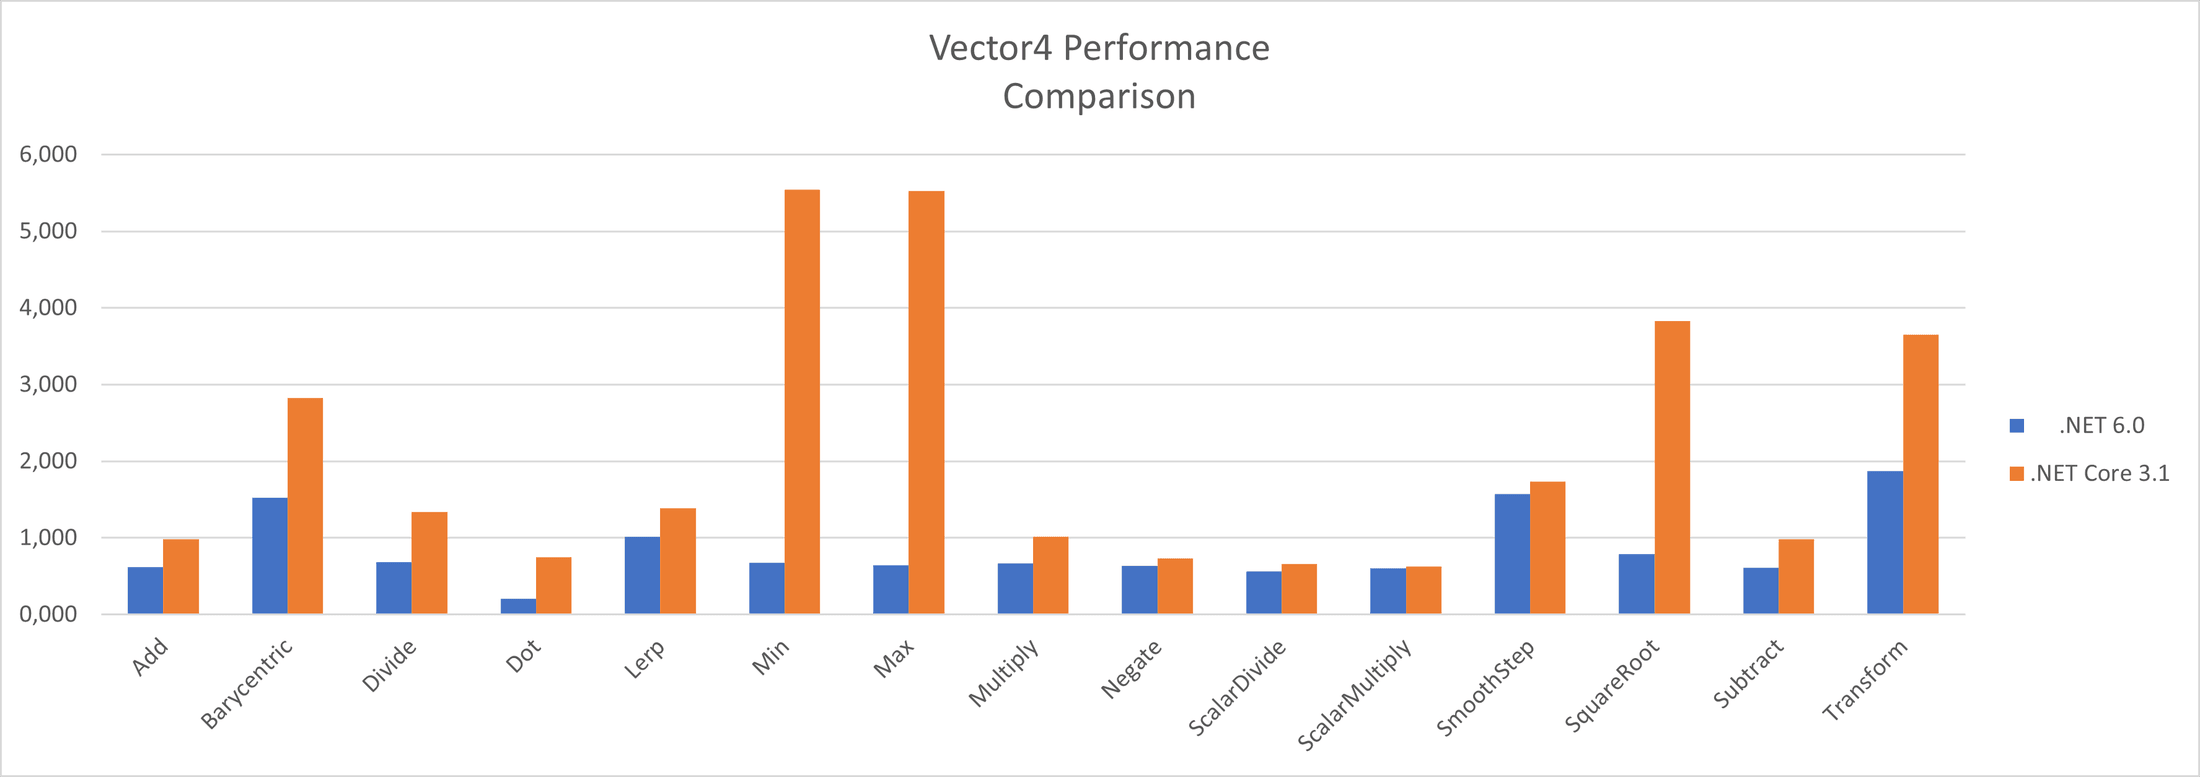
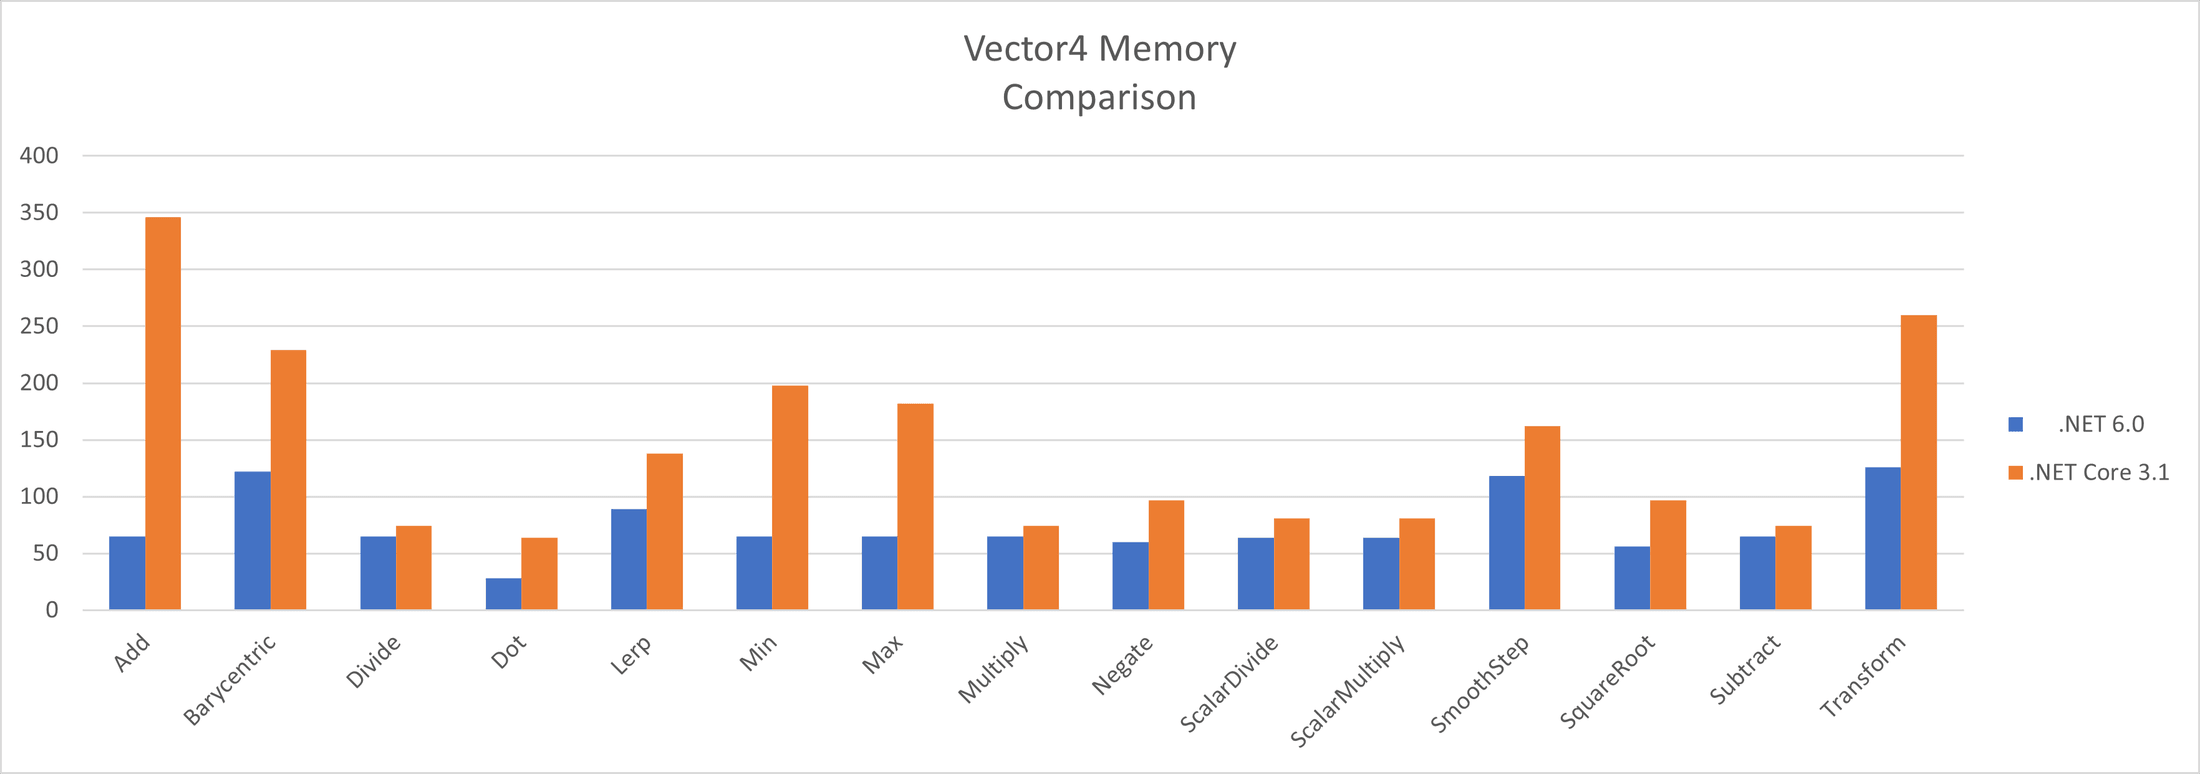
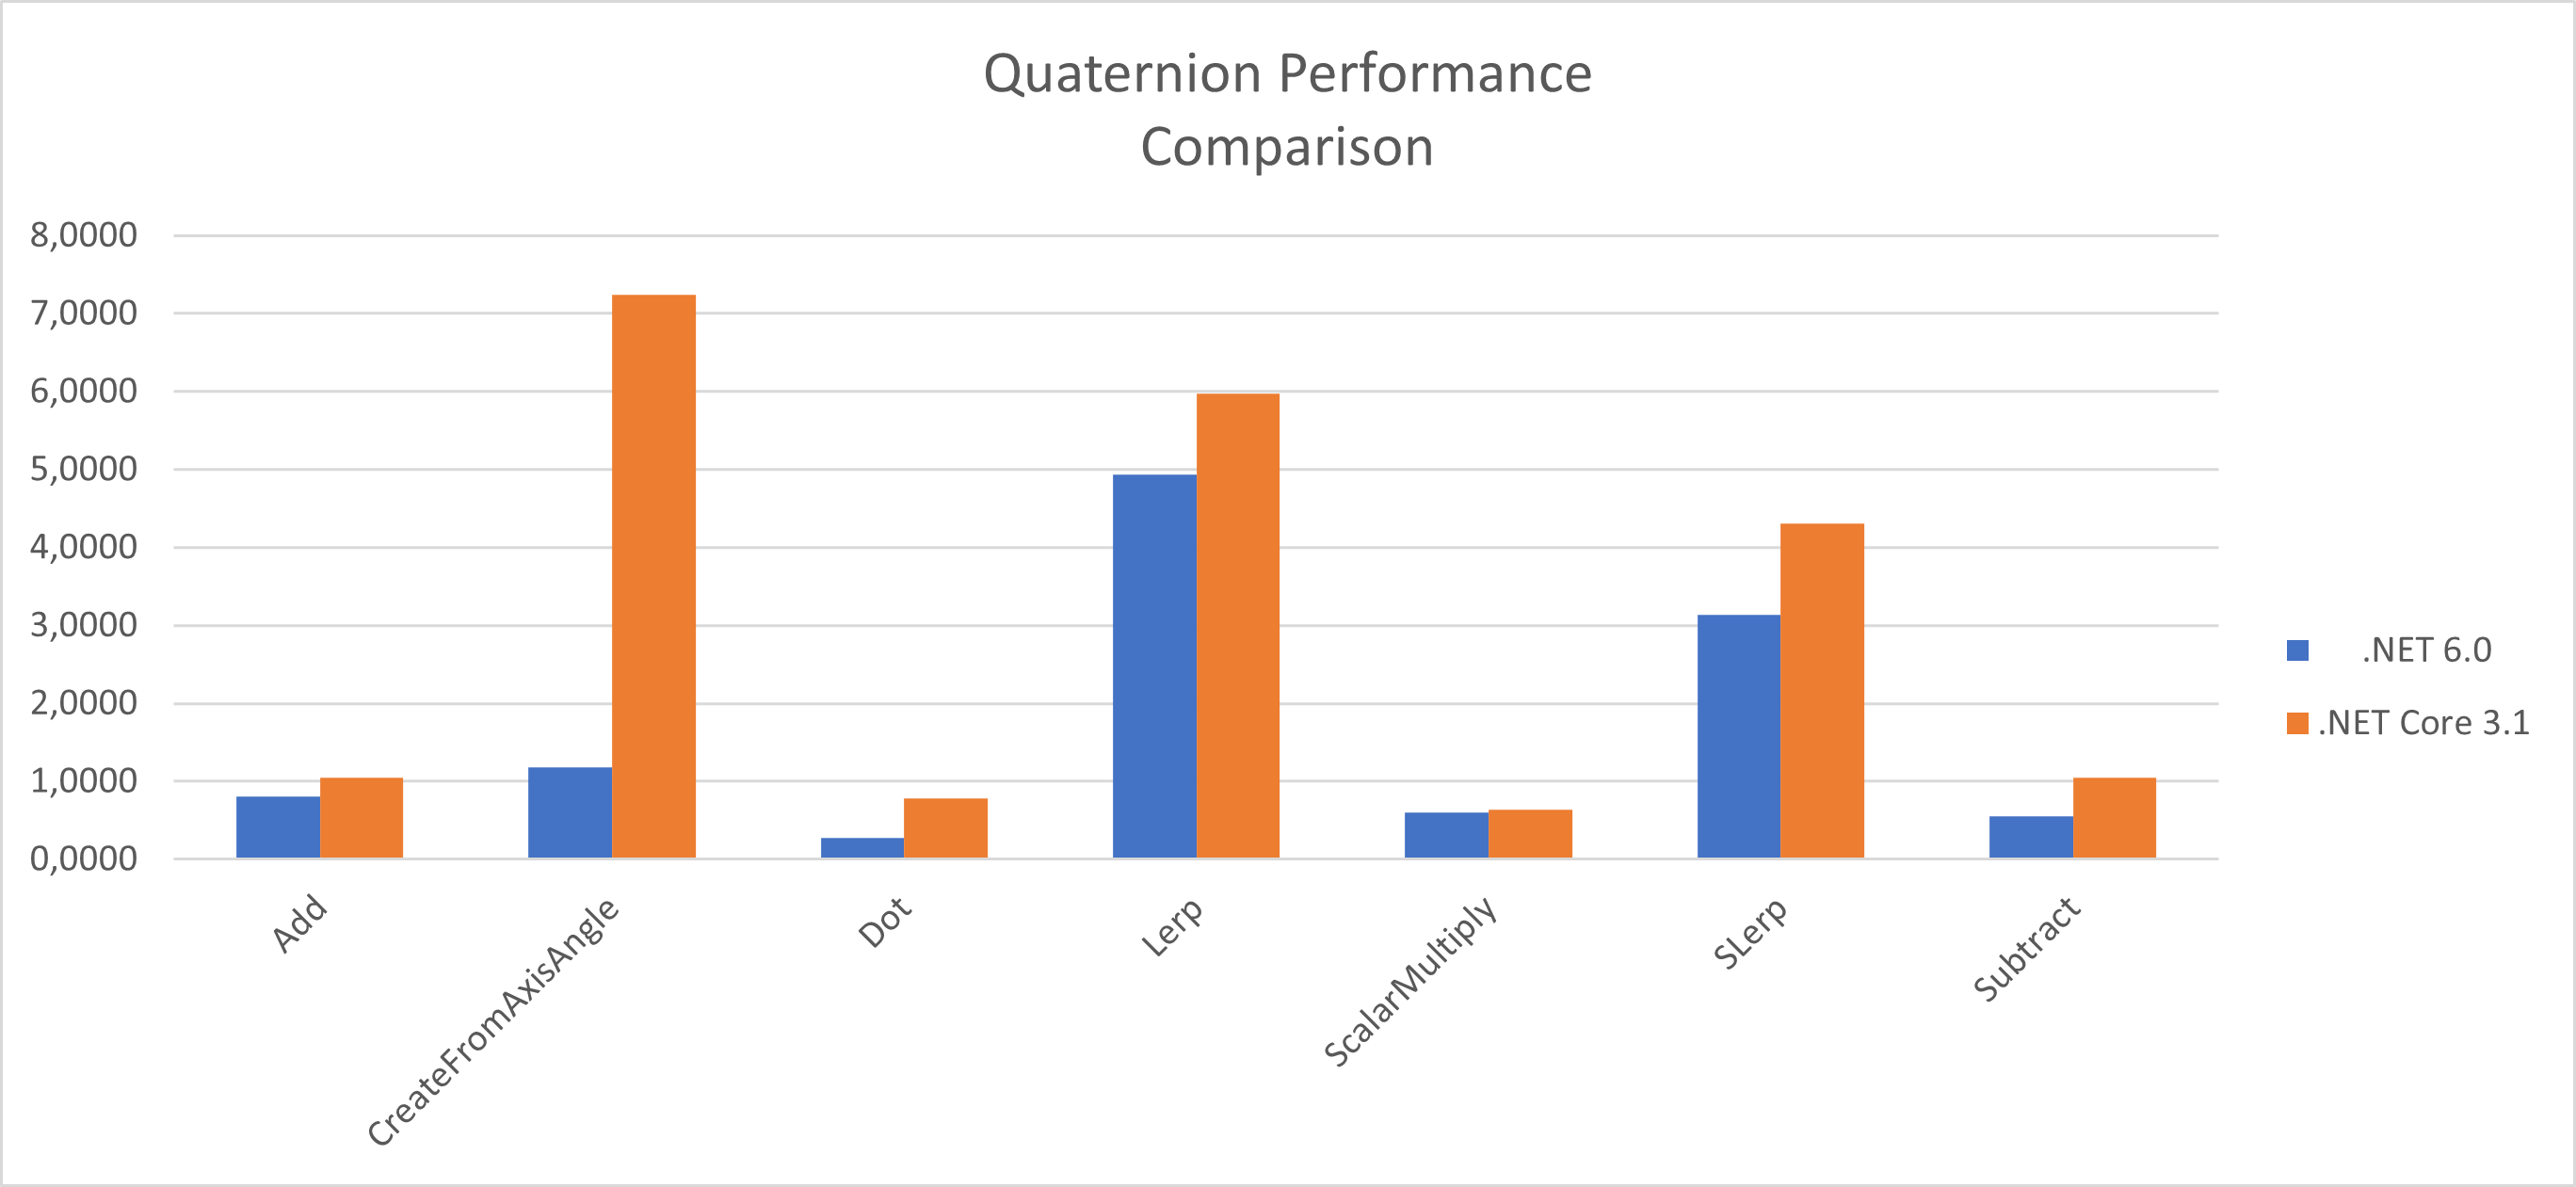
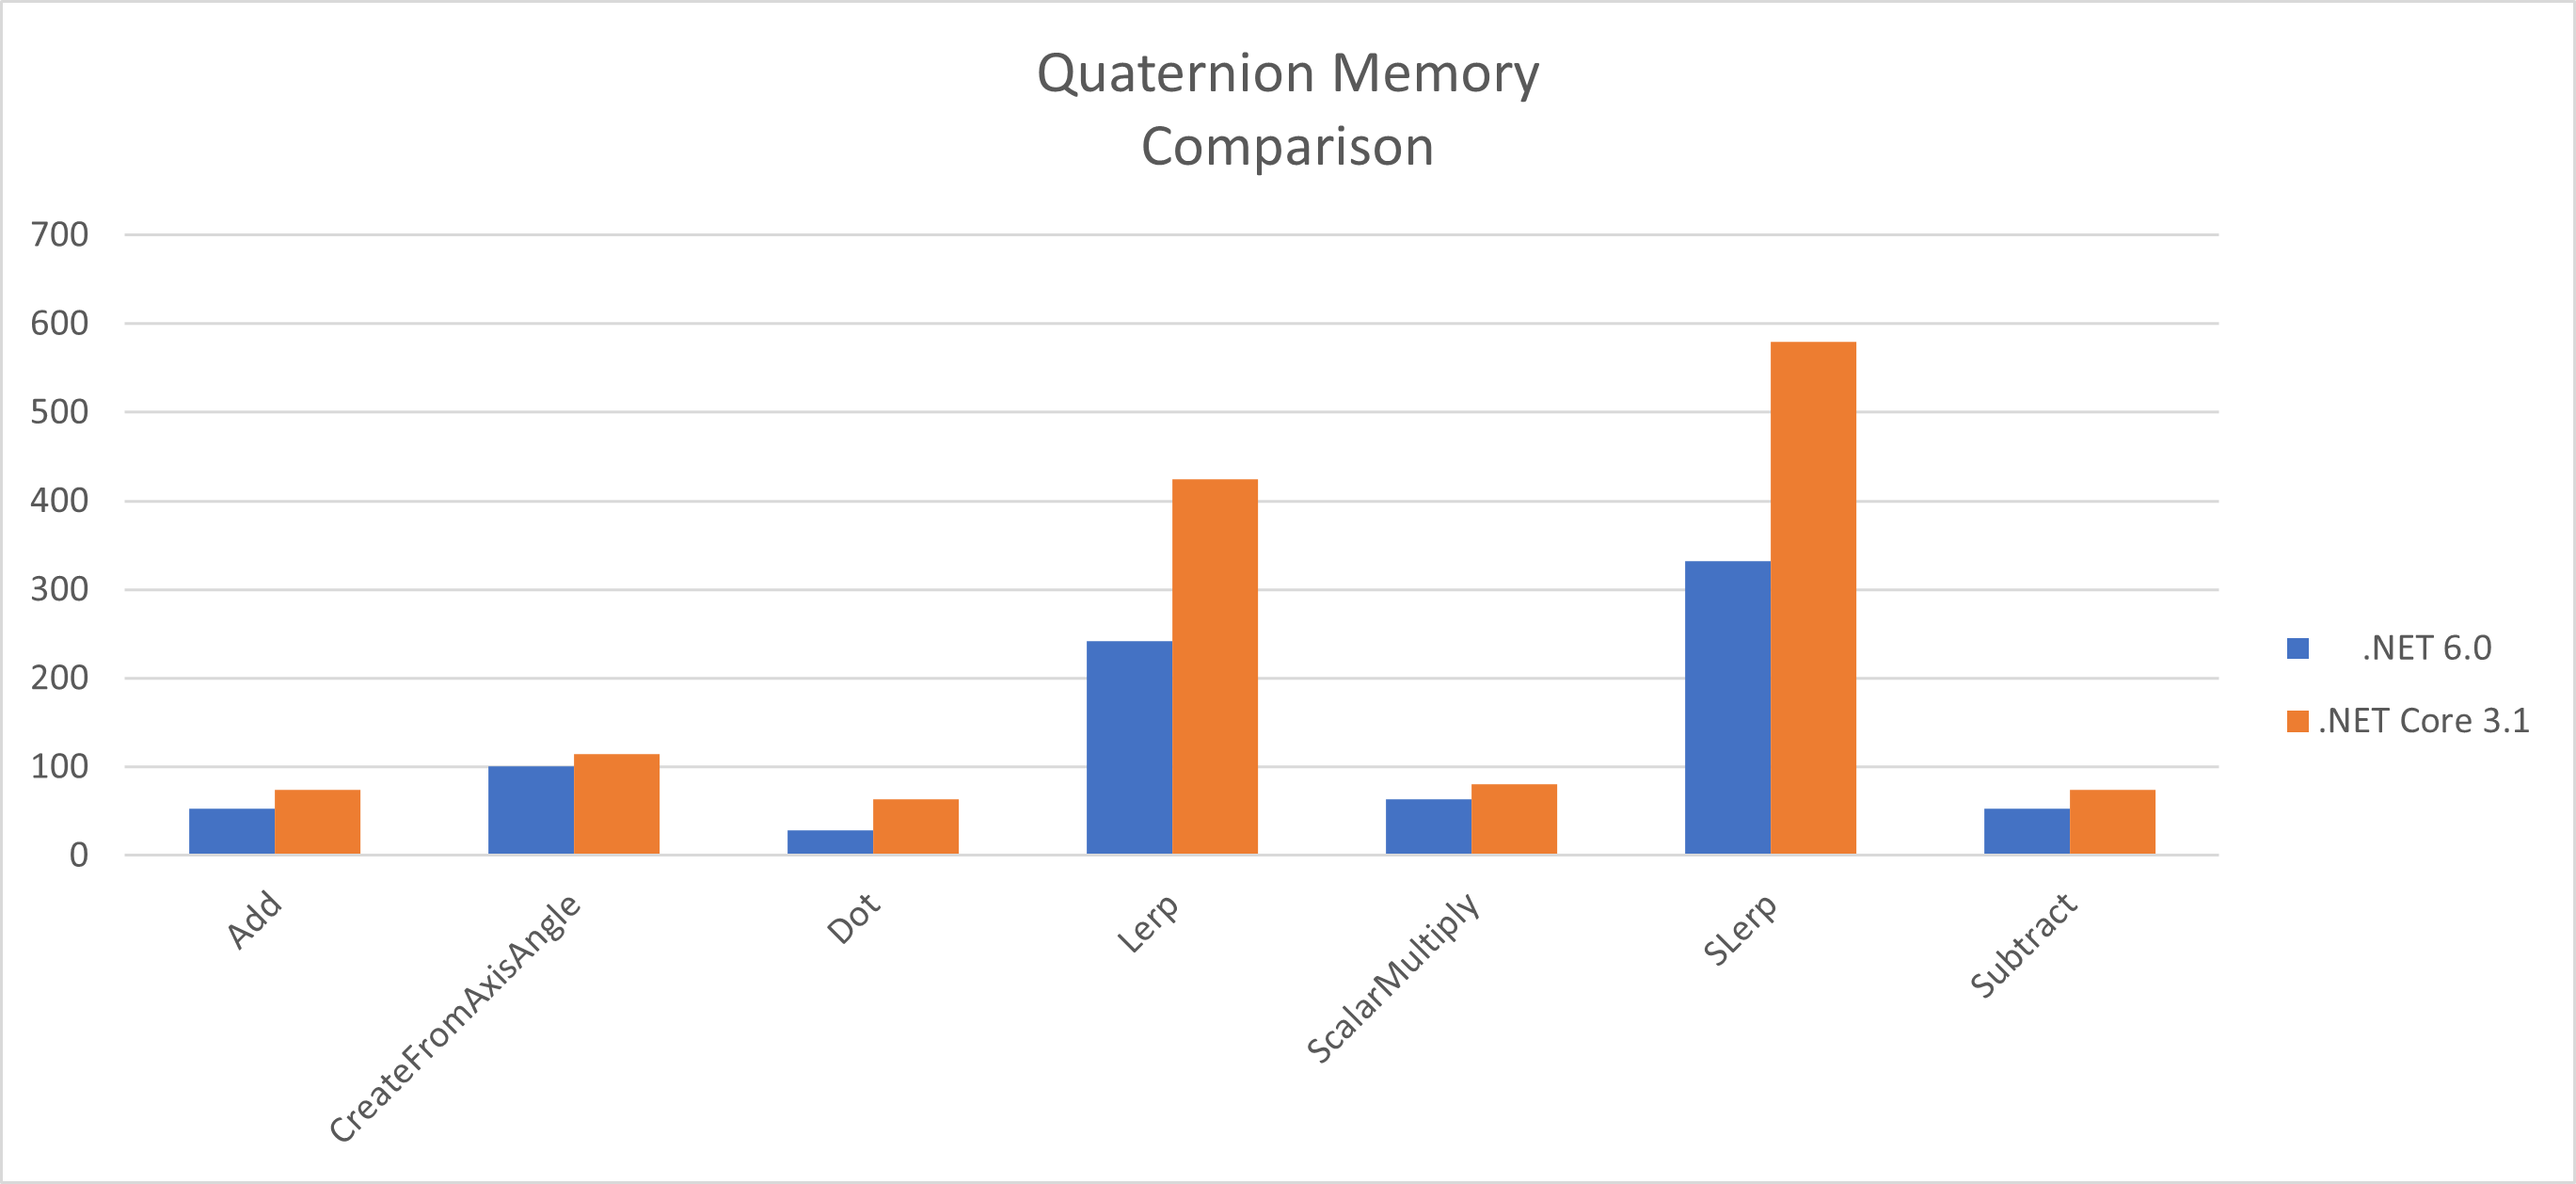
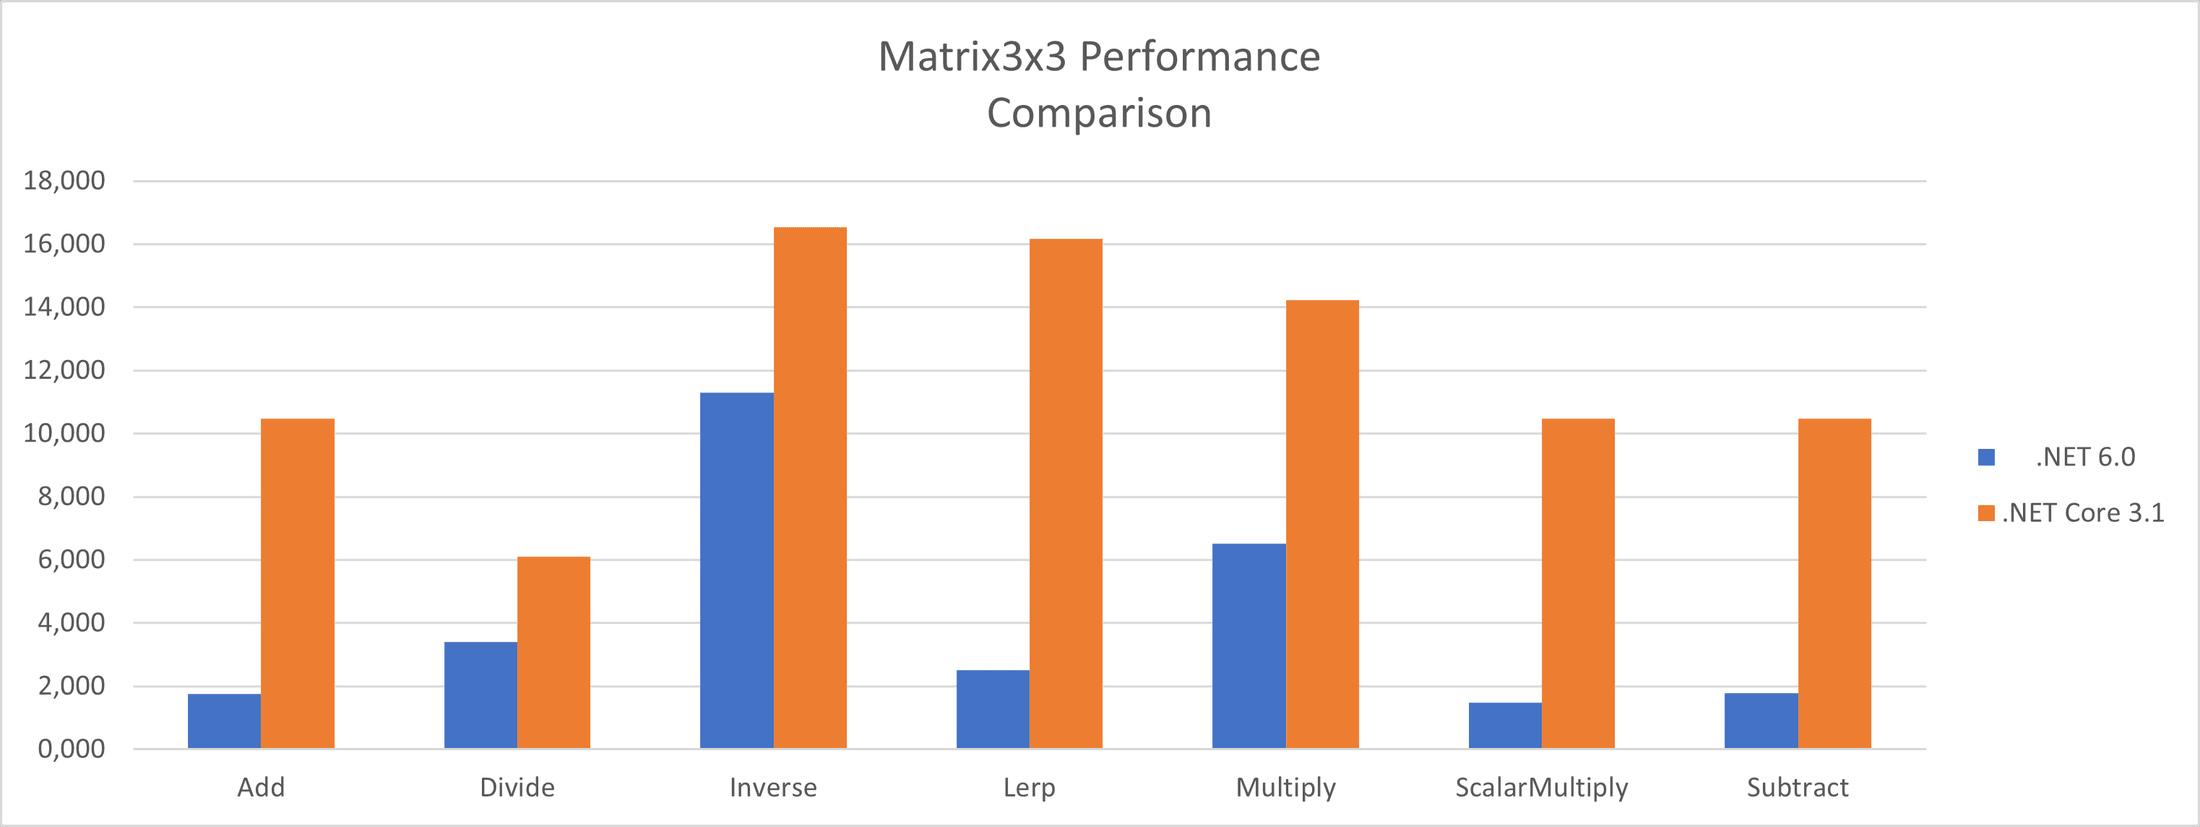
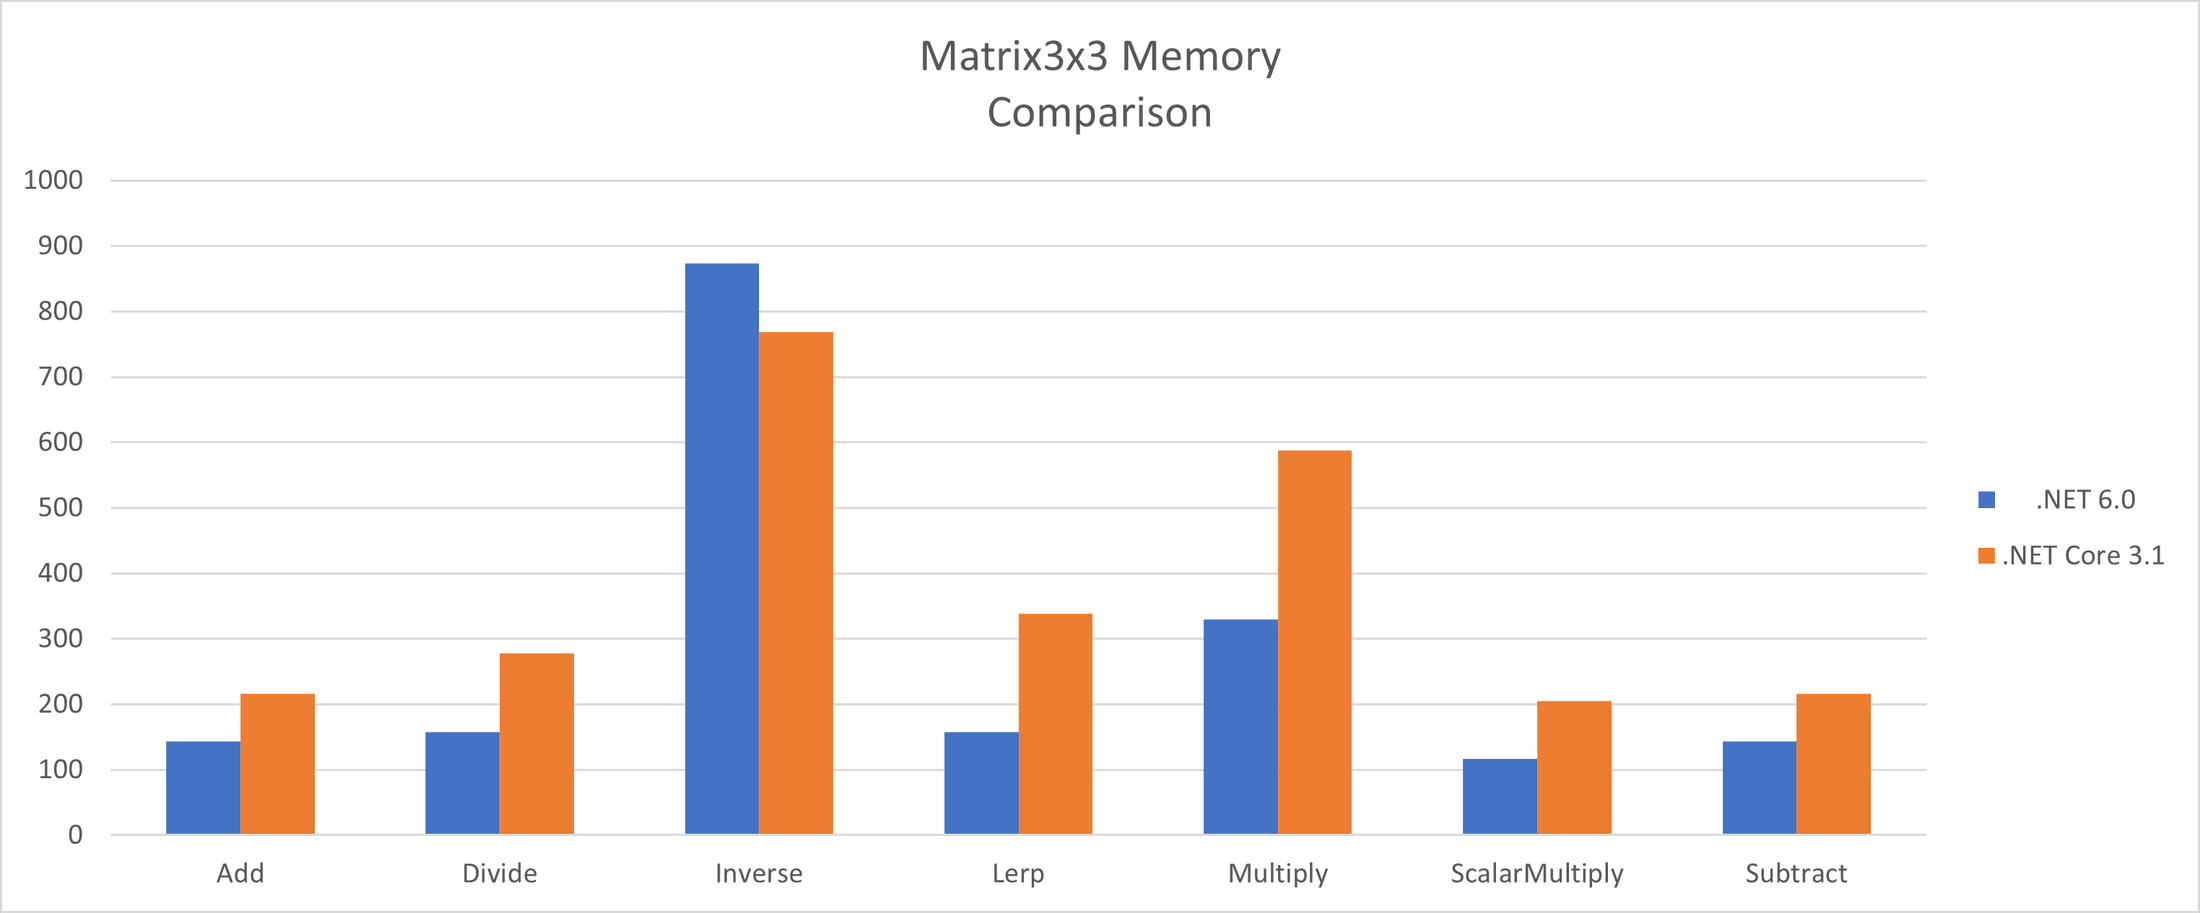
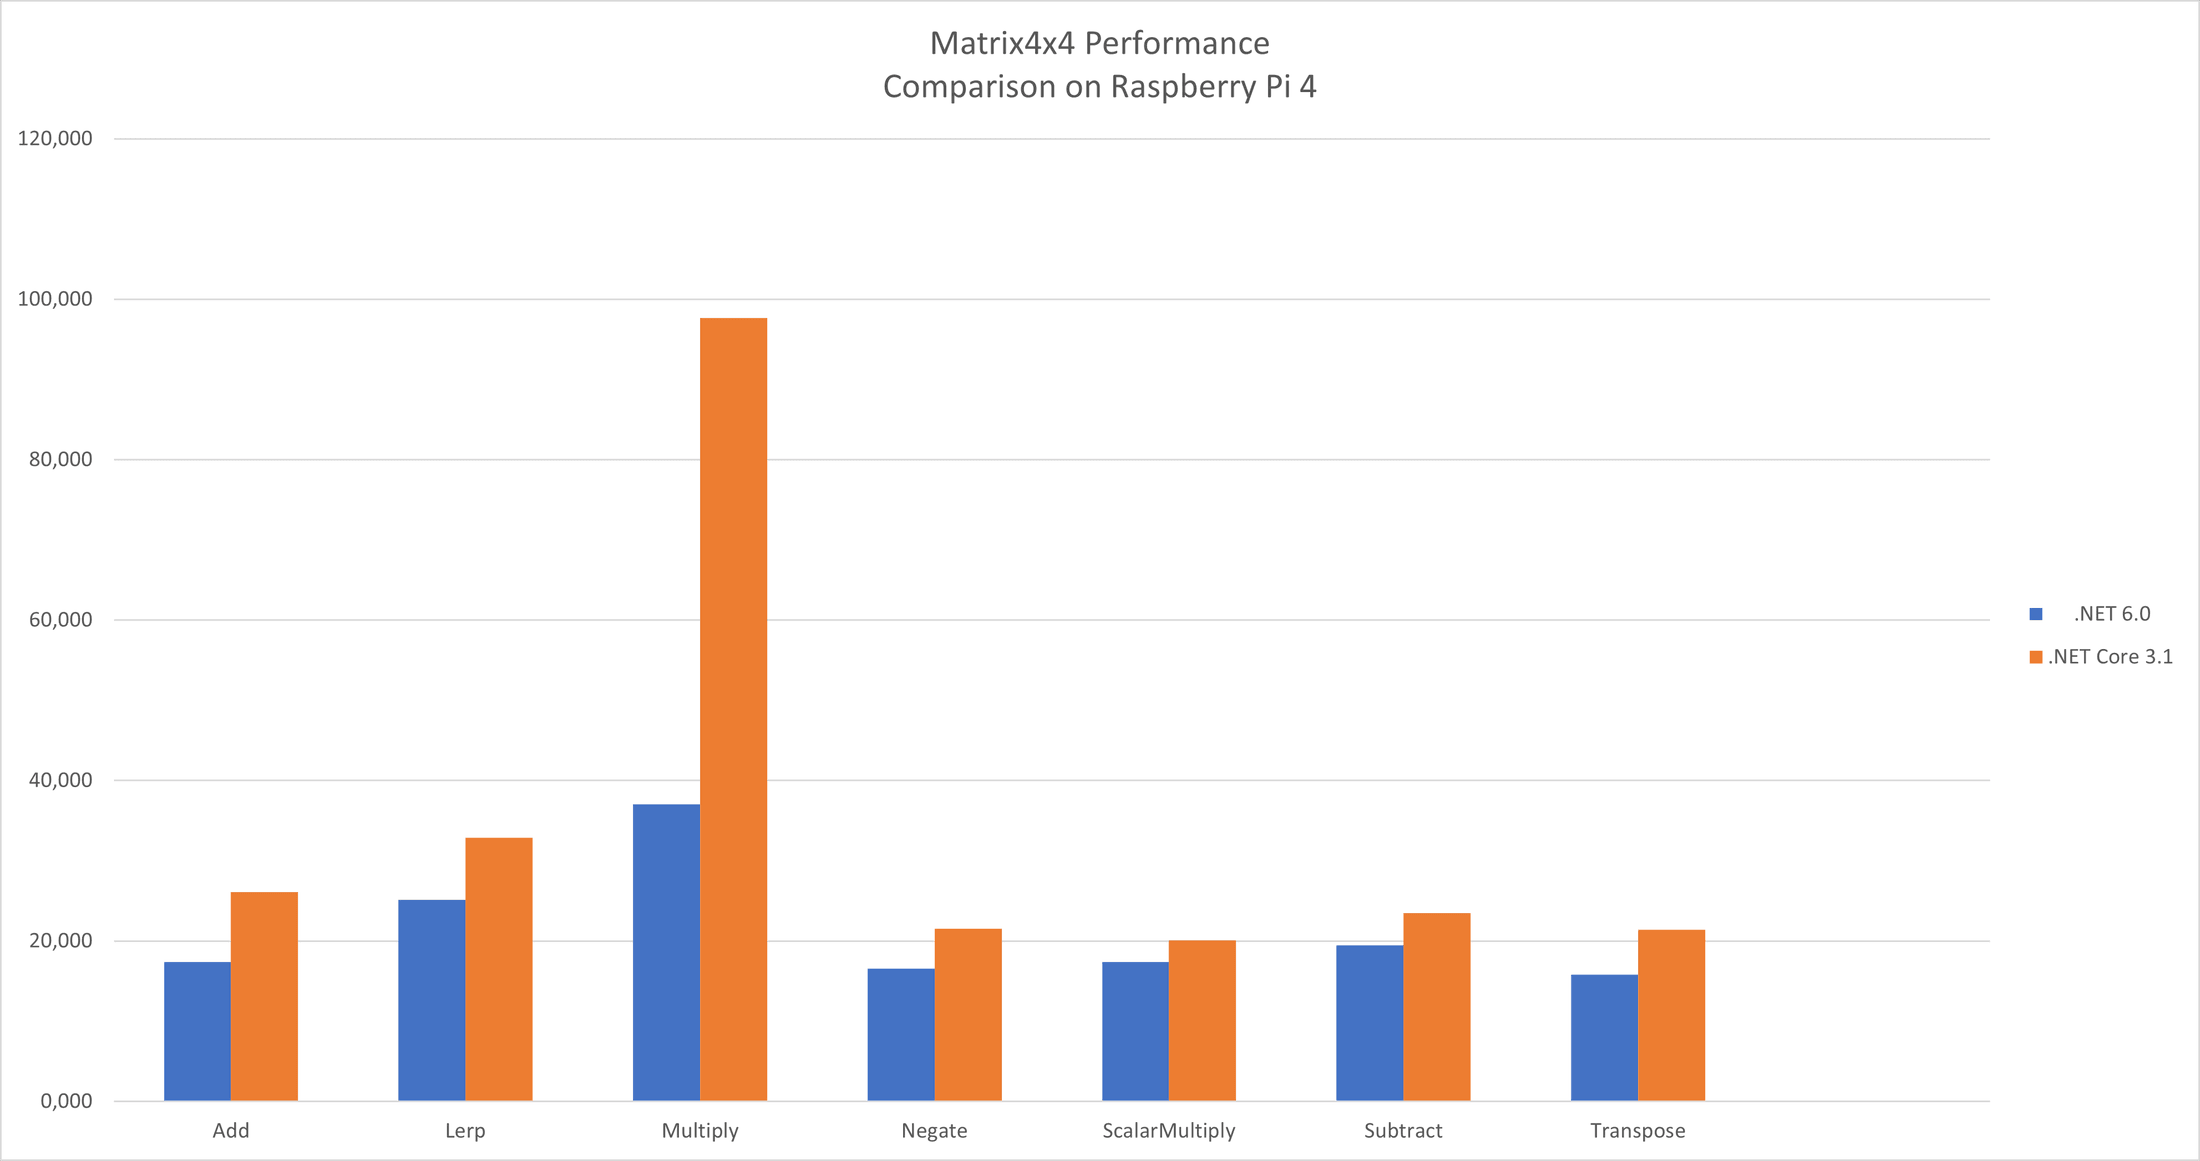
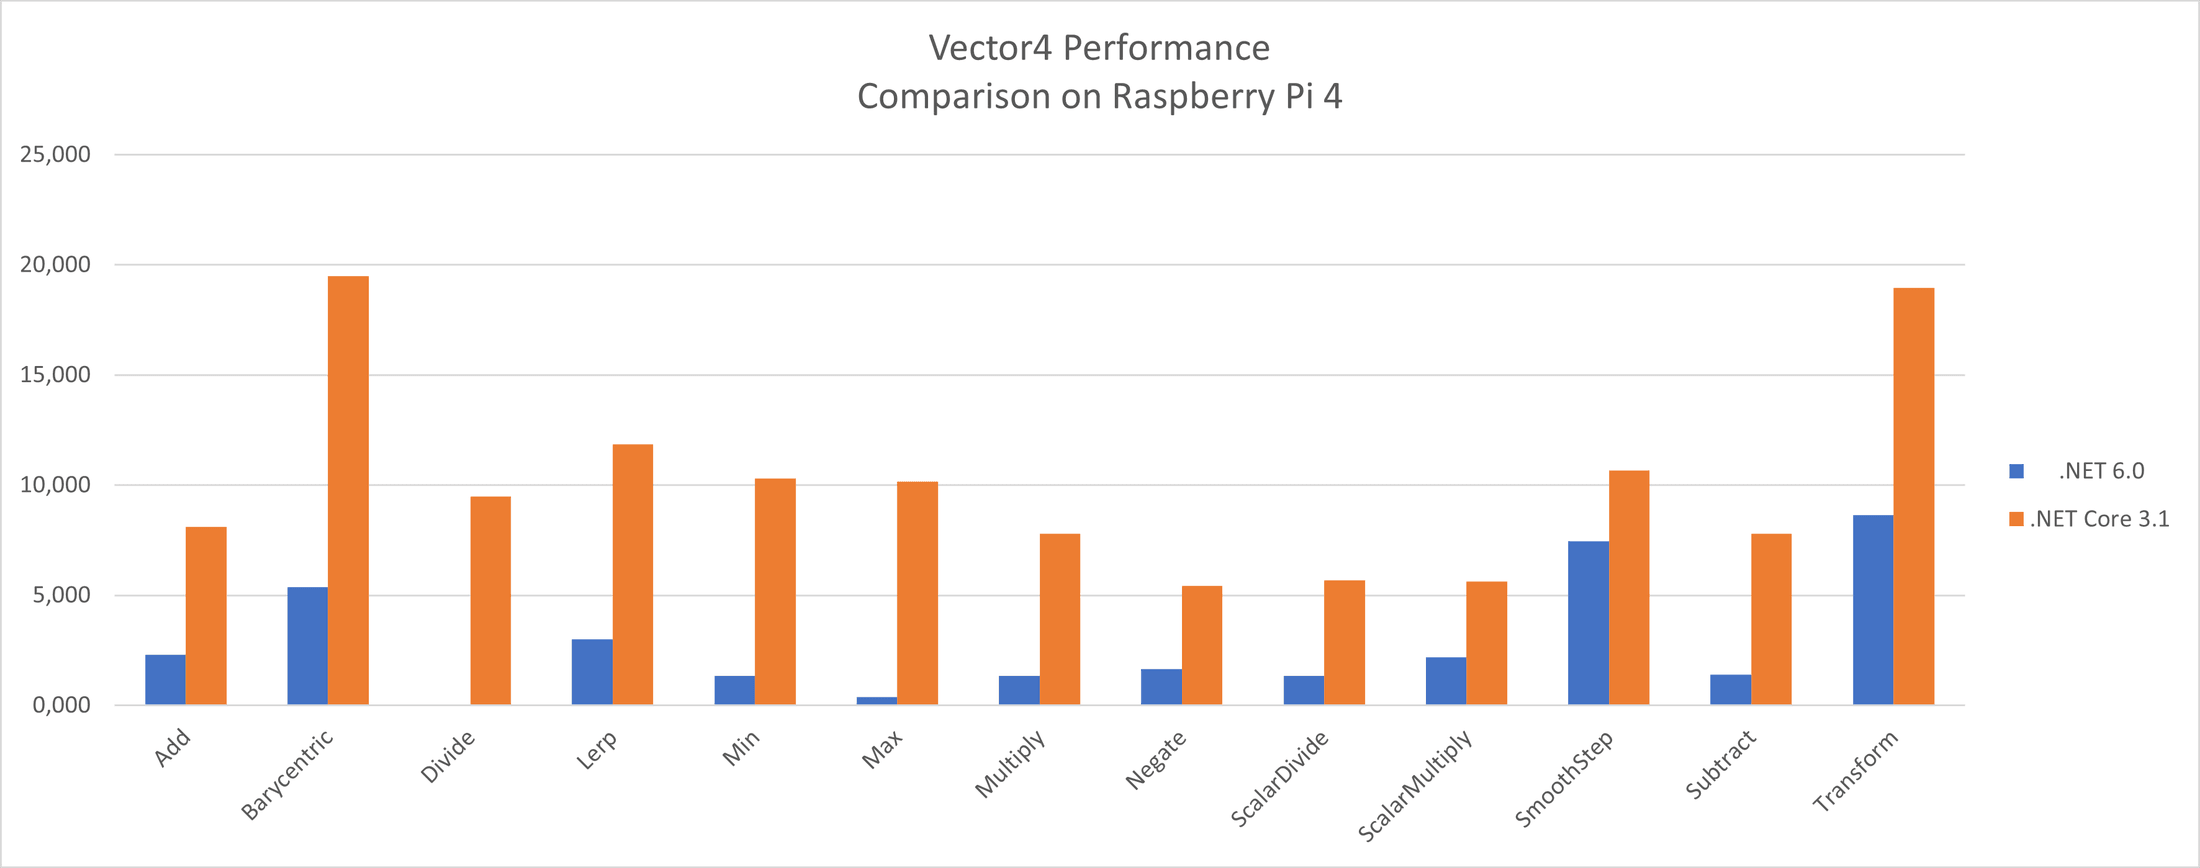
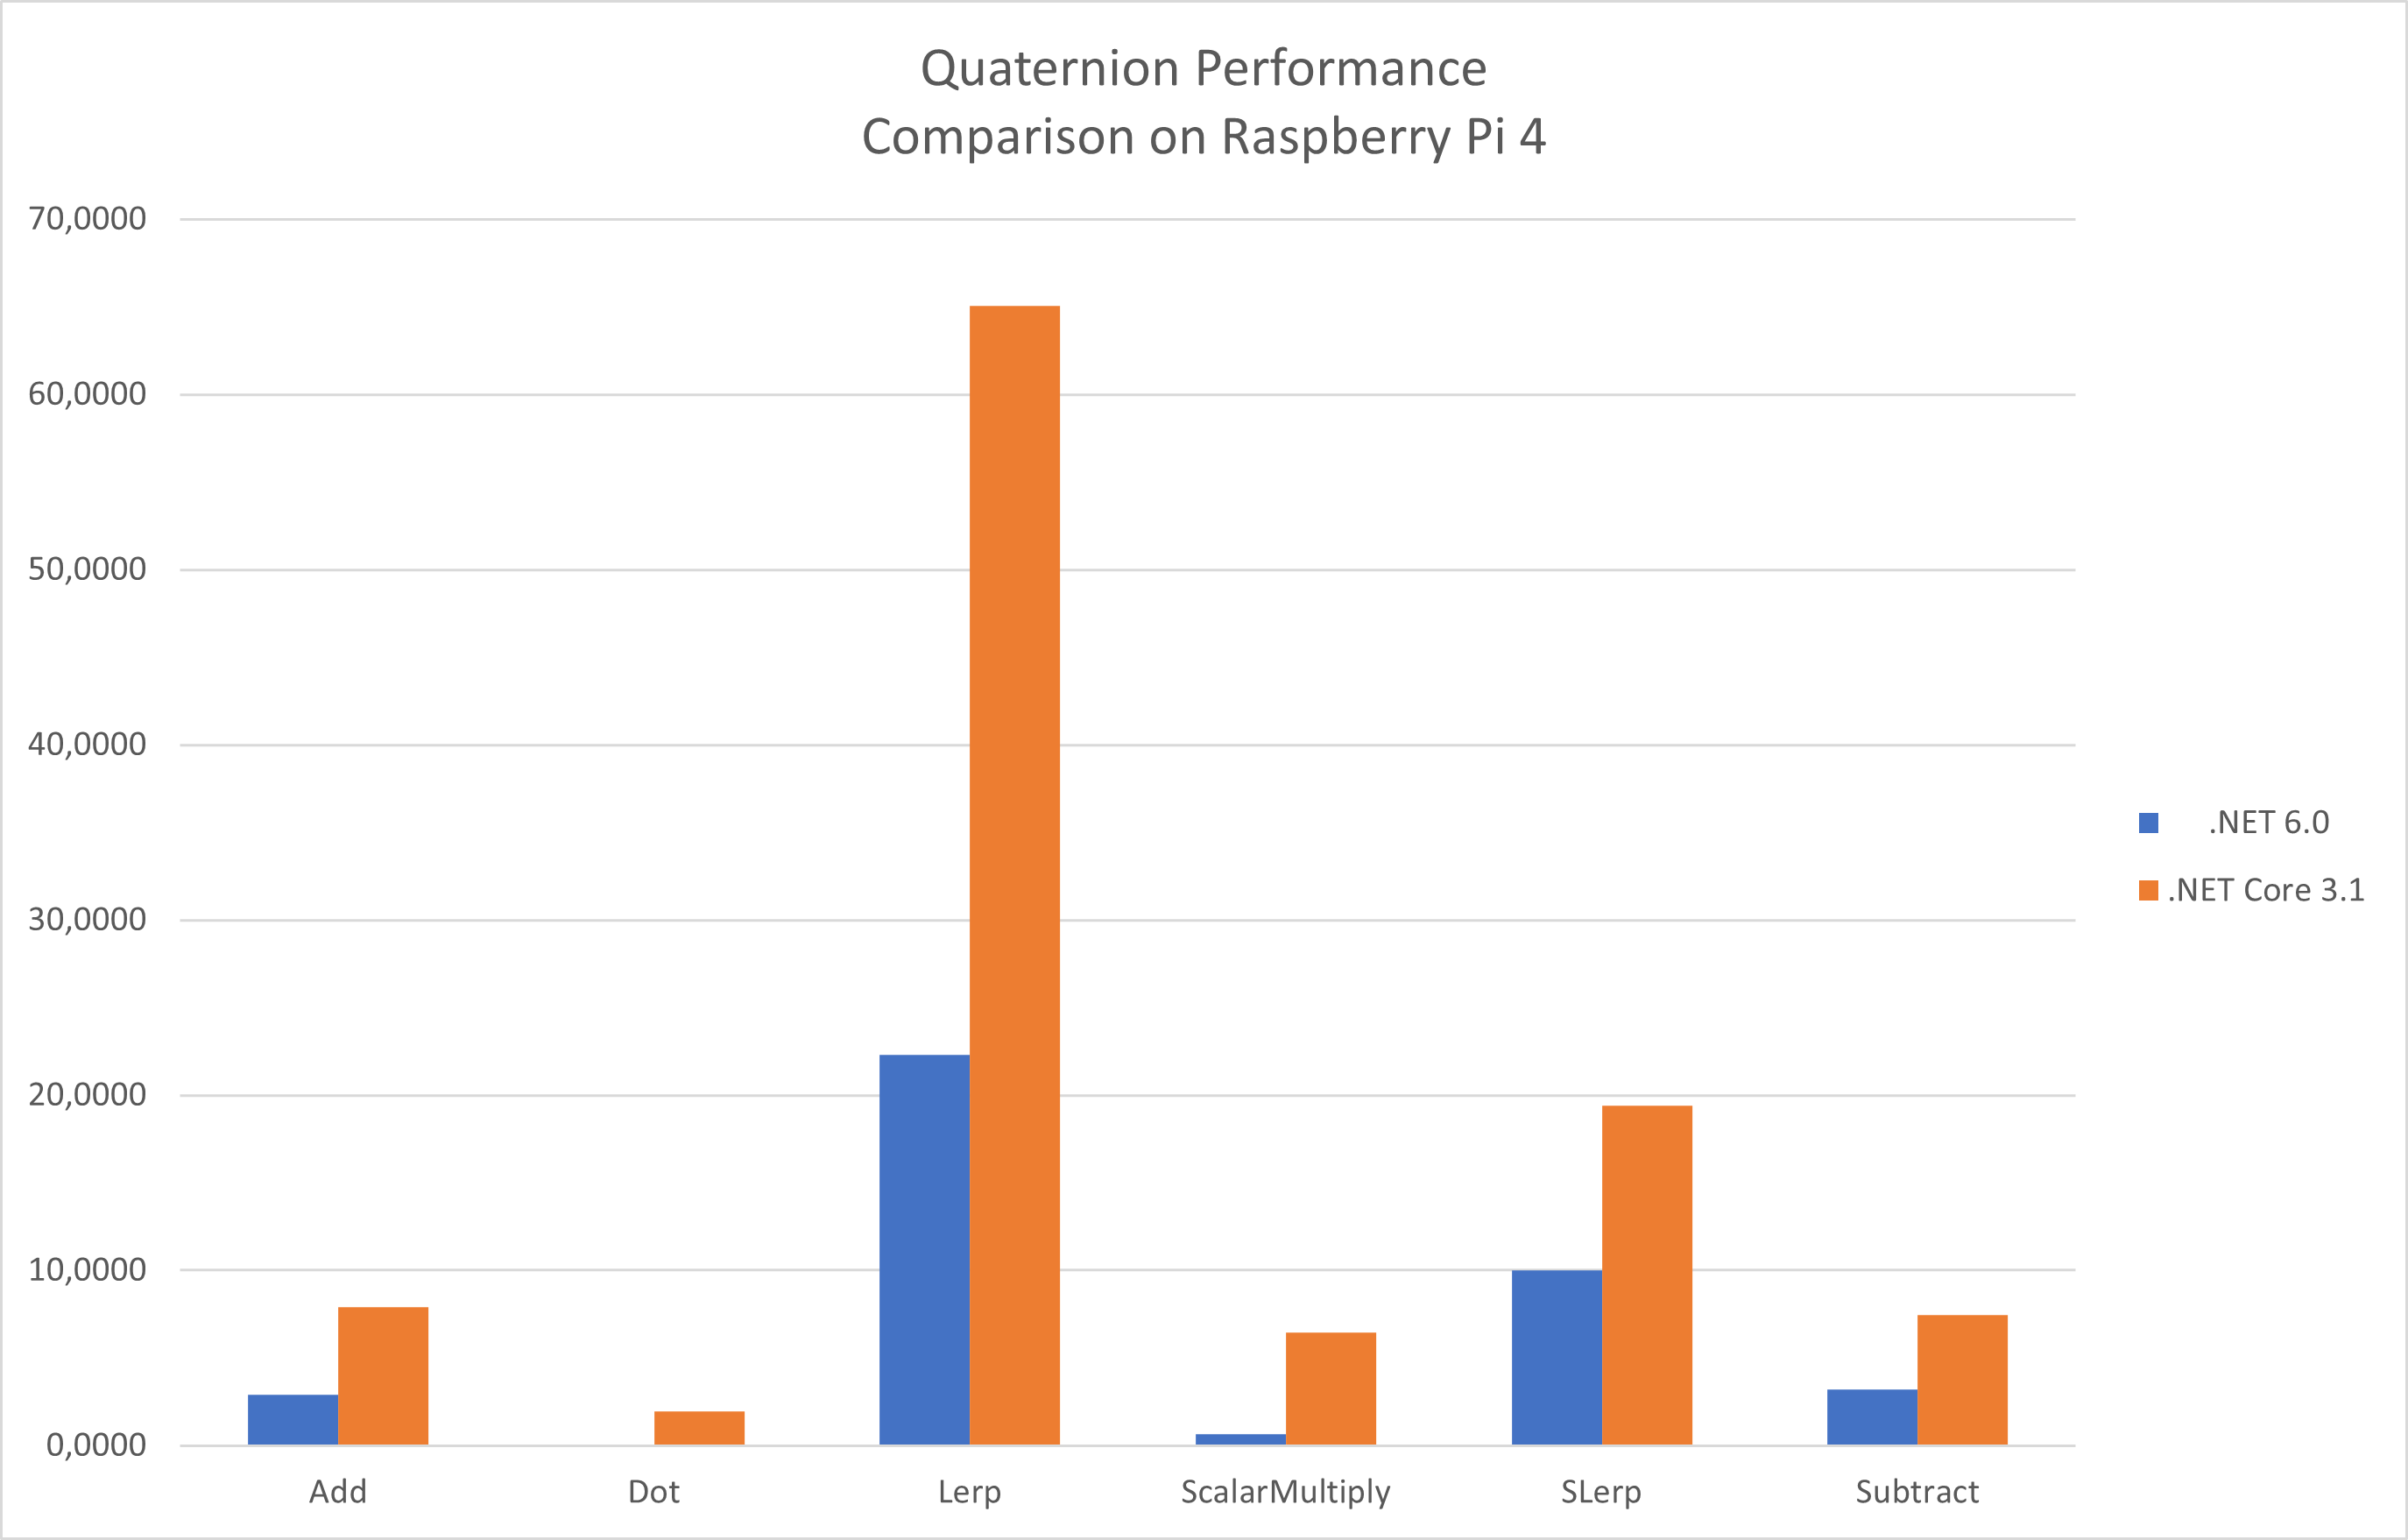
Weは新たなパスもARM64 アーキテクチャ向けに開発しました。この新しいパスのベンチマークにはRaspberry Pi4を使用しました。このアーキテクチャでは、可能な場合にARM AdvSimd命令セットを使用しています。以下は、Ubuntu 22.04.1 LTSを搭載したRasberry Pi4で生成された結果です。
概要
新しいEvergine.Mathematicsライブラリは非常に高速で、実行しているマシンのプラットフォーム固有の機能を活用できます。x86およびx64アーキテクチャではSSEおよびAVX命令、ARM64デバイスではAdvSimdを使用することで、以前より3~4倍高速化されています。
次のステップはあなた次第です。新しいEvergine.Mathematicsライブラリにより、これらのパフォーマンス向上をすべてのプロジェクトで活用するために、新しいリリースをダウンロードしてください。