Des mathématiques plus rapides que jamais
Avec la nouvelle version Evergine 2022.9.28, nous avons publié une nouvelle version de notre bibliothèque Evergine.Mathematics, qui utilise un jeu d'instructions accéléré par le matériel conçu par les fabricants de CPU.
C'est possible grâce à la nouvelle API d'intrinsèques matérielles créée pour Net6, qui permet d'utiliser les instructions SIMD (Single Instruction, Multiple Data) sur les architectures cibles x86, x64 et ARM64 si le matériel les prend en charge. Avec cette nouvelle API, nous pouvons vérifier si ces extensions sont présentes dans le matériel et, si possible, utiliser des vecteurs de registres de 128 et 256 bits pour vectoriser le code et exécuter plusieurs opérations primitives en un seul cycle (le cycle étant l'unité de temps de base d'un CPU).
Nous avons utilisé ces instructions pour optimiser les opérations des structures les plus importantes de notre bibliothèque Evergine.Mathematics, comme Matrix4x4, Vector4, Matrix3x3 et Quaternion, et les résultats sont impressionnants.
Benchmarks
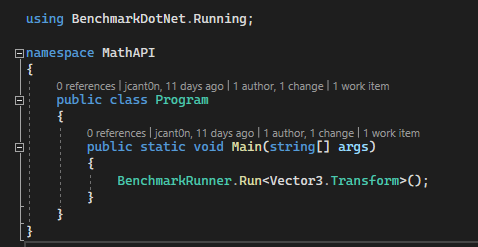
Pour créer des microbenchmarks, nous avons utilisé benchmarkdotnet. Voici la configuration utilisée pour lancer la comparaison sur Matrix4x4.
Contenu du fichier program.cs :
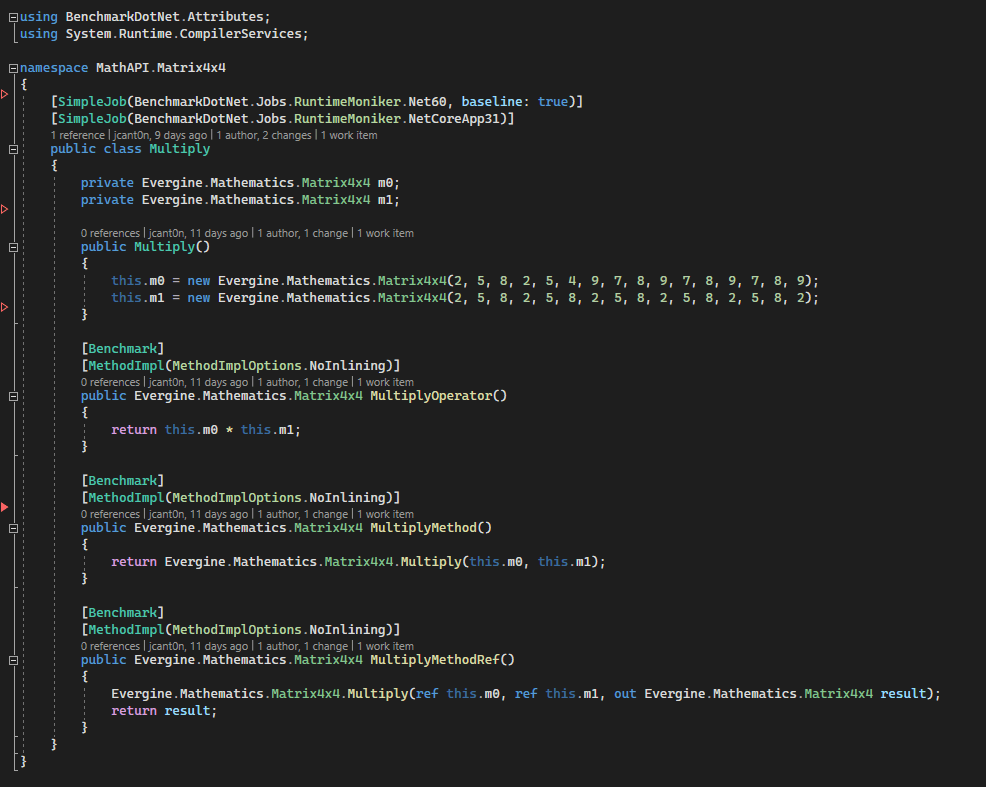
Contenu du test de multiplication de Matrix4x4 :
Le CPU utilisé pour tous les benchmarks x86 et x64 présentés dans cet article est le suivant :
Intel Core i9-10980HK CPU 2.40GHz, 1 CPU, 16 cœurs logiques et 8 cœurs physiques
Et voici les résultats détaillés générés par benchmarkdotnet :
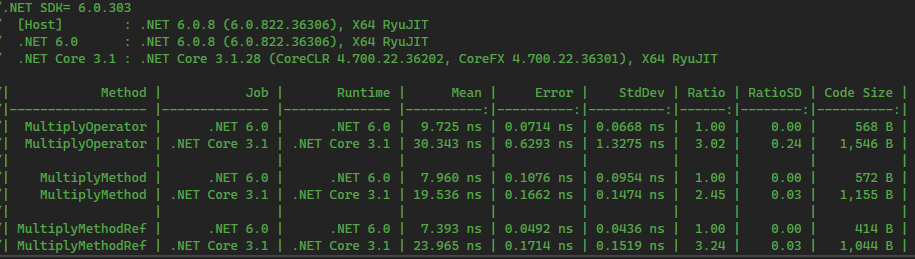
Comme vous pouvez le constater, par rapport au chemin le plus rapide jusqu'ici, MultiplyMethodRef, où les paramètres matriciels sont passés par référence plutôt que par copie, le nouveau chemin pour Net6, qui utilise ici les instructions SIMD SSE, ne nécessite que 7,393 ns contre 23,965 ns. La taille du code passe également de 1 044 octets à 414 octets. D'excellents résultats pour l'une des opérations mathématiques les plus utilisées dans un moteur graphique 3D.
Pour visualiser l'amélioration des performances sur les architectures x86 et x64, nous avons créé un graphique pour chaque structure mathématique.
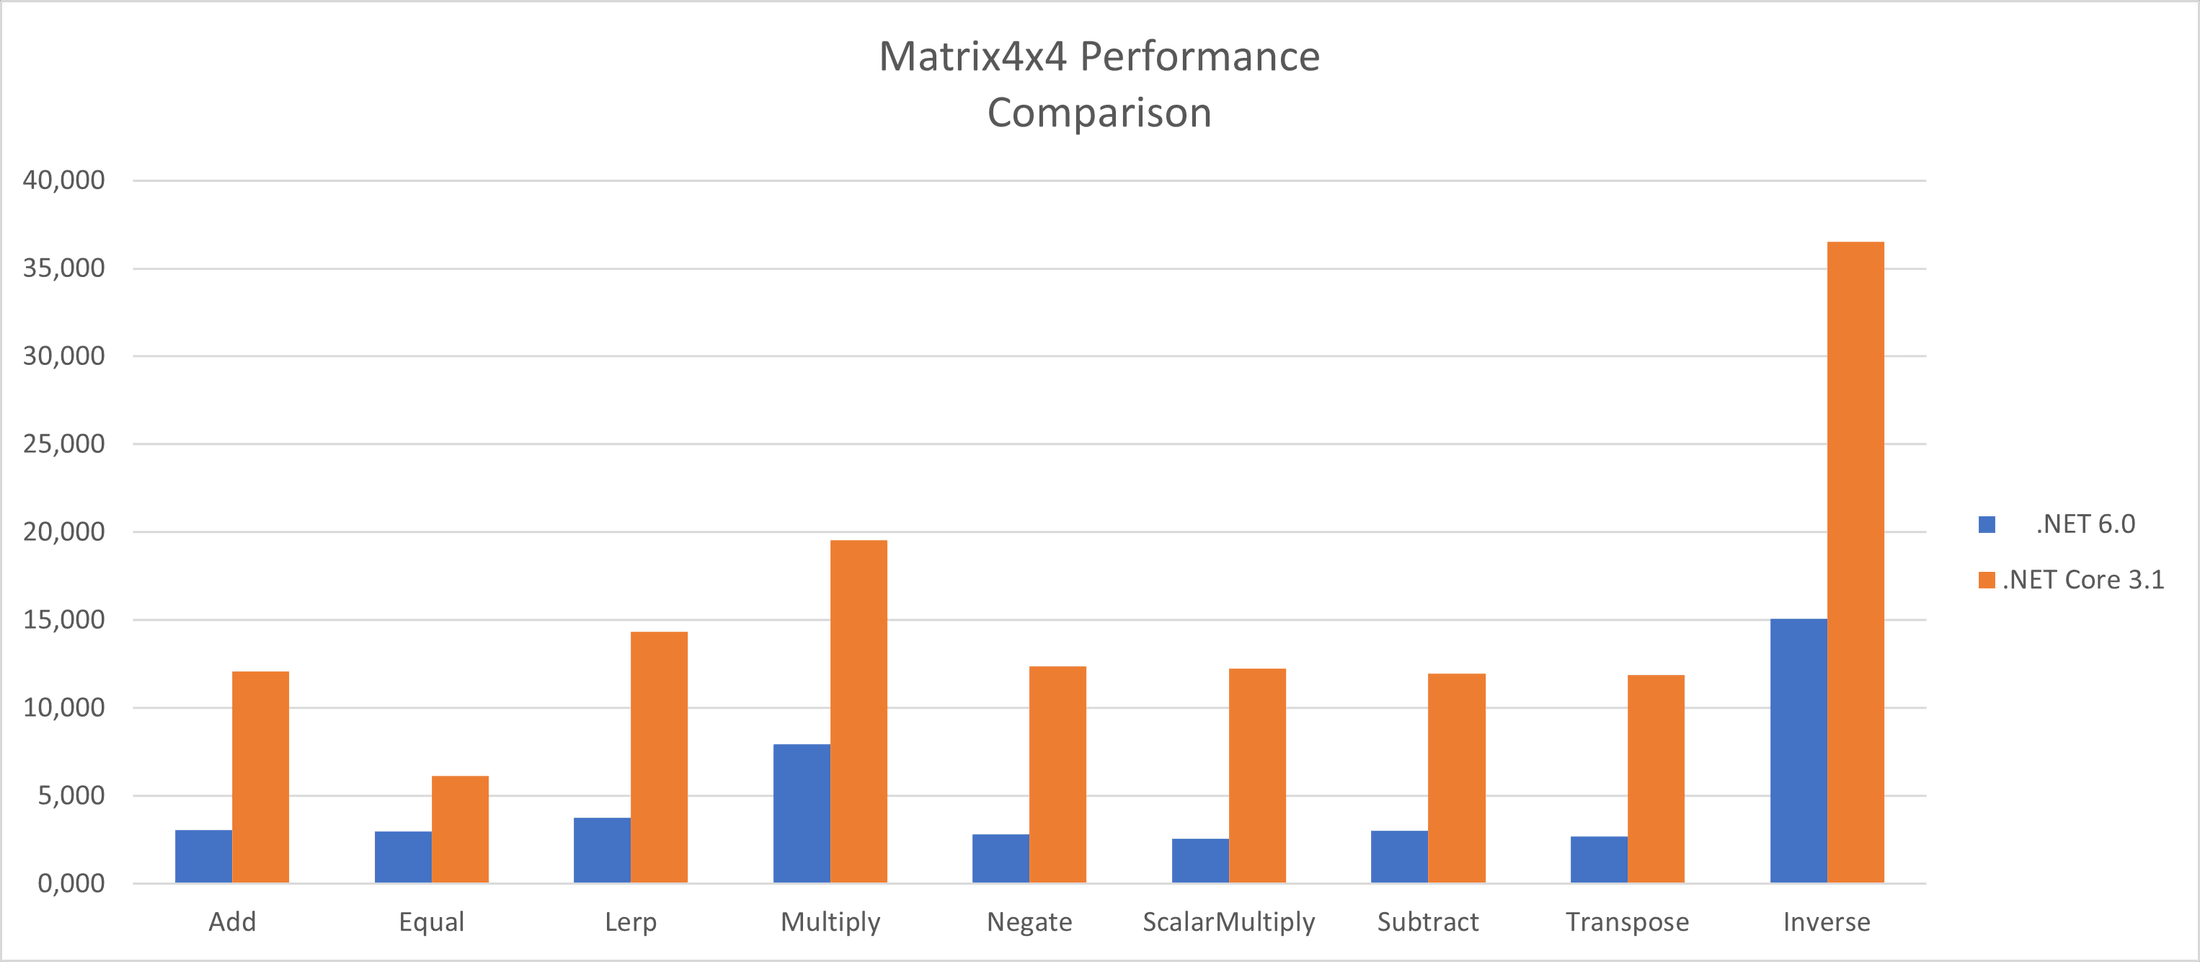
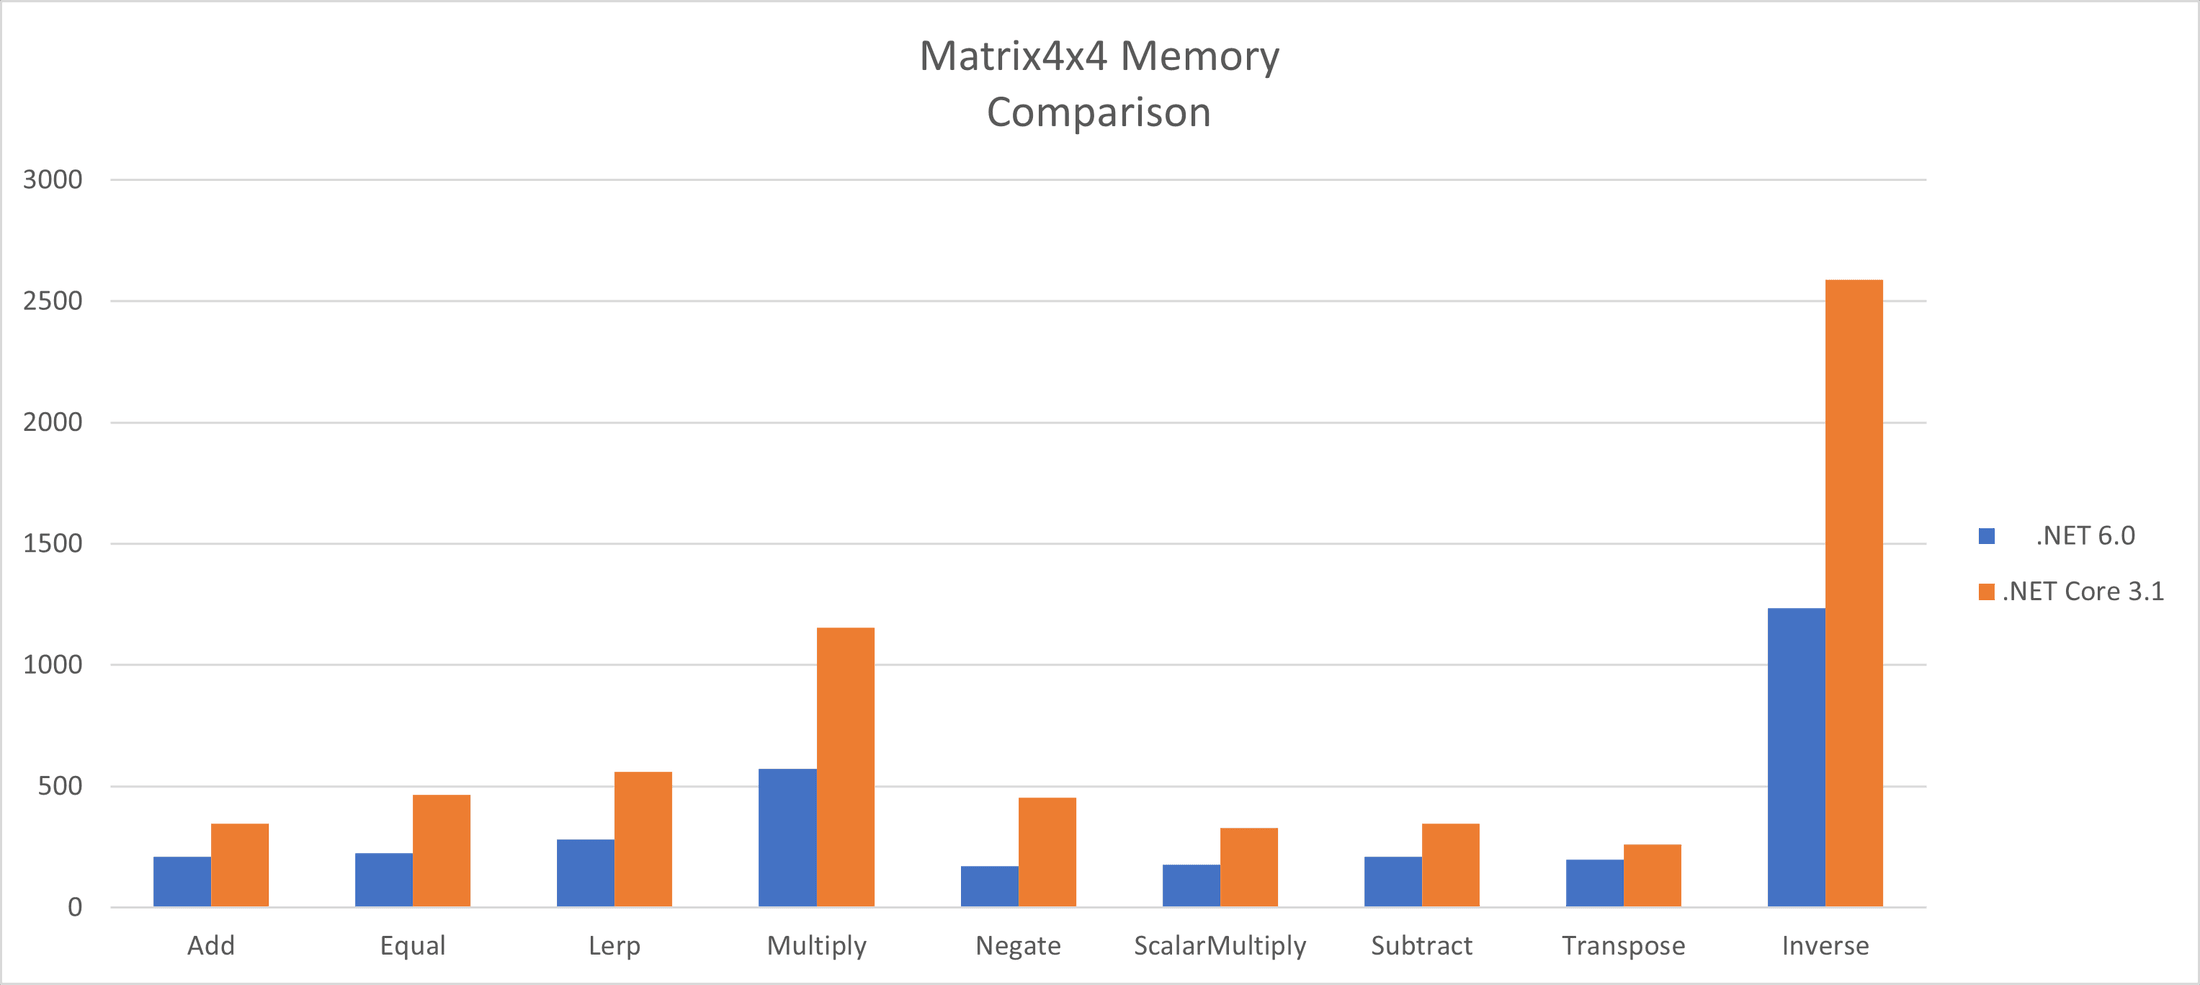
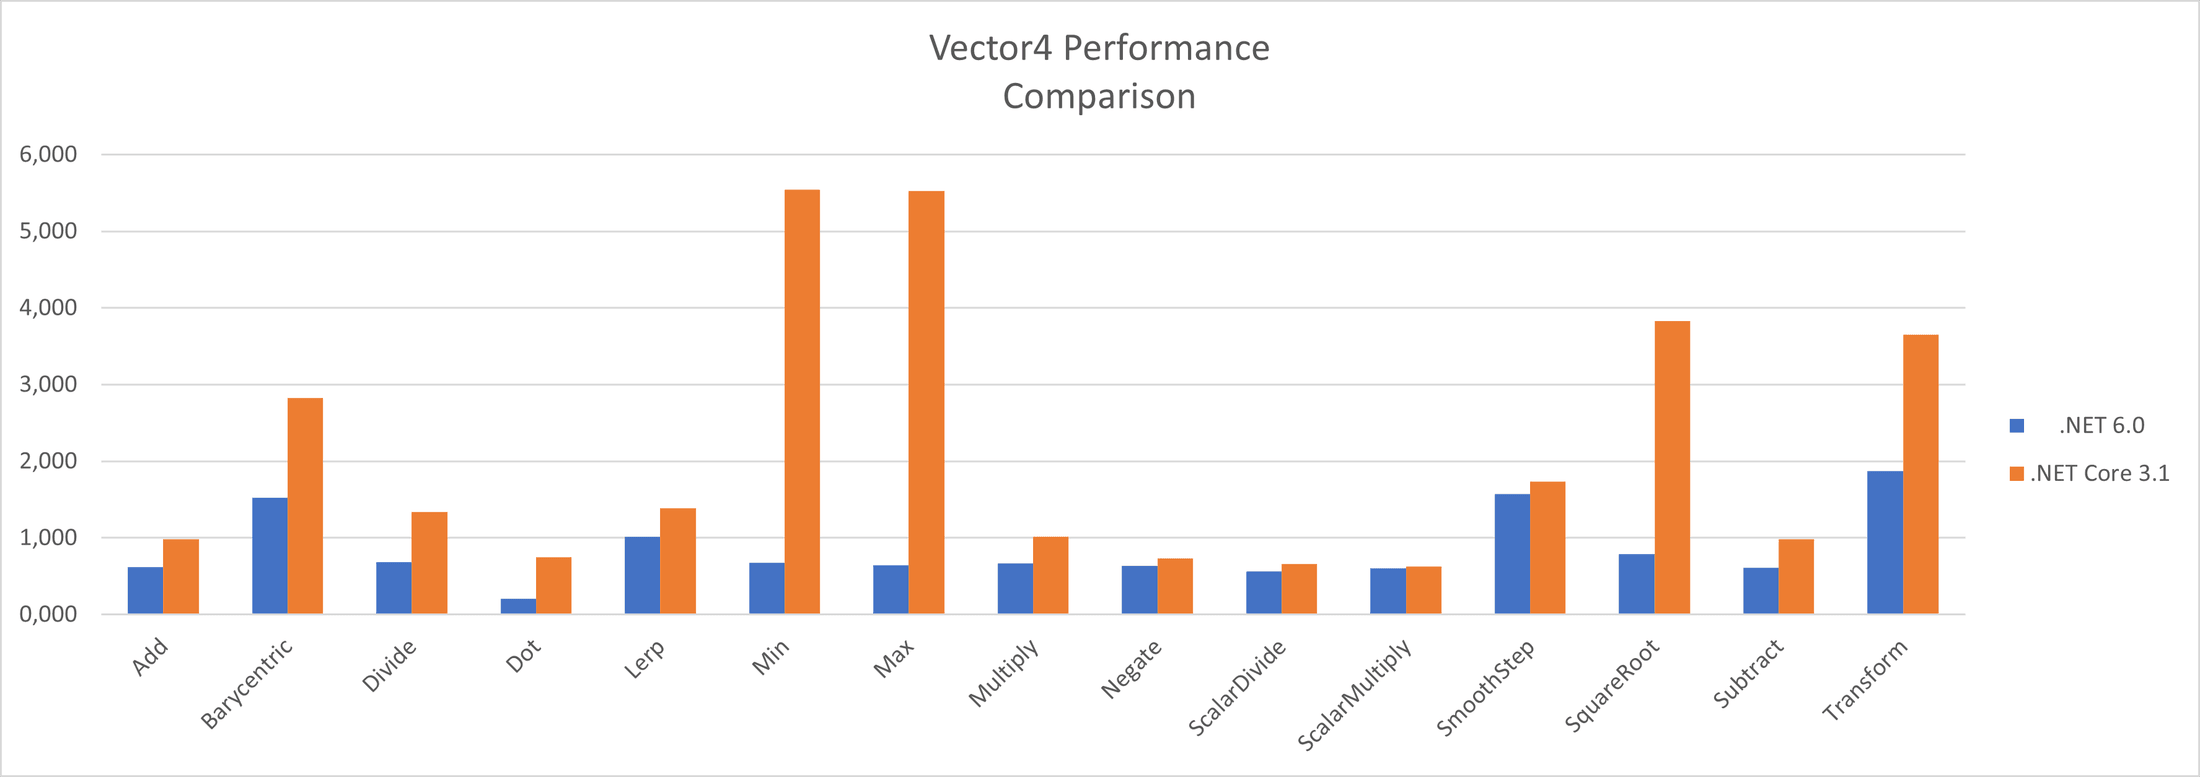
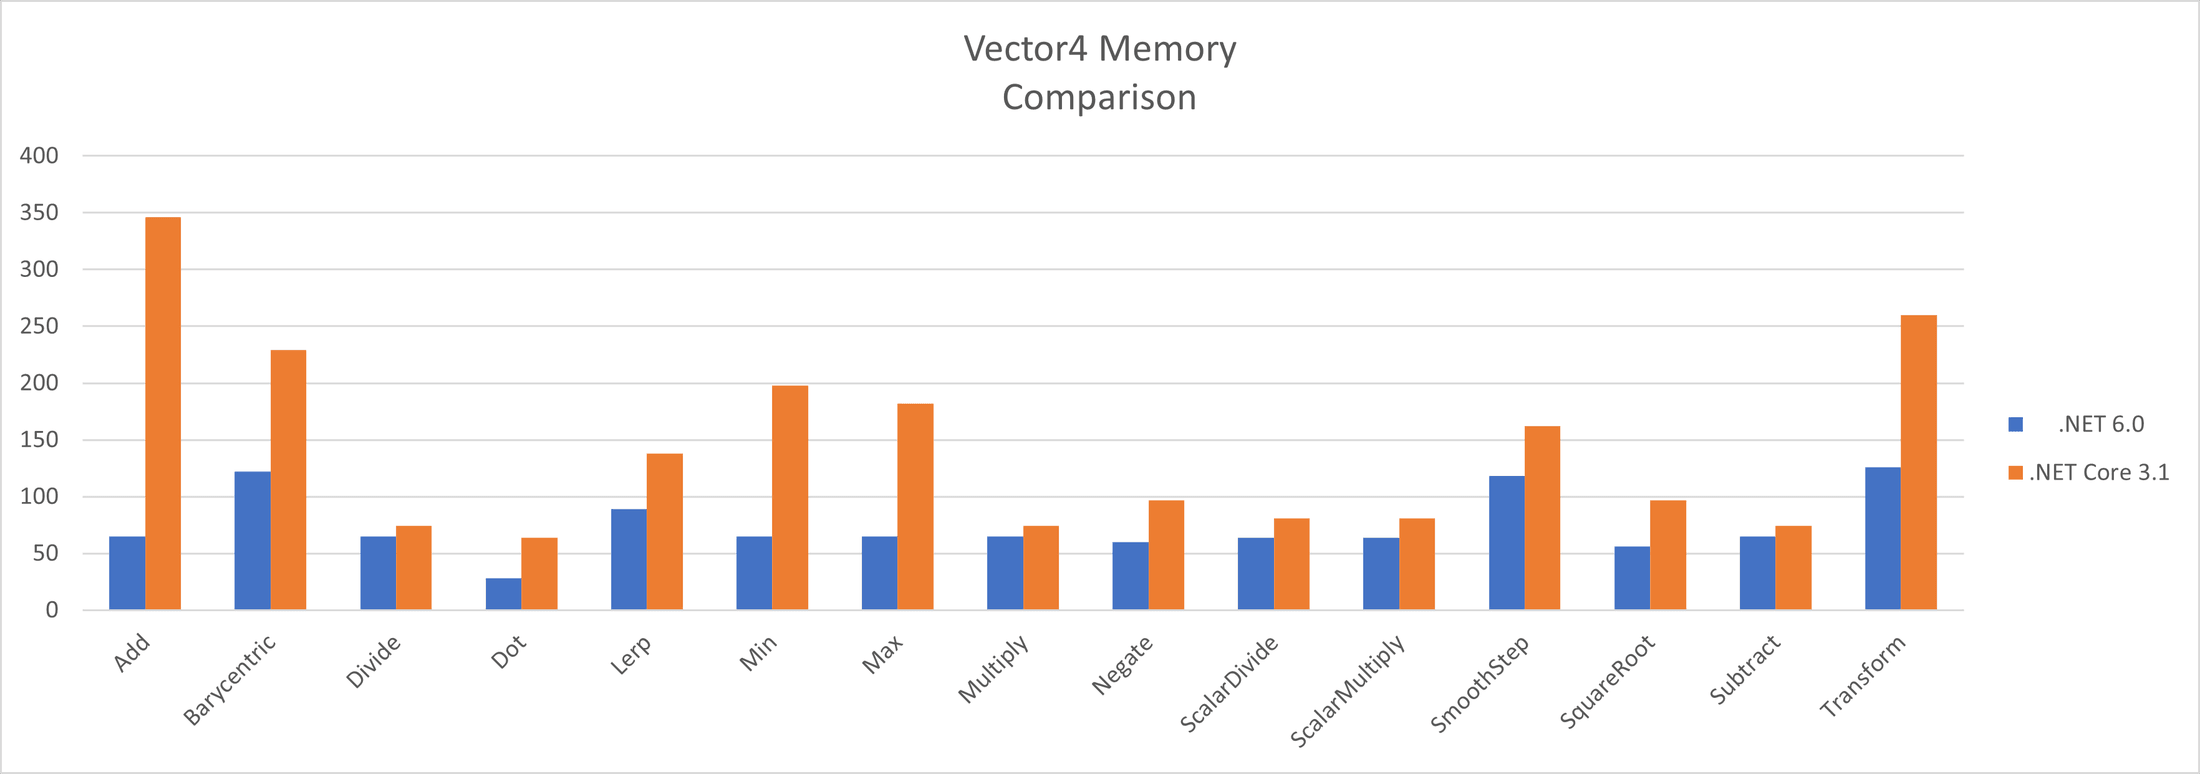
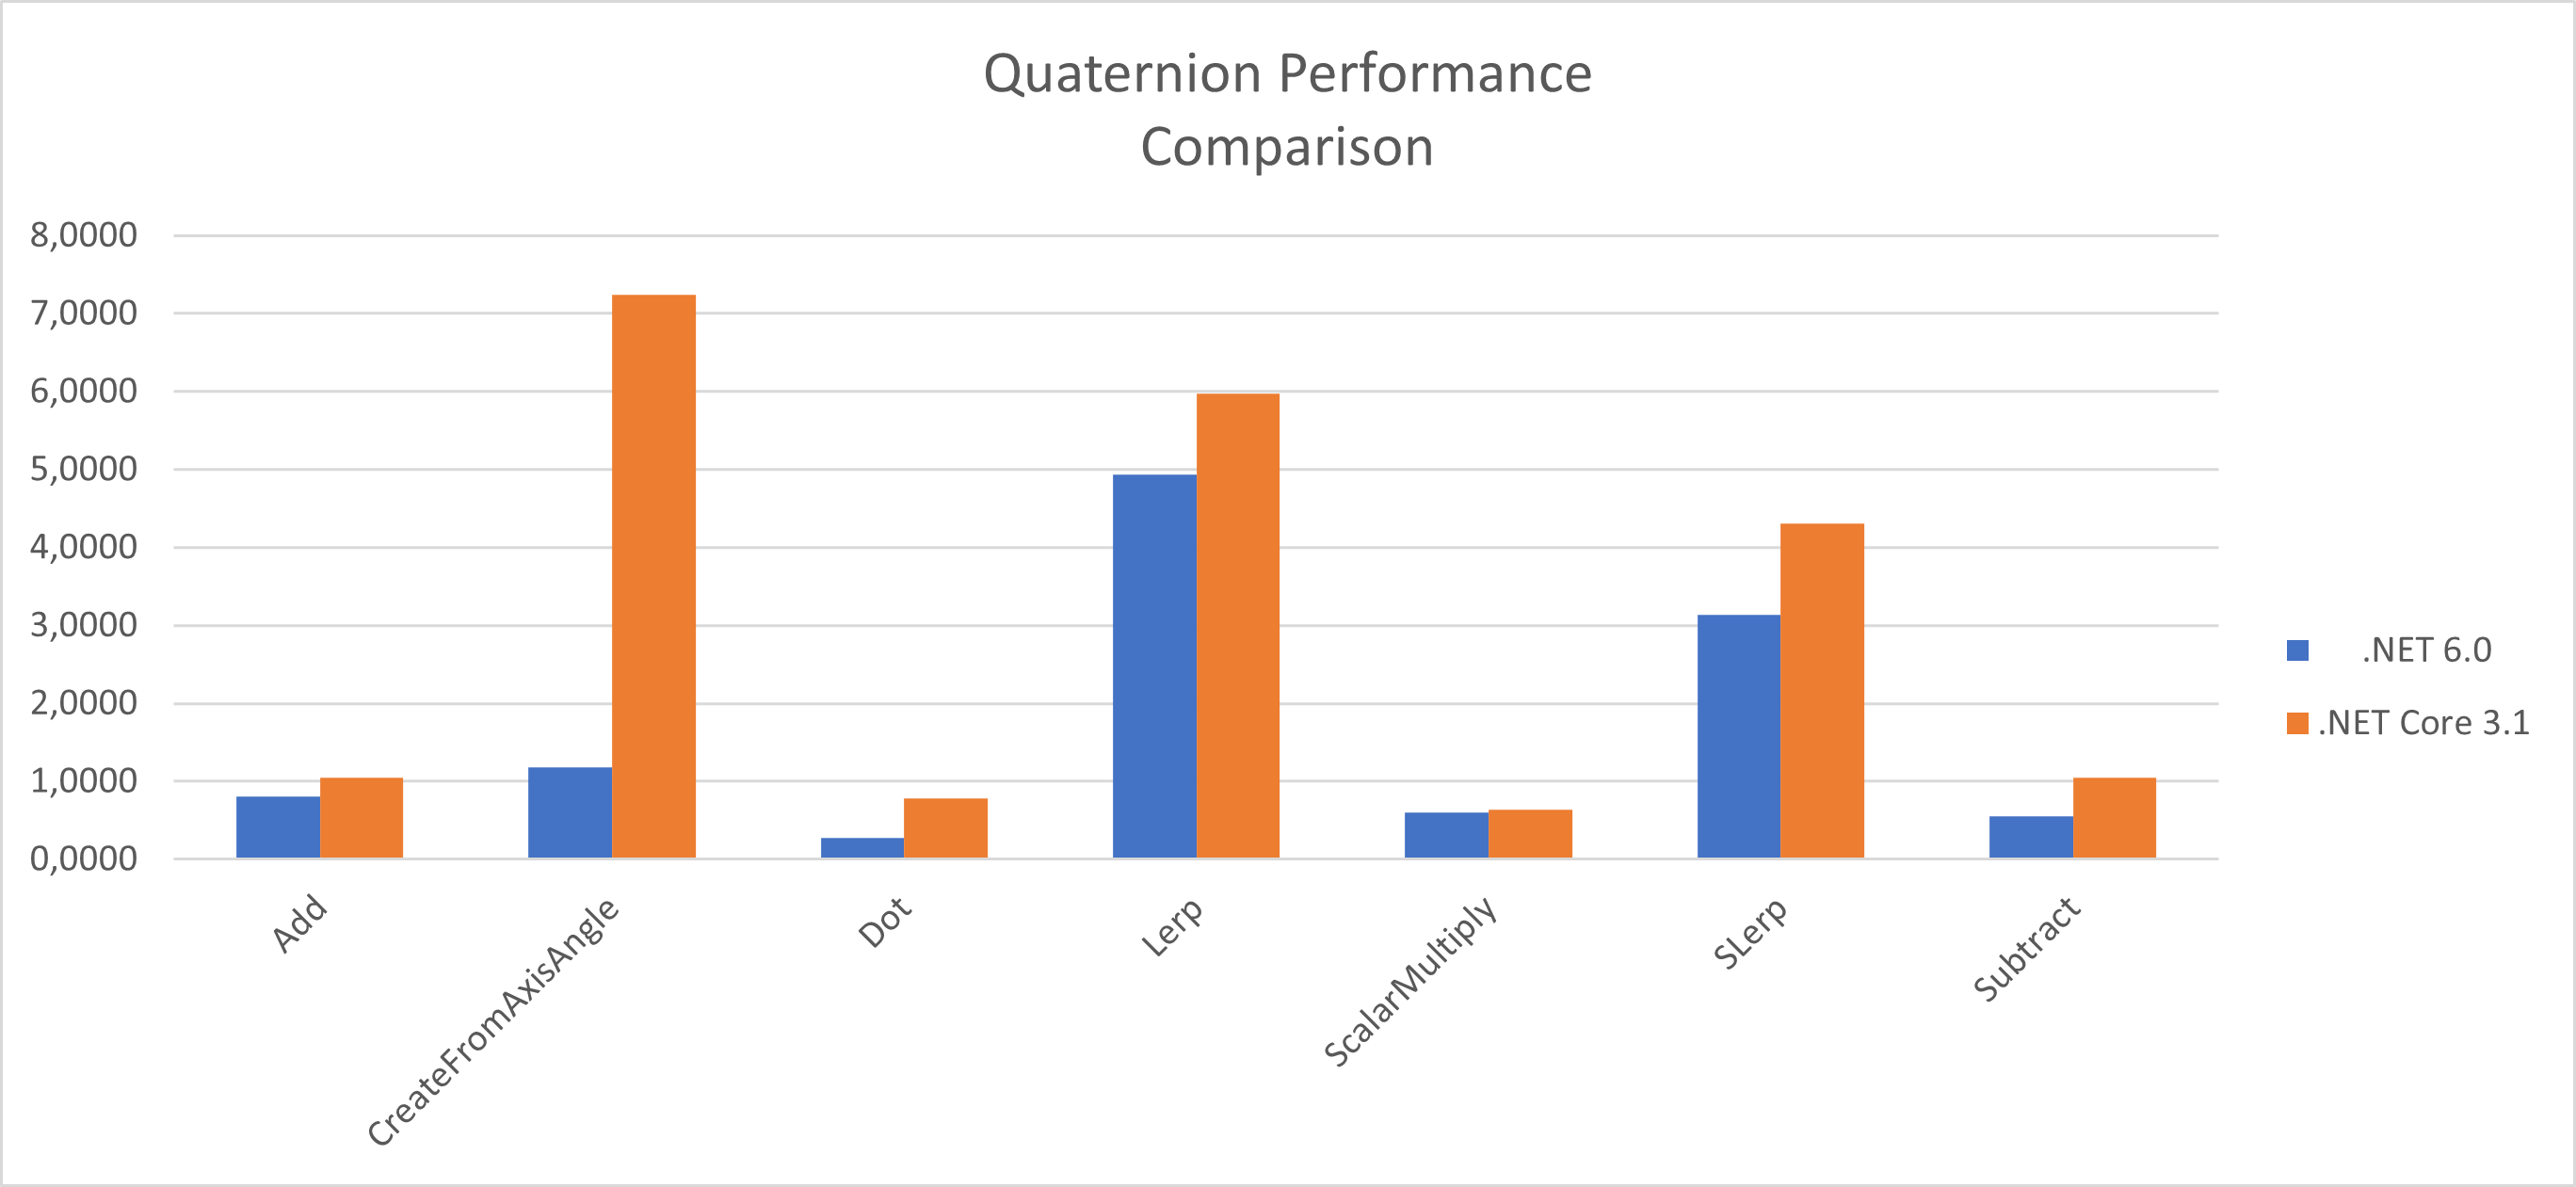
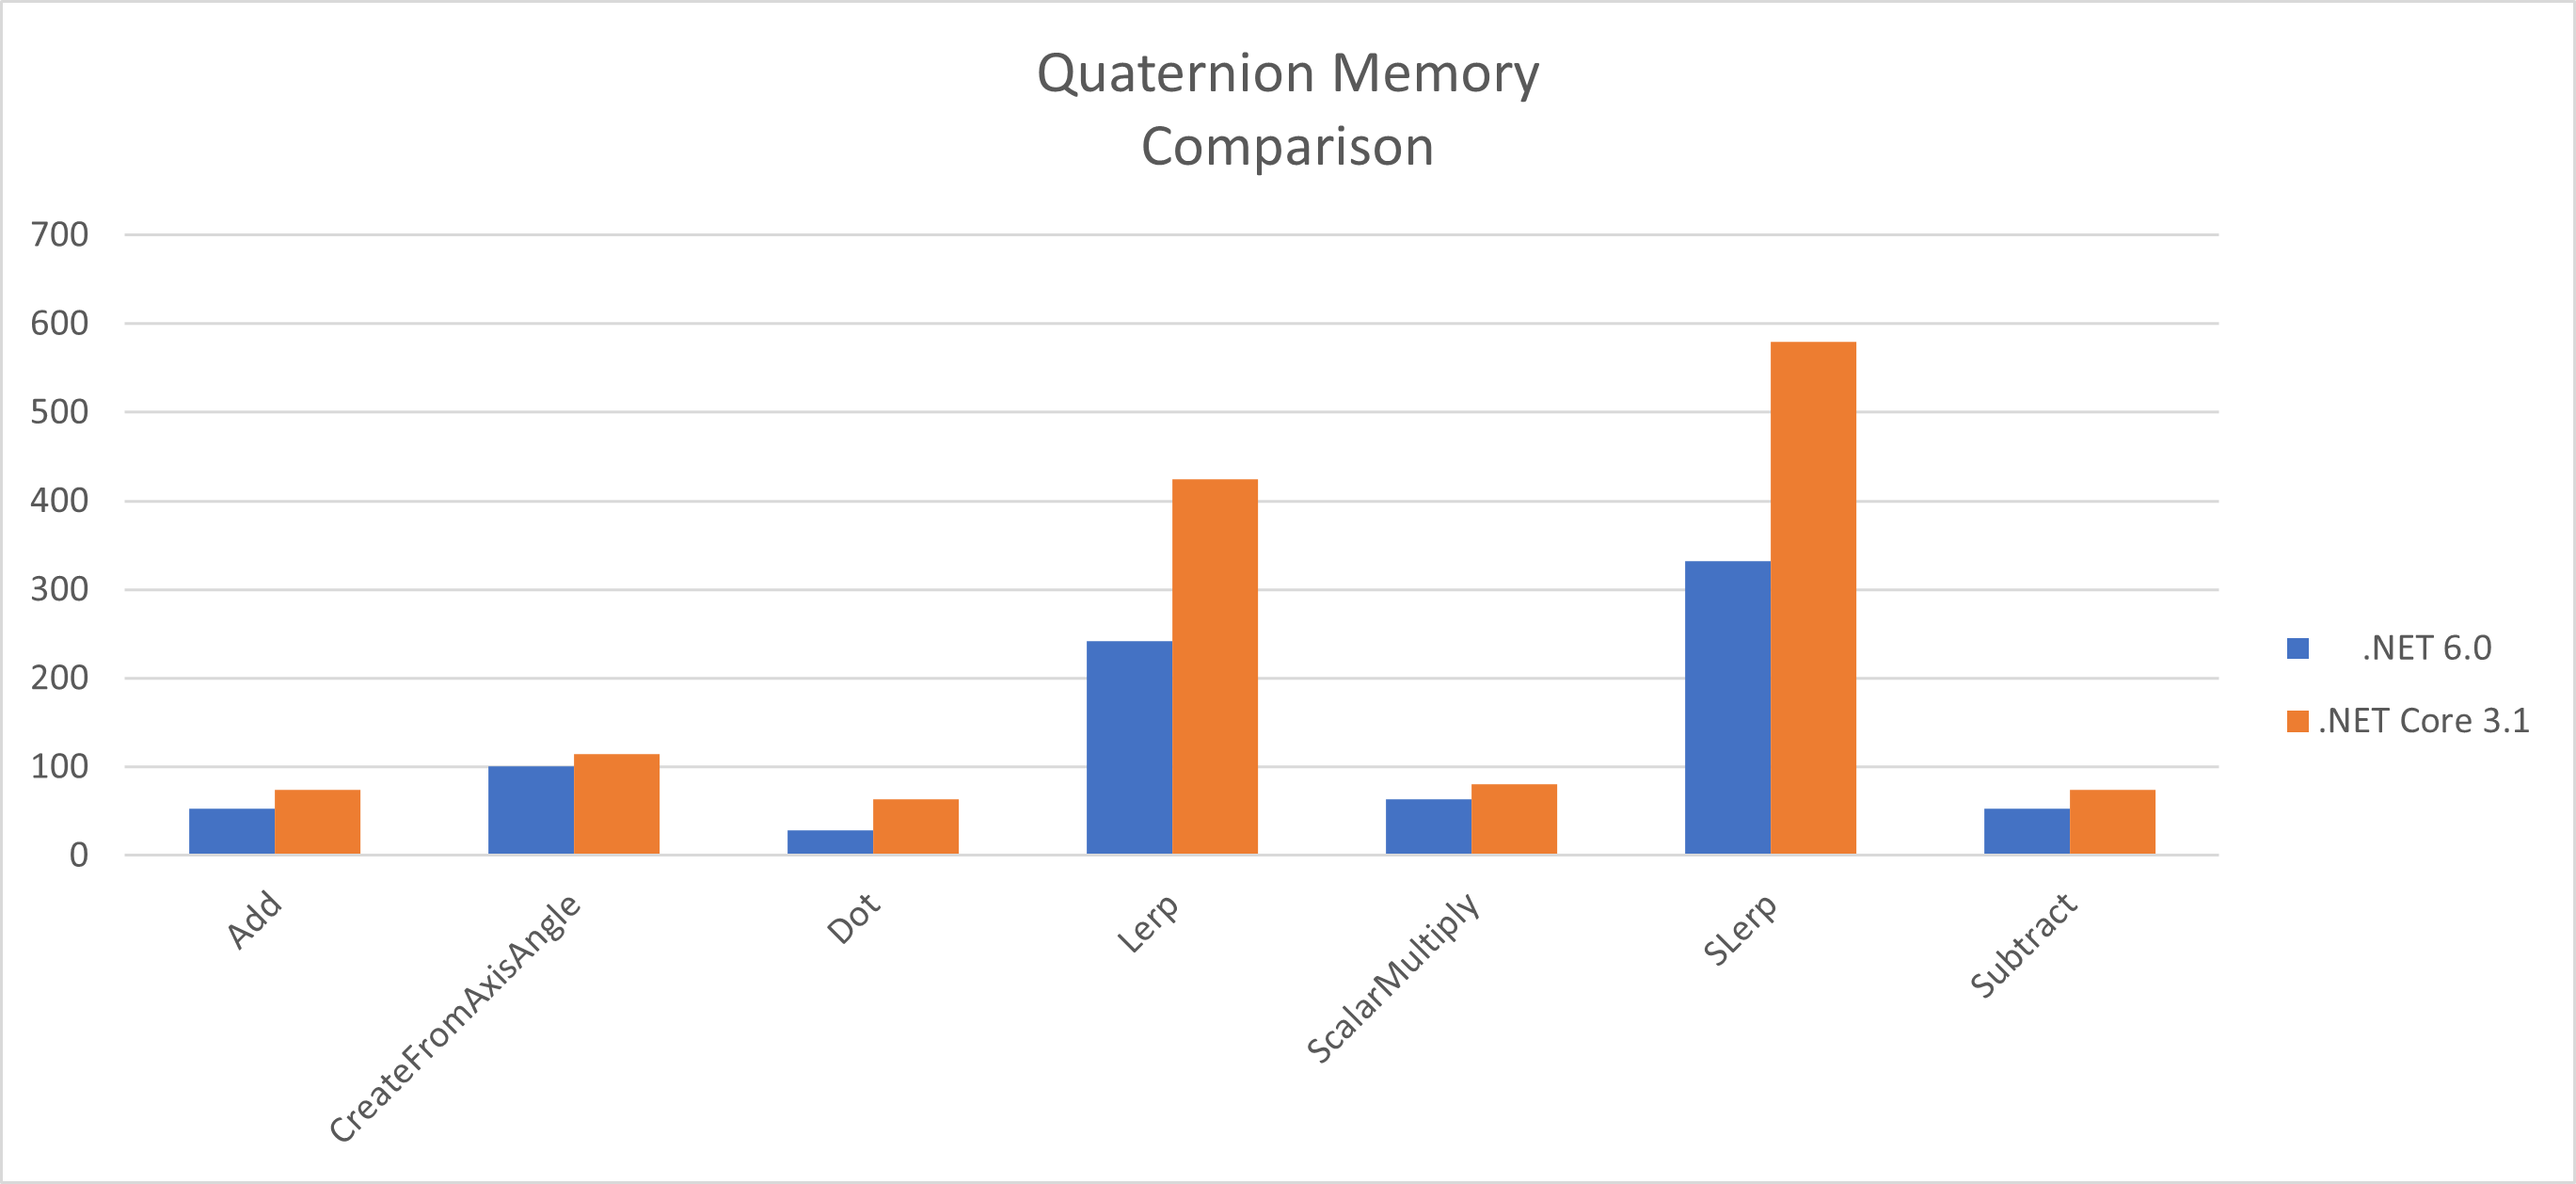
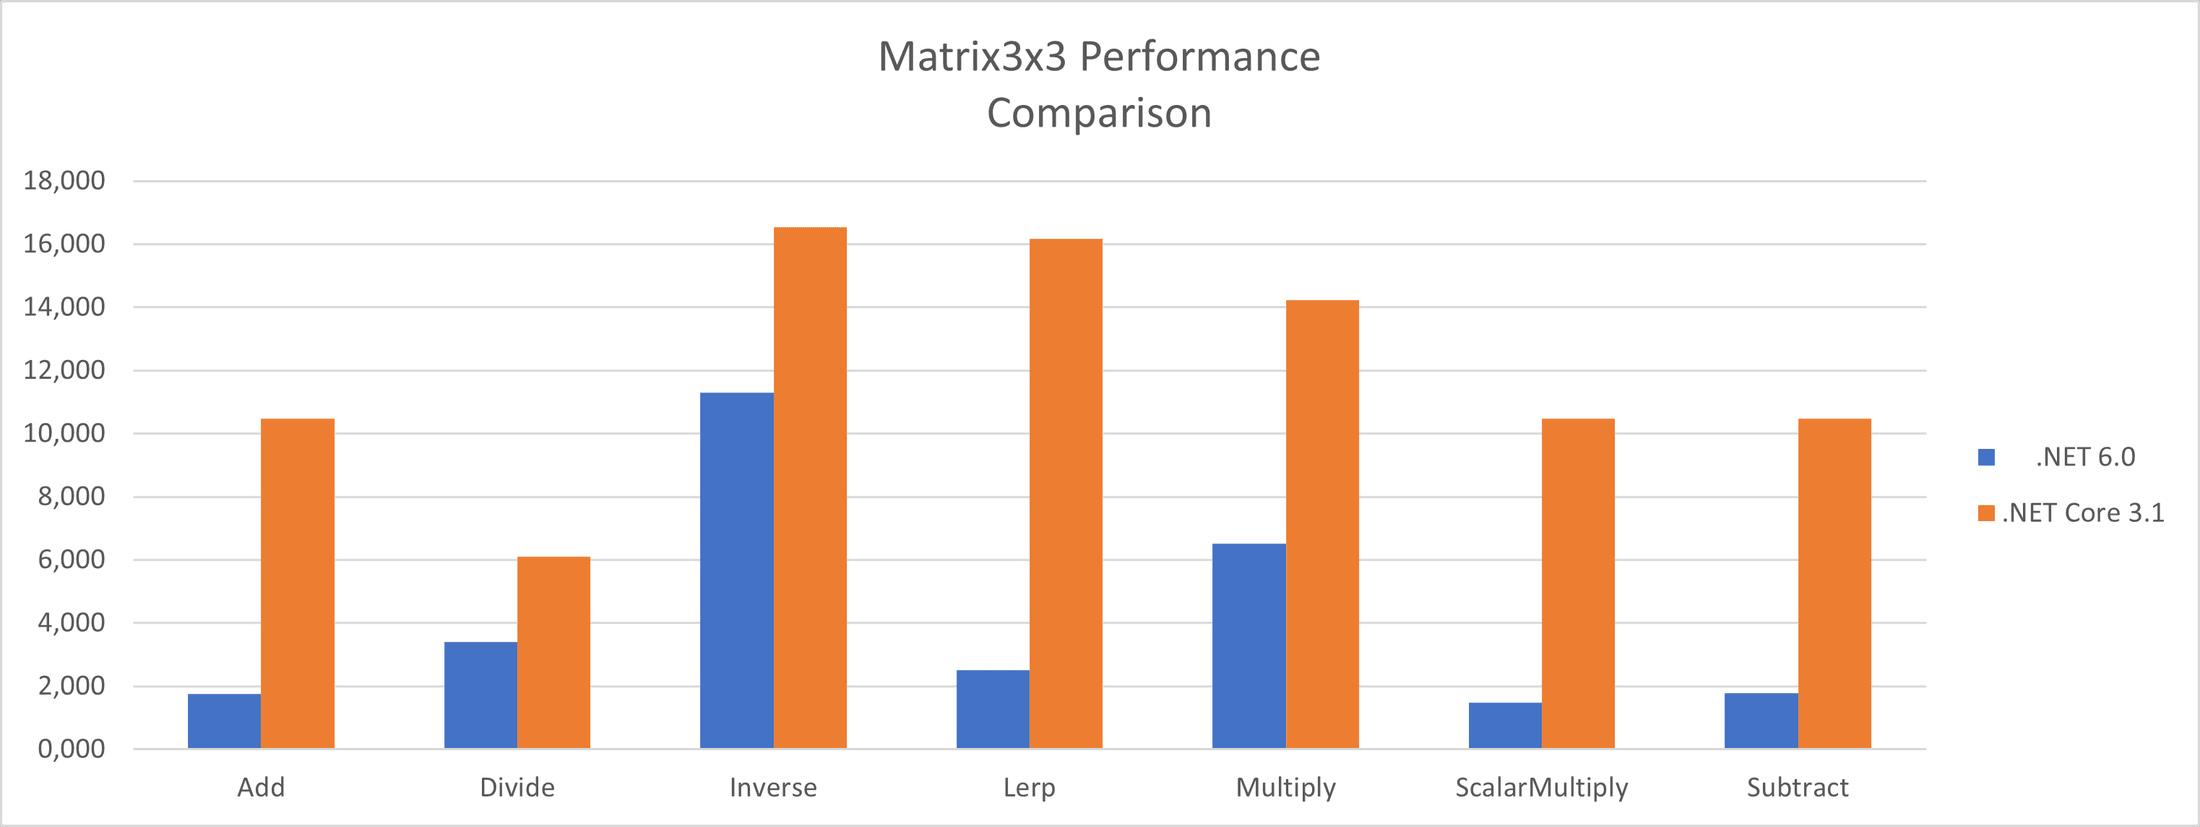
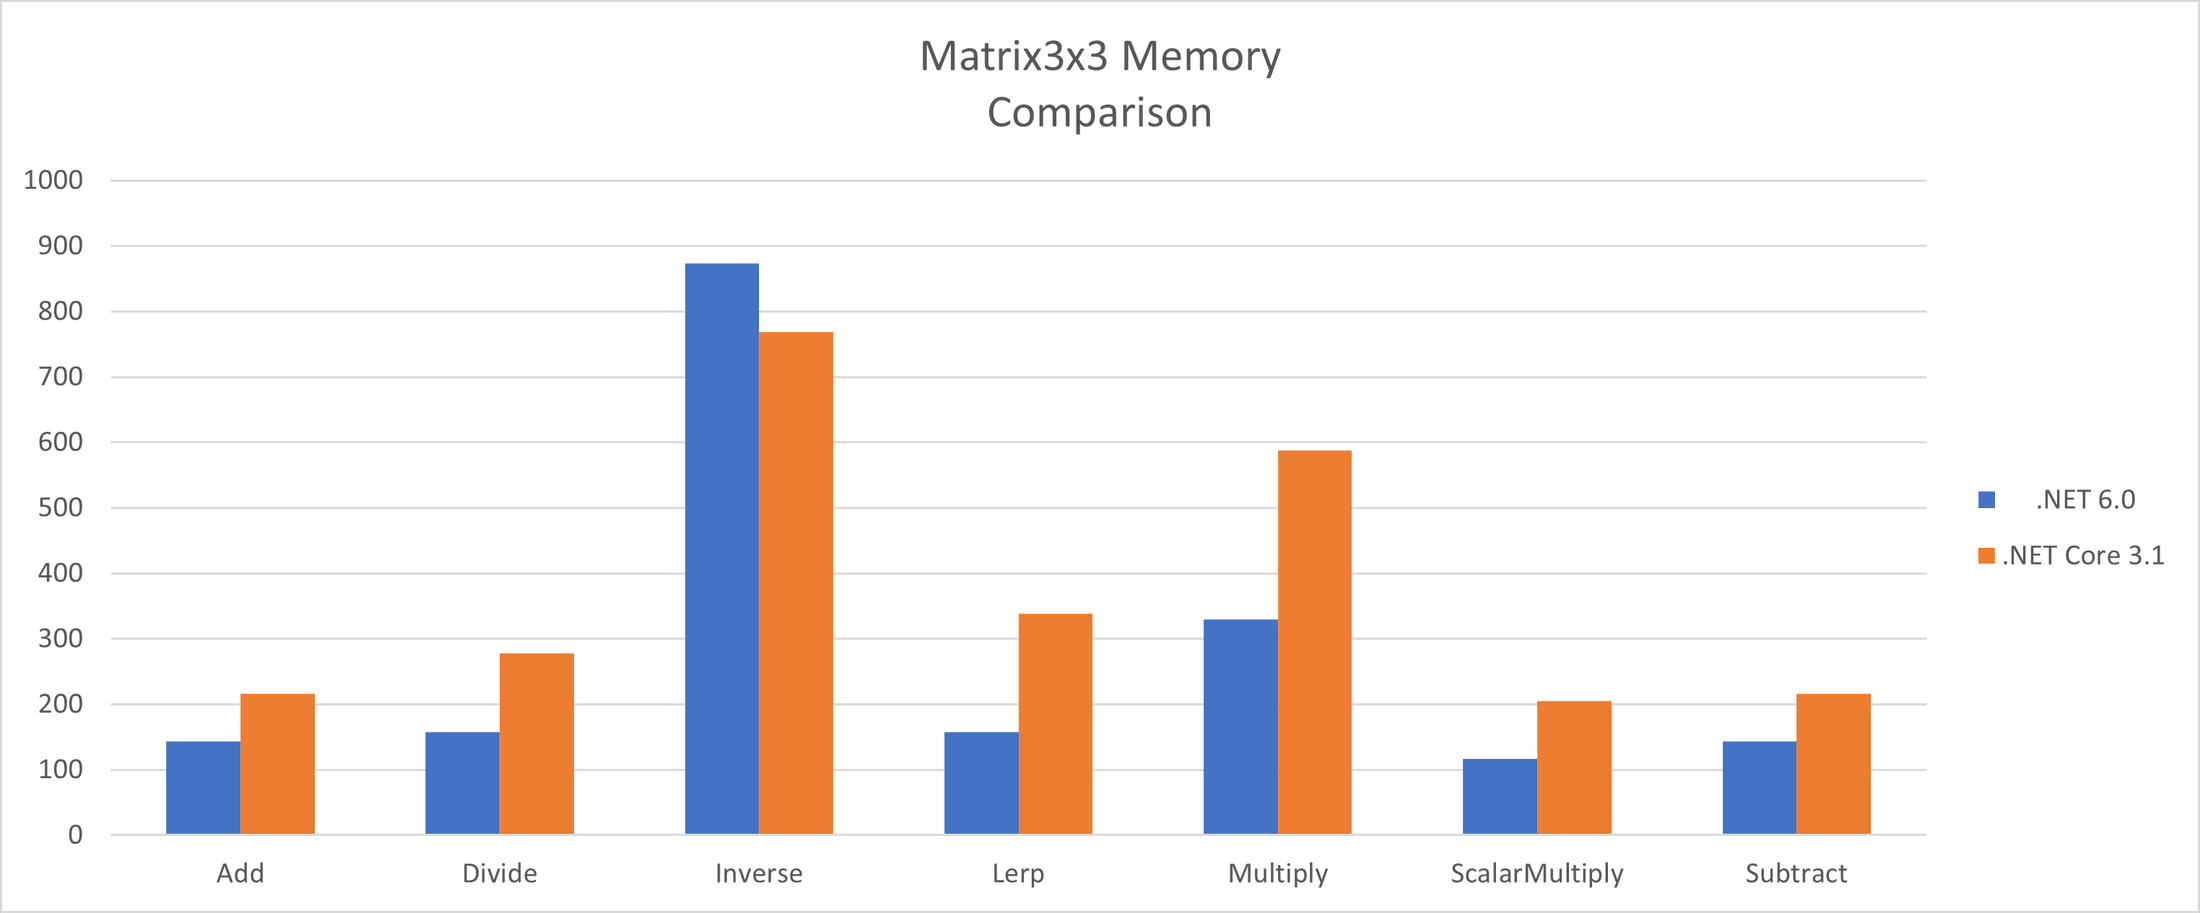
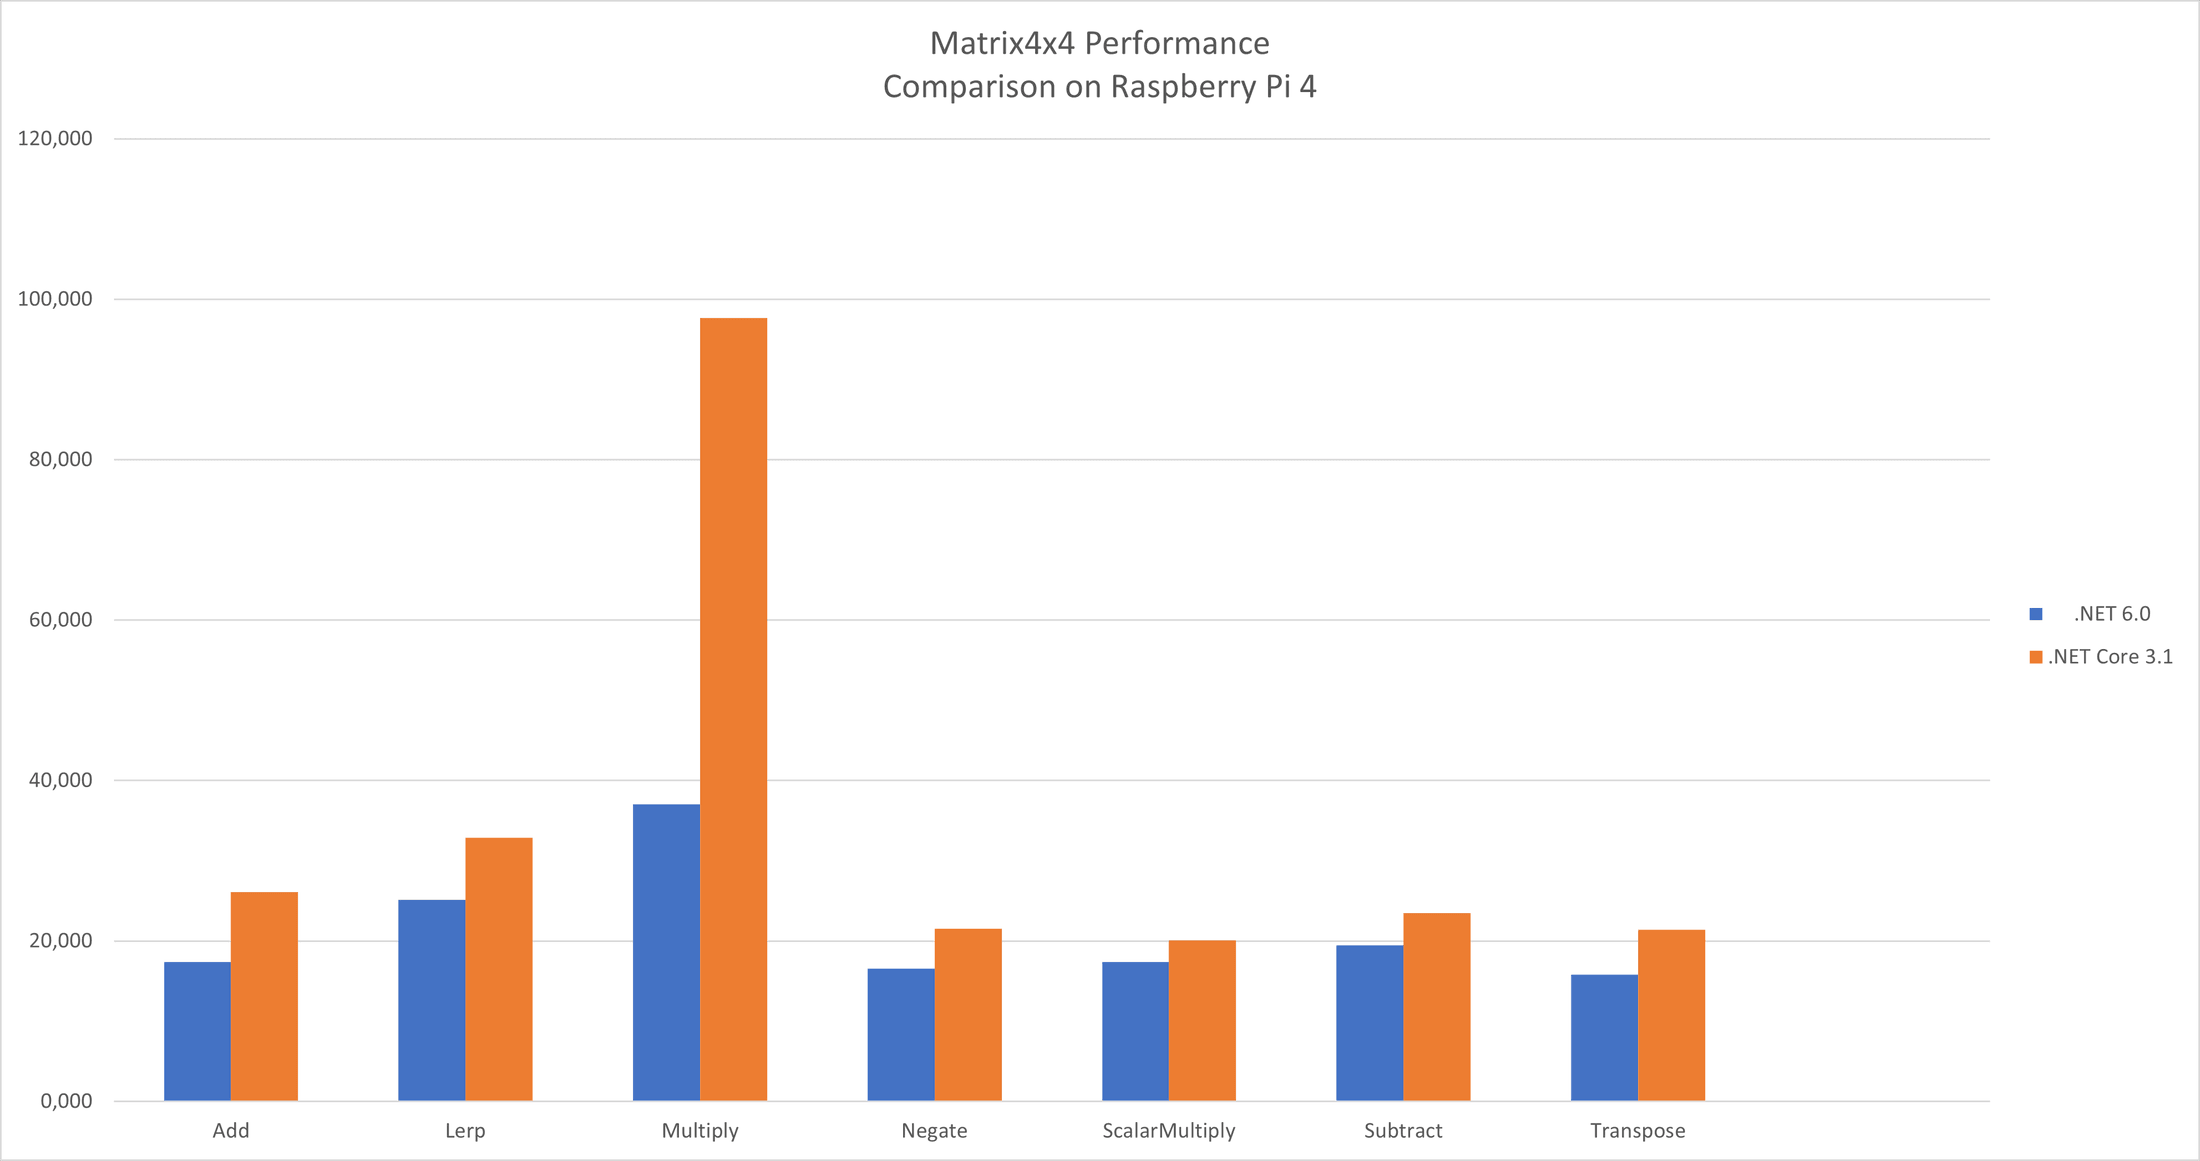
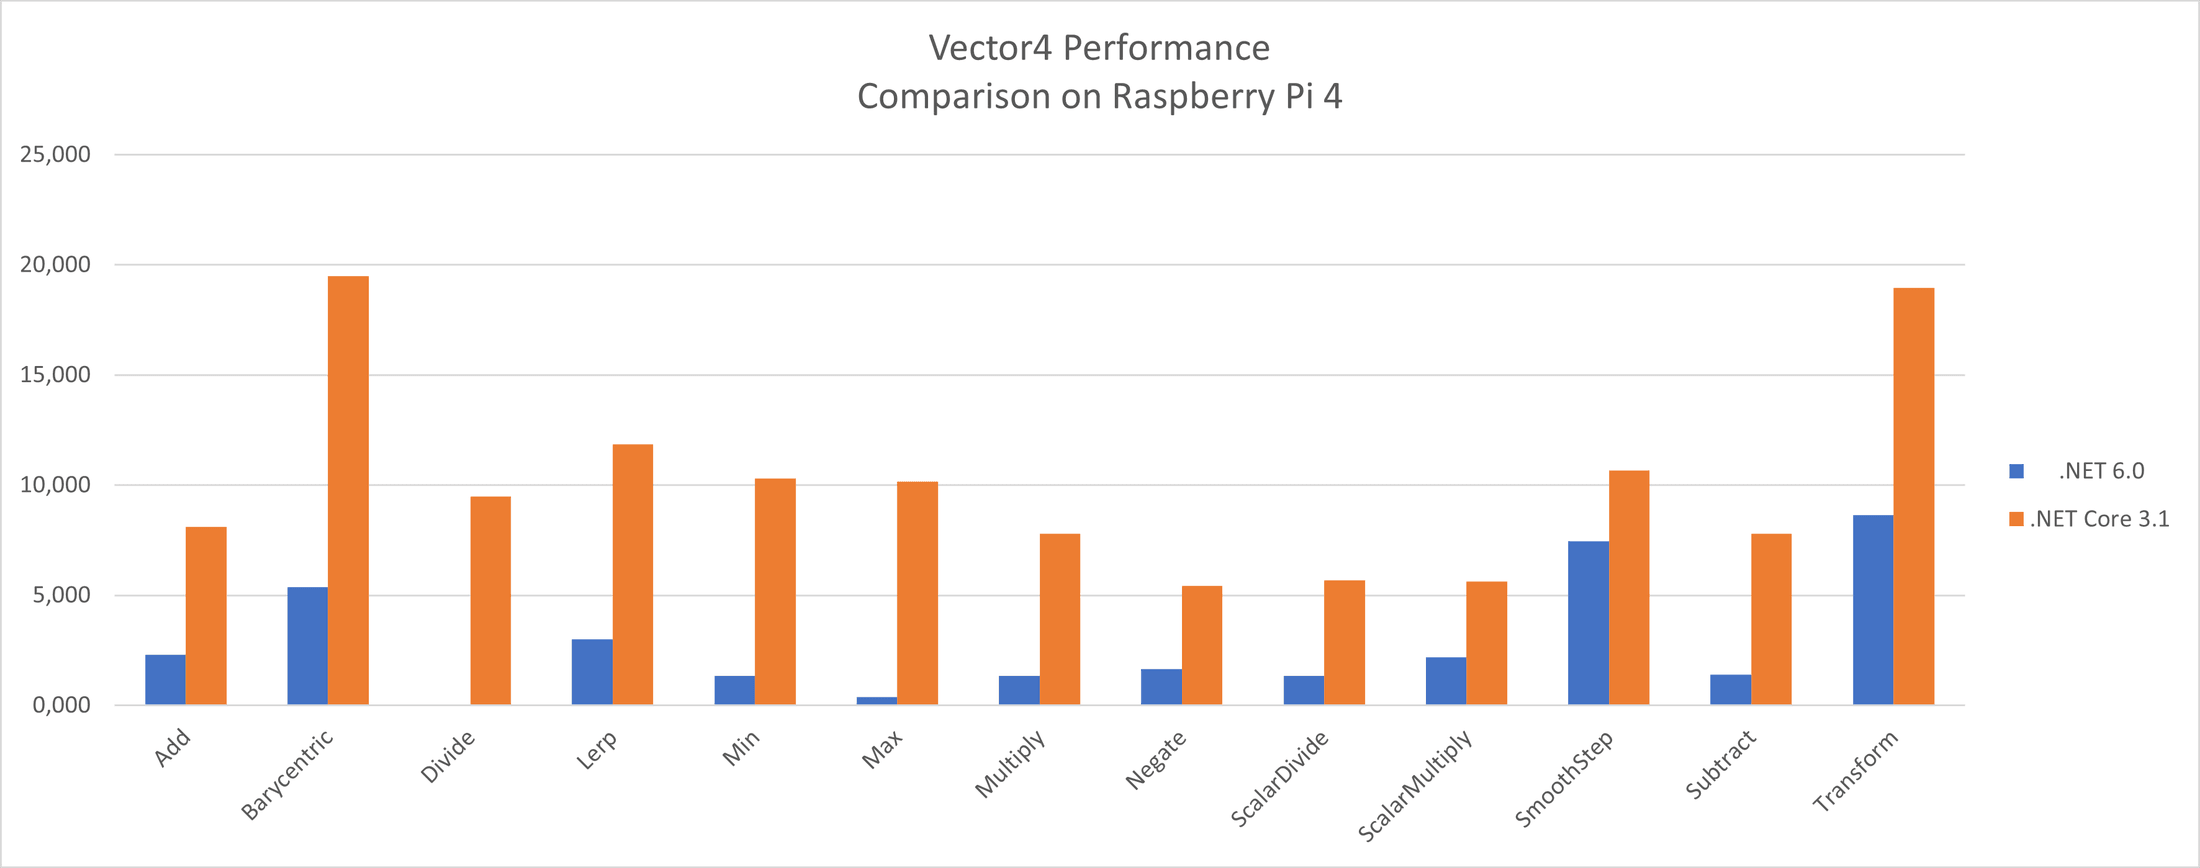
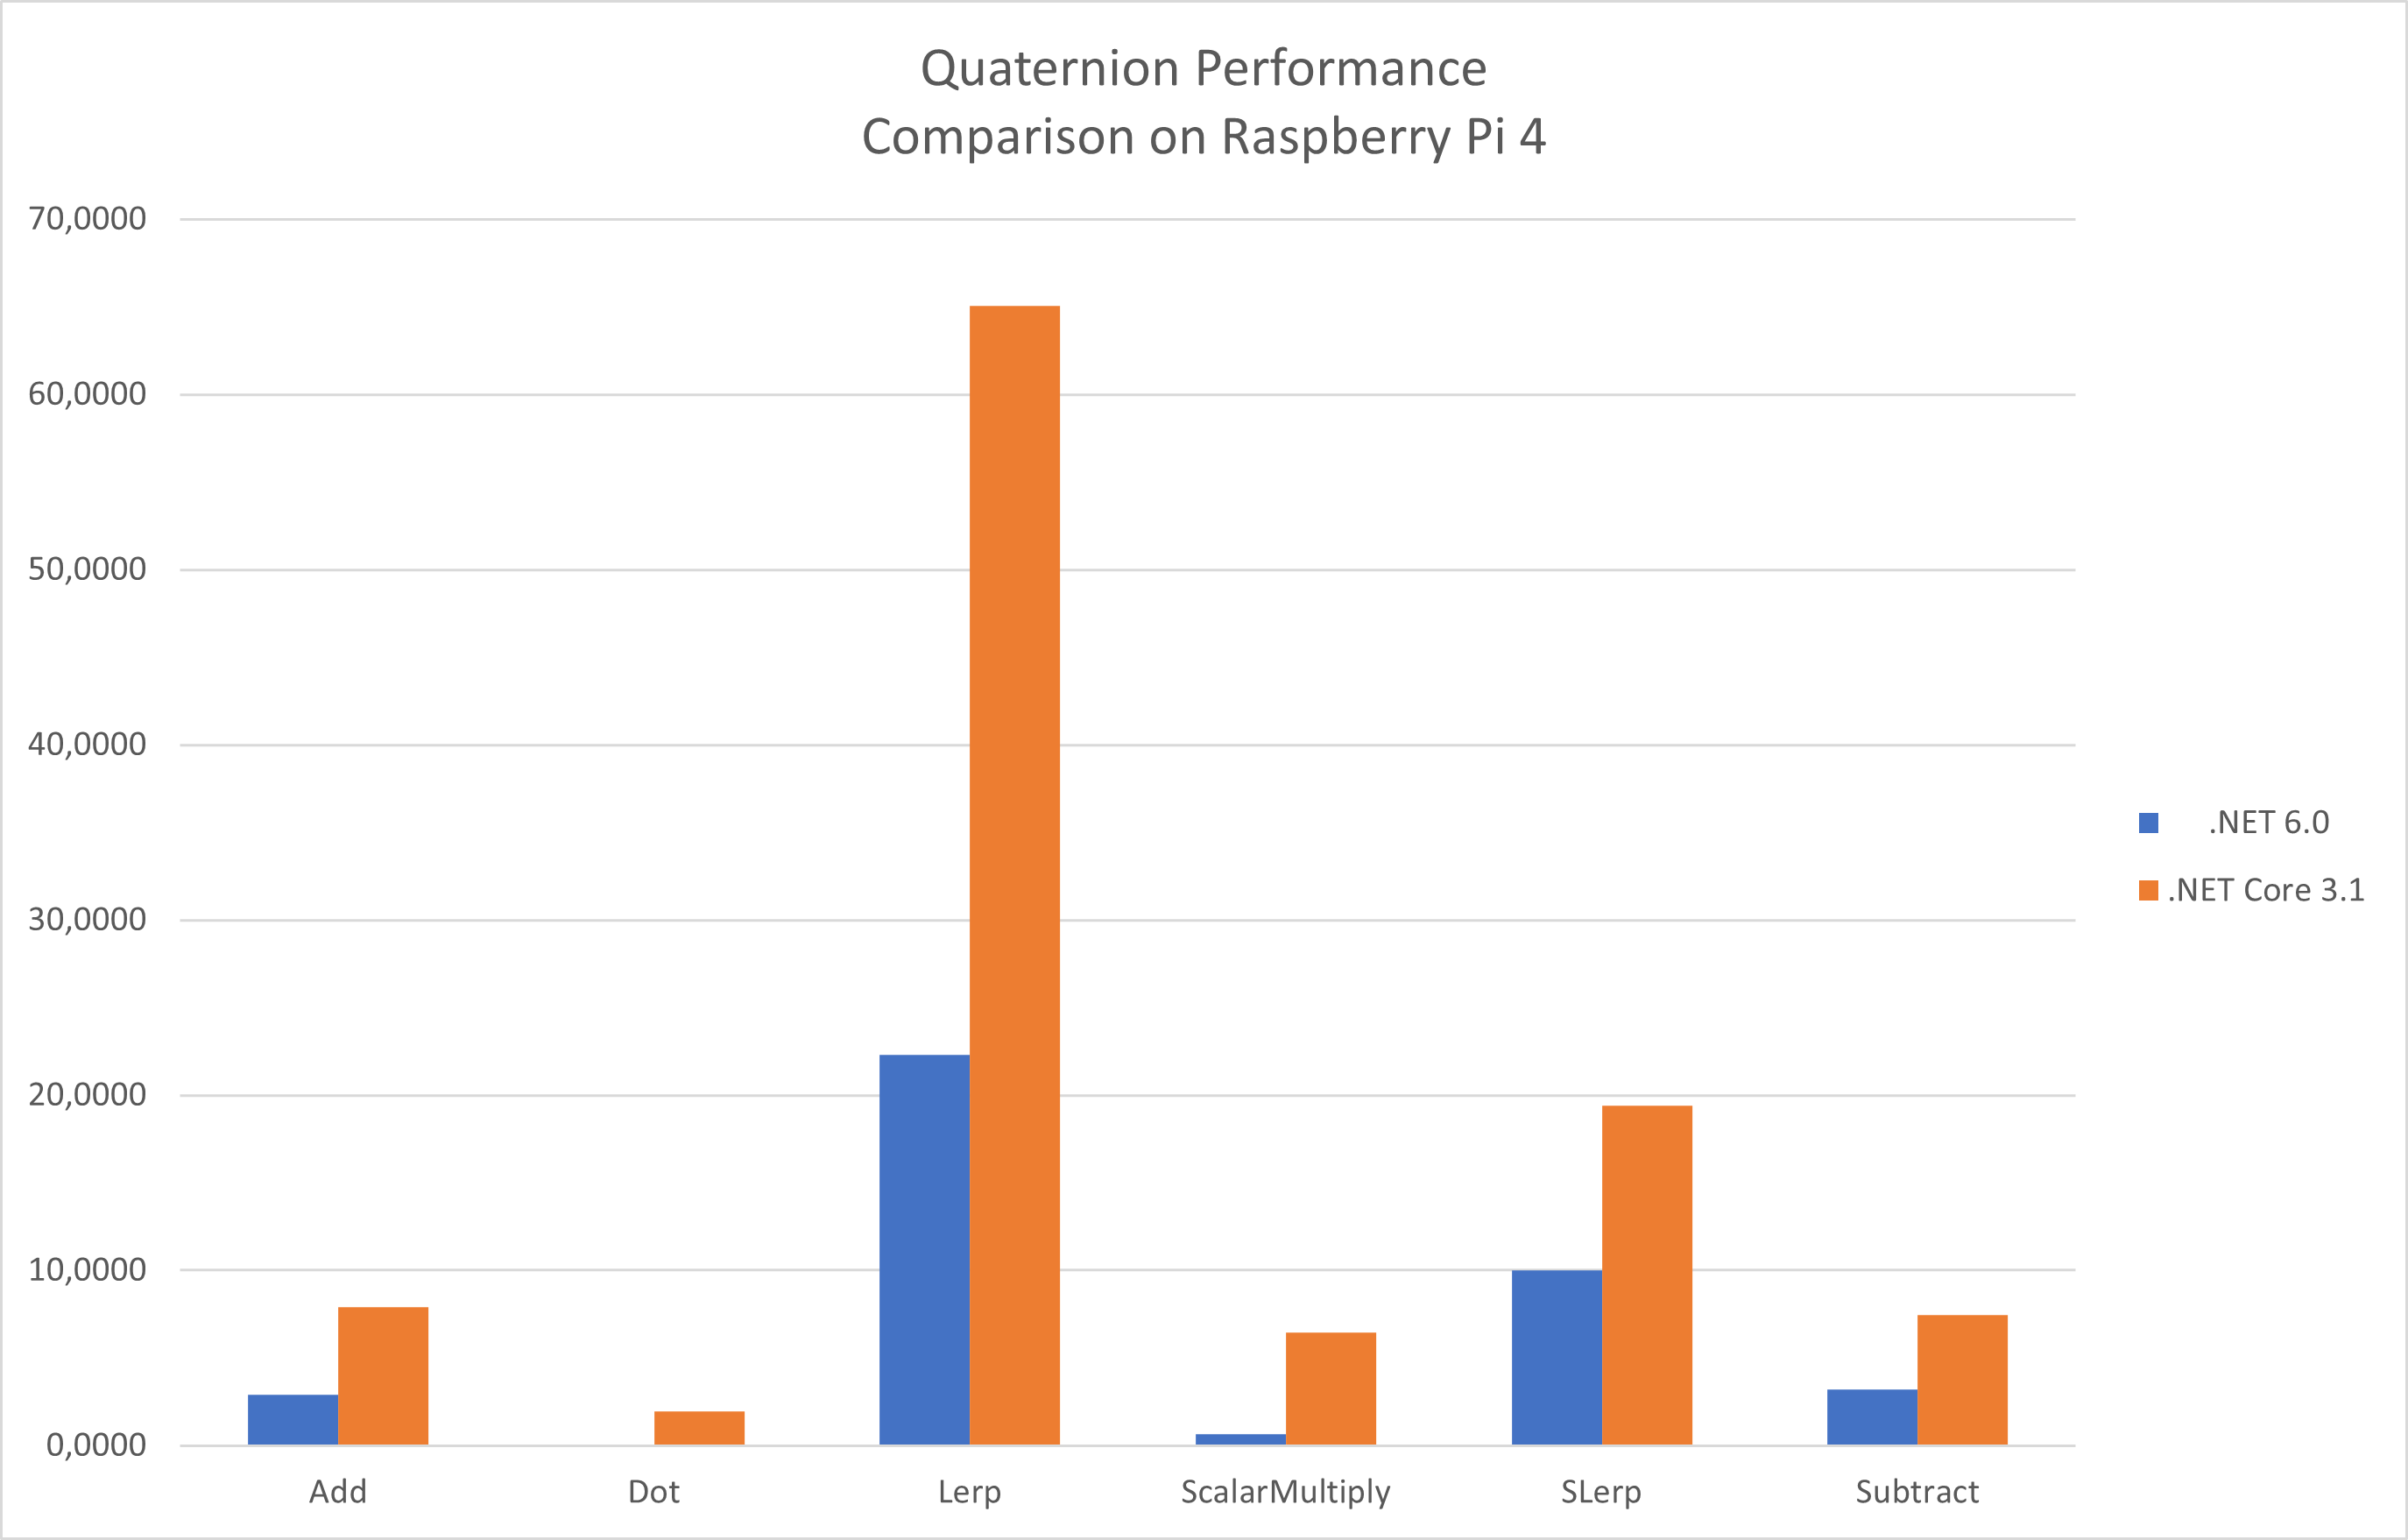
Nous avons également développé un nouveau chemin pour l'architecture ARM64 . Pour évaluer ce nouveau chemin, nous avons utilisé un Raspberry Pi4. Sur cette architecture, nous utilisons le jeu d'instructions ARM AdvSimd lorsque c'est possible. Voici les résultats obtenus sous Ubuntu 22.04.1 LTS sur Rasberry Pi4.
Résumé
La nouvelle bibliothèque Evergine.Mathematics est très rapide et vous permet de tirer parti des fonctionnalités propres à la plateforme de la machine sur laquelle vous l'exécutez. Elle est de 3 à 4 fois plus rapide qu'auparavant grâce à l'utilisation des instructions SSE et AVX sur les architectures x86 et x64, et AdvSimd sur les appareils ARM64.
À vous de jouer : téléchargez la nouvelle release pour profiter de ces améliorations de performances dans tous vos projets grâce à la nouvelle bibliothèque Evergine.Mathematics.